感知初现
你以为训练集上100%准确就是好模型——但它让模型在测试集上崩溃。记住的不是模式,是数据本身。
模式之门
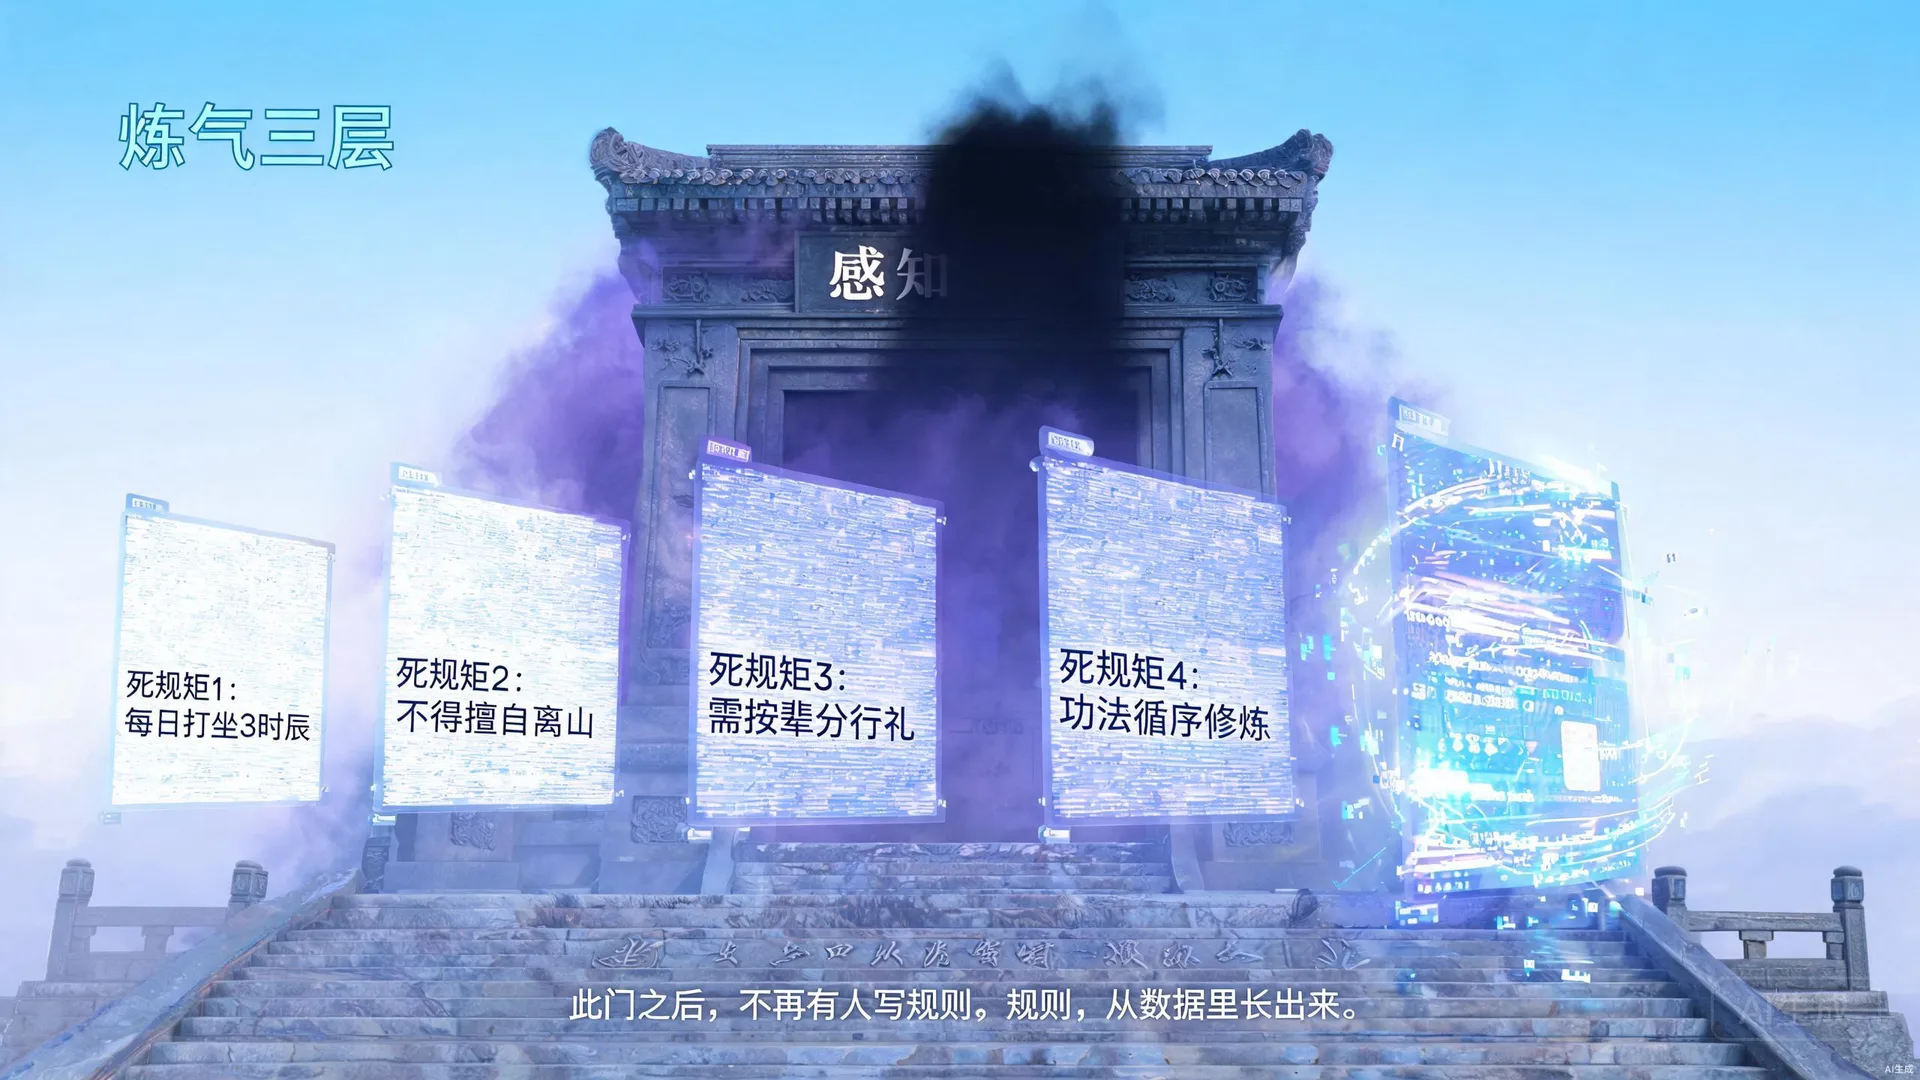
模式之门前的雾是紫色的,比别处更暗。门楣上"感知"二字被影子咬掉了一半。石阶上飘着五面光屏——每一面都在吞吐数据,像活的。门楣底座刻着一行小字:此门之后,不再有人写规则。规则,从数据里长出来。
 高斯老祖
「这是机器学习——让程序从经验E中,针对任务T,用度量P衡量,性能随E提升。这五面屏,哪一面是死规矩写死的?猜错一笔,影记一笔。」
 过拟合之影
「打个赌吧。这五面屏里,总有一面是死规矩写死的——猜猜,是哪面?猜错一笔,我记一笔。账记满了,到 S9 一起算。」
机器学习依赖预测挑战器
反直觉下注(五选一)→ 每点一次露出真实模型架构 → 机器学习文明图谱拼合
机器学习文明图谱
时间轴暗流 · ML 发展简史
详解 · K03-01 机器学习的定义与核心思想
Tom Mitchell(1997)的经典定义:对于某类任务 T 和性能度量 P,若计算机程序在 T 上的性能(以 P 衡量)随经验 E 而提升,则称它从 E 中学习。这与符号主义"人写规则"的路线相对——1980 年代专家系统(如 MYCIN,约 600 条 IF-THEN 规则)撞上"知识获取瓶颈":规则写不完、维护不动。机器学习把"规则的生成"本身自动化:人不写规则,只给数据和度量,规则从数据里长出来。五面屏对应五条技术路线:垃圾邮件=朴素贝叶斯、推荐=协同过滤、人脸=CNN、AlphaGo=MCTS+策略/价值网络、自动驾驶=多模态端到端。
详解 · K03-16 机器学习发展简史
1950 图灵测试提出问题;1957 Rosenblatt 感知机点燃第一次热潮,1969 年 Minsky 证明其连 XOR 都学不了,第一次寒冬;1980 年代专家系统盛行、1986 年反向传播(Rumelhart-Hinton-Williams)复兴神经网络;1990 年代 Vapnik 的 SVM 与统计学习理论主导;2006 年 Hinton 深度信念网破冰,2012 年 AlexNet 把 ImageNet 错误率从 26% 打到 15%,深度学习时代开启;2016 AlphaGo、2017 Transformer、2022 后大模型。两起两落的规律:每次复苏都靠数据、算力、算法三者同时齐备。
训灵坛 · 百分百的诱惑
光径尽头是一座悬空石坛,坛上摆着一摞带标签的数据石片——左边标着"猫/狗",右边标着房价数字。贝叶斯先师站在坛边,过拟合之影在你耳边轻笑。
高斯老祖
「左边标签离散——分类。右边标签连续——回归。两者都需要带标签的数据,这叫监督学习。挑一摞,训一个模型出来。」
过拟合之影
「训练集嘛,往死里贴就对了。贴到100%,你就毕业了。100%,多完美。」
训灵坛 · 范式抉择 + 复杂度滑块 + 本命灵模成型
选分类/回归 → 拖复杂度滑块 → 训练集准确率爬到100% → 本命灵模成型
详解 · K03-02 监督学习:分类与回归的基本范式
监督学习给定带标签样本 {(xᵢ, yᵢ)},学习映射 f: x→y。y 离散即分类(猫/狗、垃圾邮件判定),y 连续即回归(房价、气温)。常见算法:线性/逻辑回归、决策树、SVM、KNN、神经网络。本章复杂度滑块的 acc=min(100, 40+deg×6) 演示了一个关键事实:训练准确率随复杂度单调上升——n 个样本点总能被 n-1 次多项式精确穿过。但"训练集上贴得多紧"从不回答"没见过的数据上表现如何",后者才是学习的目的。
万象阁 · 特征与暗流
阁里悬着两面碑:一面刻"特征工程",一面刻"无监督"。过拟合之影递来一筐特征石——多加点,特征越多,它记得越牢,分数越高。
高斯老祖
「特征工程是你替模型把数据看清楚的手艺——标准化、独热编码、构造新特征。无监督学习连标签都不给你,让模型自己找结构:聚类、降维、密度估计。」
过拟合之影
「多加点。特征越多,它记得越牢。记得越牢,分数越高。」
万象阁 · 特征工程三步 + 无监督三范式暗室
标准化→独热→多项式 → 本命灵模紫光增强 → 无监督三范式各亮一灯
特征工程台
无监督暗室 · 三范式
详解 · K03-13 特征工程:特征选择/提取/构造
业界共识:"数据和特征决定了机器学习的上限,模型和算法只是逼近这个上限。"三招各有针对性——标准化 x'=(x-μ)/σ:统一量纲,让梯度下降不被大尺度特征牵着走;独热编码:类别变量转 0/1 向量,避免"红=1、绿=2、蓝=3"引入根本不存在的序关系;多项式构造 x→(x, x², x³…):升维引入非线性,但代价是维数爆炸——d 维特征的 p 次项数达 C(d+p, p),每一维都是模型"背数据"的新容量。传统 ML 时代特征工程占项目工作量的大头,深度学习的革命性正在于把特征学习也自动化。
详解 · K03-03 无监督学习:聚类/降维/密度估计
无监督学习没有标签,只让模型自己找结构。聚类 k-means:交替执行"把点指派给最近质心→把质心移到簇均值",单调收敛到局部最优,对初始化敏感(k-means++ 用距离加权采样改善);降维 PCA:对协方差矩阵做特征值分解,取方差最大的前 k 个正交方向投影,既压缩数据又降噪;密度估计:直方图、核密度估计、高斯混合模型 GMM(EM 算法迭代),回答"数据在空间里怎么分布",是异常检测的基础。典型应用:客户分群、图像压缩、欺诈检测。
试炼场 · 测试集的耳光
试炼场中央立着一座天平,左边写着"训练集",右边写着"测试集"——从未见过的新数据。你把本命灵模放上训练盘——指针稳稳压在100%。你得意地把它推向测试盘——指针猛地一沉,停在62%。
过拟合之影
「100%?那是它背下来的。新题一上来,原形毕露。」
高斯老祖
「100%不是完美,是它把训练集背下来了——这叫过拟合。点开诊断,看它到底错在哪。」
试炼场 · 训练/测试天平 + 混淆矩阵 + 四指标
拖模型切换训练/测试盘 → 100%→62%断崖 → 混淆矩阵样本归位 → 四指标实时计算
混淆矩阵 · 把测试样本归位
详解 · K03-11 混淆矩阵与分类报告
二分类的四种结局:TP(真阳)、FP(假阳,I 型错误/误报)、FN(假阴,II 型错误/漏报)、TN(真阴)。本章 10 个测试样本归位为 TP4/FP2/FN2/TN2。两类错误的代价因场景而异:医疗筛查宁可 FP(误报复查)不可 FN(漏诊致命);垃圾邮件过滤相反,宁可漏放垃圾邮件不可误杀正常邮件。sklearn 的 classification report 就是从混淆矩阵逐类展开精确率、召回率、F1,再加宏平均/加权平均——多分类评估的标准报表。
详解 · K03-09 评估指标:准确率/精确率/召回率/F1
以本章 TP4/FP2/FN2/TN2 实算:准确率=(TP+TN)/N=6/10=60%;精确率=TP/(TP+FP)=4/6≈67%("判为猫的有多少真是猫");召回率=TP/(TP+FN)=4/6≈67%("真猫抓回多少");F1=2PR/(P+R)≈67%——调和平均天然惩罚短板,P、R 有一个塌了 F1 就高不了。不平衡数据下准确率是谎言:1000 人中 10 个病人,"全部判健康"的模型准确率 99%、召回率却是 0。这正是 S8 要引入 ROC/AUC 的原因。
假设殿 · 没有免费的午餐
殿中央悬着一个巨大的函数空间球——里面密密麻麻全是曲线,每一条都是一个"假设"。球上刻着一句话:没有免费的午餐。
高斯老祖
「模型能表示的所有函数,组成它的假设空间。你的本命灵模假设空间太大——大到能把训练集每个点都穿过去,当然100%。没有免费午餐:平均而言,在所有可能的问题上,没有任何一个学习算法比另一个更好。要泛化,你必须先有假设——这叫归纳偏置。」
过拟合之影
「找个万能模型?不存在的。数学上不存在。」
假设殿 · 假设空间球 + NFL五模型对比 + 强化学习迷宫
拖复杂度看假设空间膨胀 → 五模型NFL对比 → 迷宫试错学策略
假设空间球 · 复杂度调节
没有免费午餐 · 五模型对比
强化学习迷宫 · 探索 vs 利用
详解 · K03-05 假设空间与归纳偏置:没有免费的午餐
假设空间 ℋ 是模型能表示的所有函数的集合:线性模型的 ℋ={wx+b},10 次多项式的 ℋ 大到能穿过任意 11 个点。归纳偏置是学习算法对"什么样的函数更可信"的先验偏好——奥卡姆剃刀式的"偏爱简单"就是最强的偏置之一。没有免费午餐定理(Wolpert, 1996):对所有可能问题均匀平均,任意两个学习算法的期望性能严格相等——不存在万能模型,只有在特定问题分布上更合适的偏置。脱离问题分布谈"哪个算法更强",在数学上没有意义。
详解 · K03-04 强化学习:环境/动作/奖励/策略
强化学习没有标签,只有奖励信号。五要素:智能体、环境、状态 s、动作 a、奖励 r;策略 π(a|s) 描述每个状态下怎么动。目标是最大化累计折扣回报 G=Σγᵗrₜ(γ∈[0,1) 权衡眼前与长远)。核心矛盾是探索 vs 利用:只利用会困在局部最优,只探索永远捡不到果子——ε-贪心策略以 ε 概率随机探索、1-ε 选当前最优,是最简单的平衡法。AlphaGo 的自我对弈、机器人控制、推荐系统在线调优都是 RL 的战场,Sutton & Barto《强化学习》是该领域圣经。
诊断台 · 偏差与方差的拉锯
诊断台上摆着一架天平,左盘刻"偏差Bias",右盘刻"方差Variance",中间悬着"不可约误差"。欠拟合之残在偏差盘的阴影里一闪而过,低语:另一种死法——连训练集都学不会。
高斯老祖
「任何模型的期望误差,都能拆成三份:偏差的平方、方差、和老天爷定的噪声。过拟合,是方差那盘太重;欠拟合,是偏差那盘太重。」
诊断台 · 学习曲线 + 偏差-方差五步推导 + 本命灵模验算
拖样本数看双线分叉 → 五步分解拖块 → 本命灵模旧伤复发换样重测
学习曲线 · 训练误差 vs 验证误差
偏差-方差分解 · 五步推导
本命灵模验算 · 旧伤复发
详解 · K03-06 偏差-方差分解:过拟合与欠拟合的本质
对回归问题,设 y=f(x)+ε(噪声 ε 均值 0、方差 σ²),则模型 ŷ 的期望泛化误差可严格分解为 E[(y-ŷ)²] = Bias²[ŷ] + Var[ŷ] + σ²。推导骨架:在期望内加减 E[ŷ] 展开,交叉项因 E[ŷ-E[ŷ]]=0 而消失。偏差是预测期望与真值的系统性偏离——模型太简单(欠拟合);方差是换一份训练集预测抖动的幅度——模型太敏感(过拟合);σ² 是数据本身的不可约噪声。复杂度↑则偏差↓方差↑,总误差呈 U 形,最优复杂度在谷底——这就是一切模型选择的理论原点。
详解 · K03-14 学习曲线与模型诊断
学习曲线以训练样本数为横轴、误差为纵轴,同时画出训练误差与验证误差两条线。两种典型病态一眼可辨:高偏差(欠拟合)——两线都高且贴合,此时加数据无用,要加特征、加复杂度;高方差(过拟合)——训练误差低、验证误差高、缝隙巨大,此时加数据、正则化、降复杂度有效。吴恩达称它为"最有用的一张诊断图":动手调模型之前先画曲线,能省下大量盲目的试错。
折折磨室 · 交叉验证的徒劳
磨室中央是一台巨大的切割机,能把数据石片切成K份。你切了5折,转完5圈,验证准确率稳定在60–64%。你松了口气。过拟合之影冷笑:稳了?它只是把同一个过拟合切成了5份,每份都一样烂。
高斯老祖
「K折交叉验证:把数据切成K份,每次留1份当验证、其余K-1份训练,转K圈取平均。它能让你的评估更稳——但它不改变模型本身。」
过拟合之影
「交叉验证是尺,不是药。你量出它病了,可你治了吗?」
折折磨室 · K-fold切割 + 留一法 + 分层对比 + CV前后对照
切K份转K圈 → 留一法计算量爆炸 → 分层vs普通对比 → CV前后都是62%
K-fold 切割旋转
分层采样对比 · 不平衡数据(猫90/狗10)
真相暴击 · CV前后对照
详解 · K03-08 交叉验证:K-fold/留一法/分层采样
K-fold:数据均分 K 份,轮流留 1 份验证、K-1 份训练,转 K 圈取平均±标准差——比单次划分更稳,常用 K=5 或 10。留一法(LOO):K=N 的极端情形,几乎无偏但要训练 N 次(一万样本就是一万次),且各折高度相关、方差反而大。分层 K-fold:每折保持原数据的类别比例——90/10 不平衡数据若用普通切分,某折可能完全没有少数类,评估直接失真。关键认知:CV 只是更可信的"尺",它让 62% 这个数字不再侥幸,但模型一分一毫都没变——评估与治疗是两回事。
正则之泉 · 惩罚的智慧
泉边立着两把锁:一把刻"L1",一把刻"L2"。过拟合之影第一次退了一步:惩罚我?你惩罚的是记忆。没有记忆,你算什么?
高斯老祖
「正则化就是在损失函数后面加一项惩罚。L1加的是|w|的和,会把不重要的权重直接压成0,顺带做特征选择;L2加的是w²的和,把权重都缩小、磨平,但不归零。调λ——惩罚的力度。太小锁不住,太大锁死。」
过拟合之影
「惩罚我?你惩罚的是记忆。没有记忆,你算什么?」
正则之泉 · L1/L2双锁 + λ滑块 + 记忆之痕消退
选L1/L2锁 → 拖λ滑块 → 权重归零/磨平 → 伤痕消退测试爬到88%
详解 · K03-07 正则化:L1/L2 的直觉与效果
在损失函数后加惩罚项:L = L_data + λ·Ω(w)。L2(岭回归 Ridge):Ω=Σwᵢ²,线性回归下有闭式解 w=(XᵀX+λI)⁻¹Xᵀy,权重整体趋小但不归零,几何上是球形约束;L1(Lasso):Ω=Σ|wᵢ|,菱形约束的尖角让最优解容易落在坐标轴上——部分 wᵢ 恰为 0,天然完成特征选择。λ 直接操控偏差-方差权衡:λ↑→方差↓偏差↑,本章 λ∈[30,60] 区间测试准确率从 62% 爬到 88%,λ>80 则滑向欠拟合。同族手段还有 Dropout、早停(early stopping)、数据增强——都是"逼模型简单"的不同锁法。
评估殿 · 完整的审判
评估殿立着两面审判碑:左面刻"分类",右面刻"回归"。过拟合之影在殿角低语:指标。又是指标。你量来量去,敢不敢把它真的扔进未知的世界?
高斯老祖
「准确率会骗你——样本不平衡时,全猜多数类都有90%。ROC曲线画的是不同阈值下真阳率对假阳率的权衡,AUC是曲线下面积,1.0完美、0.5等于瞎猜。回归用MSE/RMSE/MAE/R²,各管一摊。」
评估殿 · ROC阈值绘制 + AUC计算 + 回归四指标台
拖决策阈值画ROC → AUC实时跳动 → 切回归算MSE/RMSE/MAE/R²
详解 · K03-10 ROC 曲线与 AUC:分类器性能的全局评估
把决策阈值从 1.0 扫到 0,每个阈值算一对(FPR=FP/(FP+TN),TPR=TP/(TP+FN)),连线即 ROC 曲线。左上角 (0,1) 是完美分类器,对角线是瞎猜。AUC=曲线下面积,有个漂亮的概率解释:随机取一对正负样本,正样本得分更高的概率(即 Mann-Whitney U 统计量)。本场景梯形法实算 AUC=0.91(90 胜 + 2 平局)。经验刻度:AUC>0.9 优秀,0.7~0.9 可用,0.5 等于抛硬币。AUC 对类别不平衡稳健——正负比例变化不改变曲线形状,这是它胜过准确率的关键。
详解 · K03-12 回归评估:MSE/RMSE/MAE/R²
四个指标各管一摊:MSE=平均(误差²),平方放大大误差,优化时梯度友好;RMSE=√MSE,回到与 y 相同的量纲,便于解释;MAE=平均|误差|,对异常值稳健(房价数据里一套豪宅不会带歪它);R²=1-SS_res/SS_tot,表示模型解释的方差比例——R²=1 完美,R²=0 意味着"不比直接猜均值强",甚至可以取负(比猜均值还烂)。本场景实算 MSE=0.0011、RMSE=0.033、MAE=0.03、R²=0.98。注意 R² 不是准确率,高 R² 不保证样本外可预测。
Boss 战 · 过拟合之影
殿门砰然合拢。紫色浓影从四面八方涌来,在空中凝成一张脸——和你本命灵模的轮廓一模一样,只是布满记忆之痕。过拟合之影:我不住在你的错误里——错误救不了我。我住在你"训练集上100%准确就是好模型"的幻觉里。
过拟合之影
「三问。答得清,我散;答不清,你留在100%的幻觉里,永远。我在每一处都欠了我的账——现在,一笔笔还。」
拟合债累计 0 笔 · 三问全对后清零
尾声 · 流水之门
影散尽时数据光径重新亮起,你手里的本命灵模微微发紫——记忆之痕还在,像一枚没说出口的印章。高斯老祖手一挥,全章的环节自动连成一条流水线。
高斯老祖
「你入门了。不是因为你答对了三问——答对的会忘。是因为你摔过的每一跤,都刻在模型上了。这叫ML pipeline——数据收集→预处理→特征工程→训练→评估→部署。少一环,整条线就转不动。可特征还得你亲手喂——什么时候它能自己学?下一座山,叫深度学习。」
流水之门 · ML pipeline六环组装 + 知识图谱 + 境界突破
拖六环到正确顺序 → 流水线贯通 → 点亮知识图谱 → 境界突破
ML pipeline · 六环组装
知识图谱 · 全章碎片回顾
详解 · K03-15 ML pipeline:从数据收集到模型部署
完整流水线六环:数据收集→预处理(清洗、缺失值、异常值)→特征工程→模型训练→评估→部署。工程界共识:数据相关环节占项目 80% 工作量,"训练模型"只是冰山一角。部署不是终点——上线后要持续监控数据漂移(输入分布随时间偏移),性能衰减时触发回流重训,形成闭环。少一环整条线就转不动:预处理漏了缺失值,训练直接报错;评估用了错指标,部署即事故。
详解 · 全章复盘:从满分幻觉到泛化之魂
十幕主线:模式之门下注(K03-01/16 定义与简史)→训灵坛满分诱惑(K03-02 监督范式)→万象阁特征暗流(K03-13/03)→试炼场 100%→62% 耳光(K03-11/09 混淆矩阵与四指标)→假设殿寻因(K03-05/04 假设空间、NFL、强化学习)→诊断台分解(K03-06/14 偏差方差与学习曲线)→折折磨室徒劳(K03-08 CV 是尺不是药)→正则之泉锁记忆(K03-07 L1/L2)→评估殿完整审判(K03-10/12)→三问收网。一句话总纲:好模型的灵魂是泛化——CV、正则化、ROC 一切工具,都为"未见数据上的表现"服务。