反向传功
你以为算对梯度就能训练。可梯度告诉你方向,学习率告诉你步子——步子太大,一脚踩出损失函数的地图,再也回不来。发散之焰在暗处记账:你每觉得可以跳过warmup、可以不裁梯度,它就胖了一圈。
功台初燃
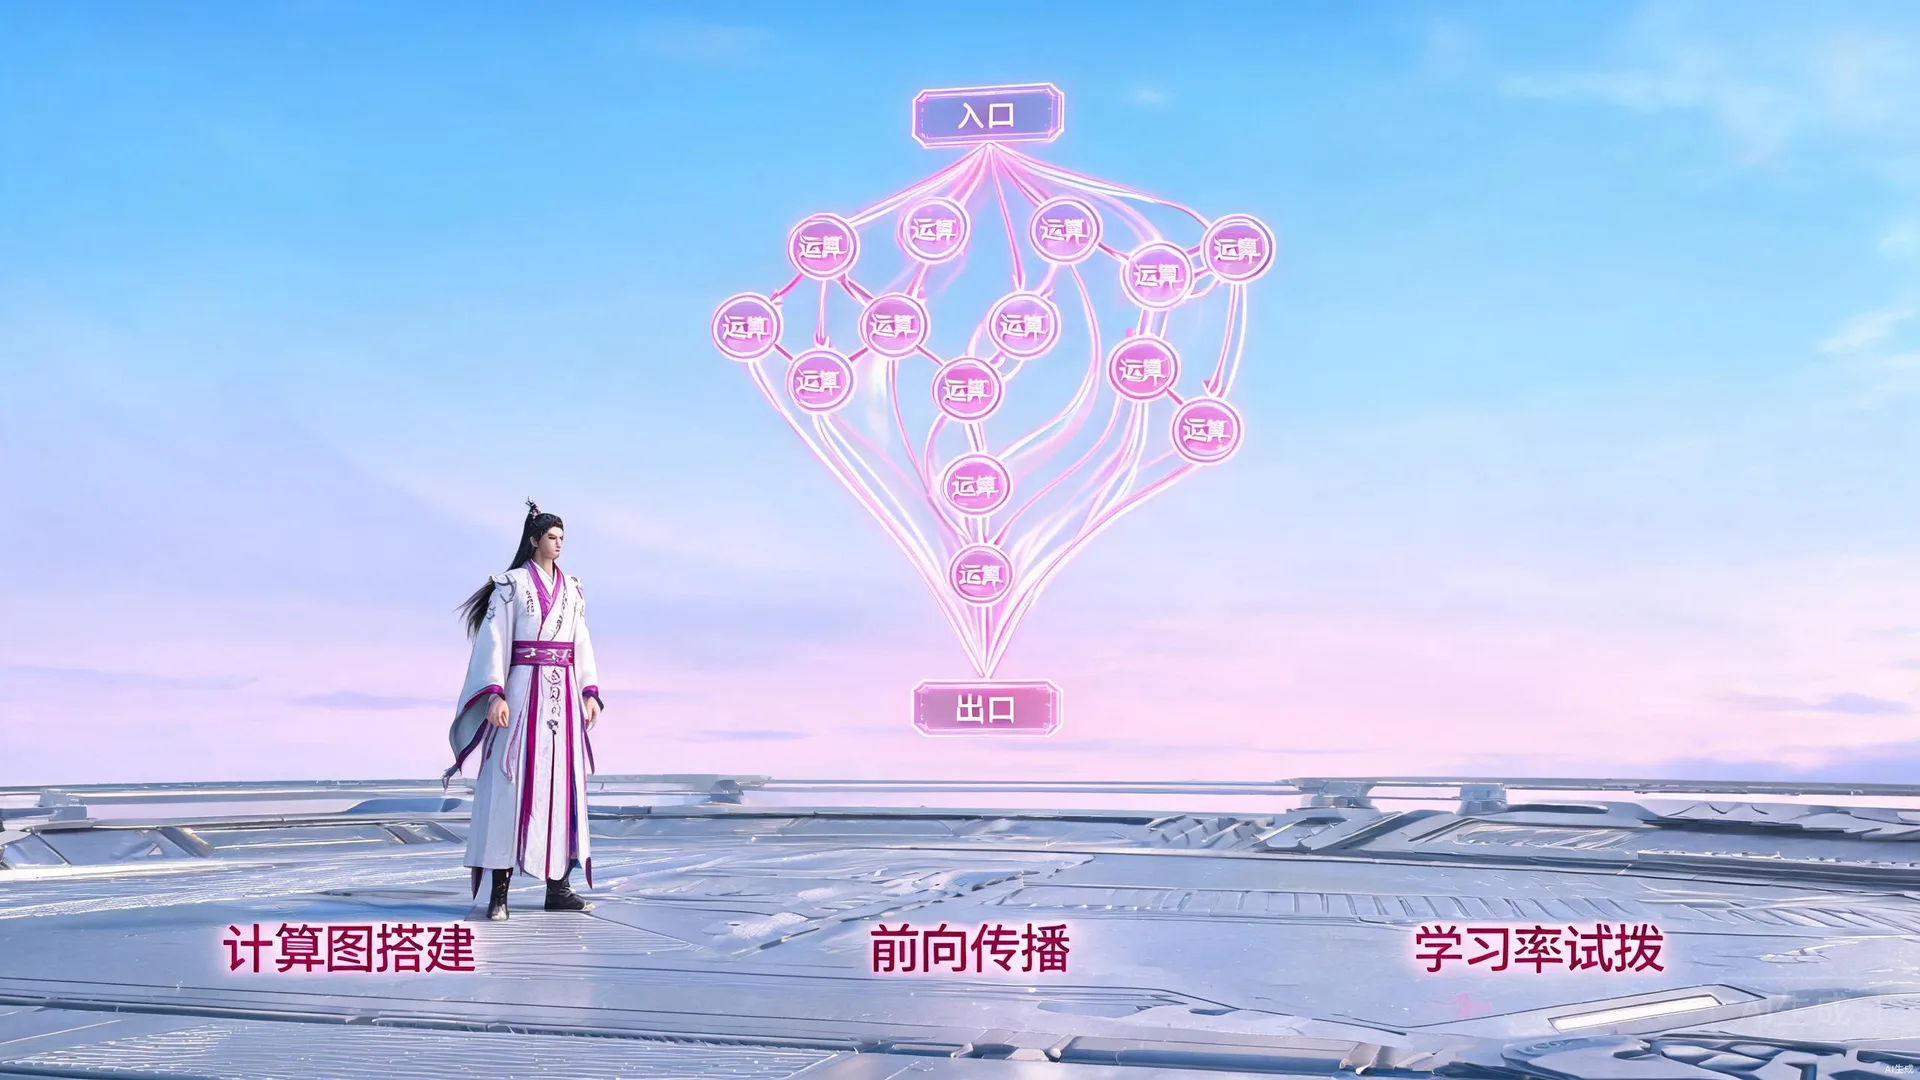
你从残差连接的捷径里走出来,脚下的地面变了——冰冷的、刻满纹路的金属台面。面前悬浮着一张巨大的、由发光节点和连线构成的图——节点是运算,连线是数据。它像一条倒挂的河,从顶端入口流向底端出口。
 高斯老祖
「这是计算图。你的网络长什么样,它就长什么样。数据从上面流下去——叫前向。但你真正的目的,是让数据流回来——叫反向。先让它流起来。」
 发散之焰
「学习率旋钮随手拨——拨大点,学得快。我帮你记着。Step子太大——后面烧焦的字你看不清。」
计算图搭建器 · 前向传播执行 · 学习率试拨
按正确顺序串联运算节点 → 数据光流前向执行 → 学习率旋钮试拨(拨大触发焰账)
详解 · K07-01 计算图的构建与前向/反向传播
计算图把网络表达成有向无环图:节点是运算(矩阵乘、加法、激活),边是数据(张量)。前向传播按拓扑序从输入算到损失——z=W·x+b、a=f(z)、L=L(ŷ,y),同时把每个节点的中间结果存下来;反向传播沿反拓扑序,用链式法则把损失的梯度一路传回每个参数,存的中间值正好在组装梯度时被调用。前向存数据、反向用数据——这就是训练框架(PyTorch/TensorFlow)的底层抽象:你搭网络时,框架就在后台建这张图,loss.backward() 一声令下沿图回传。
前向殿 · 两种微分
前向殿中央悬浮着你在 S0 搭的那张计算图,但这次它变大了——十层,每层都有权重矩阵 W 和偏置 b,总共 47 个参数。殿内悬着一口钟。你不假思索:"一个一个求呗。"
高斯老祖
「你需要 ∂L/∂W₁ 到 ∂L/∂W₄₇。47 个梯度。怎么算?好——那就一个一个来。」
发散之焰
「逐个求导,多直接。钟声好听吗?这第 20 下了——你还有 27 个。」
自动微分模式对比器 · 前向逐参 vs 反向一次
前向模式逐参计算(钟声计数47次)→ 反向模式一次性回传 → 复杂度曲线对比
详解 · K07-02 自动微分:前向模式 vs 反向模式
自动微分(autodiff)不是数值微分(差分近似,有截断误差),也不是符号微分(表达式爆炸),而是把链式法则作用于基本算子、精确到机器精度。前向模式:每跑一次追踪一个输入方向(种子)的导数——N 个参数要 N 次遍历,适合"多输出少输入";反向模式:从输出端回传伴随量(adjoint),一次遍历算清全部输入的梯度,代价约为前向的 2~5 倍,与参数数量无关——适合"少输出多输入"。神经网络一个标量损失、百万级参数,反向模式(即反向传播)是唯一可行的选择;JAX 同时提供两种模式(jacfwd/jacrev)供按问题形状挑选。
反传天梯 · 链式法则的真相
殿后是一座悬空石梯,从底部"输出层"一直通到顶部"输入层"——方向是反的,越往上越接近网络起点。梯上每一级石阶都刻着空白的公式槽位。
高斯老祖
「链式法则你学过。但在多层网络里,它长成什么样——你得自己一步一步踩上去。从输出层开始,往上爬。」
链式法则推导天梯 · 分步公式组装 · 梯度账本
输出层误差信号 δᴸ → 逐层回传 δˡ → 梯度组装 ∂L/∂W · 9 个槽位
梯度账本 · 各层梯度范数 ‖∂L/∂Wˡ‖
详解 · K07-03 反向传播的完整数学推导:多层网络
定义误差信号 δˡ = ∂L/∂zˡ(损失对第 l 层预激活的偏导),四个基本方程构成完整推导:①输出层 δᴸ = ∇_a L ⊙ f′(zᴸ)——损失对输出的梯度,经激活导数筛选;②回传 δˡ = (Wˡ⁺¹)ᵀδˡ⁺¹ ⊙ f′(zˡ)——用下一层权重转置把误差信号"搬运"回本层;③权重梯度 ∂L/∂Wˡ = δˡ(aˡ⁻¹)ᵀ——误差信号与前向存下的激活外积组装;④偏置梯度 ∂L/∂bˡ = δˡ。复杂度仅约为一次前向的 2 倍——这是 1986 年 Rumelhart-Hinton-Williams 论文让多层网络训练可行的核心。注意 ②中连乘的 W 转置与 f′:连乘项小于 1 会梯度消失、大于 1 会梯度爆炸,这是 ch08 之后残差连接与归一化存在的理由。
优化器阁 · 六器争锋
阁内悬着一张巨大的三维损失地形图——沟壑纵横,有平坦的高原、陡峭的峡谷、和一个深处的全局最小值。六把形态各异的法器浮在地形旁,各自亮着名字。
高斯老祖
「梯度告诉你下坡的方向。但这六把法器,各有各的走法。在同一个地形上跑一遍,看它们怎么走、怎么摔。」
发散之焰
「六把法器挑一把趁手的就行了——无脑 Adam 嘛。走得快不等于走得稳?远处那火光,你看到了吗?」
六器争锋 · 损失地形轨迹对比 + Adam 偏差修正
逐一释放六种优化器 → 观察轨迹与失败模式 → Adam 偏差修正开关对比
详解 · K07-04 优化器全景:SGD/Momentum/AdaGrad/RMSProp/Adam/AdamW
SGD:w←w-η∇L,朴素但峡谷地形会来回振荡。Momentum:v←βv+∇L、w←w-ηv(β≈0.9),惯性抹平振荡、加速一致方向。AdaGrad:累积平方梯度 G←G+∇L²,逐参数学习率 η/√G 单调递减——稀疏特征友好,但后期"越走越累"停在半路。RMSProp:G 改指数滑动平均 G←βG+(1-β)∇L²,解决 AdaGrad 早停。Adam=Momentum(一阶矩 m)+RMSProp(二阶矩 v)+偏差修正,β₁=0.9、β₂=0.999、ε=10⁻⁸ 是默认三件套。AdamW:把权重衰减从梯度里解耦出来直接作用于参数,是当今大模型训练的默认选择。
详解 · K07-05 Adam 优化器的偏差修正机制
Adam 的一阶矩 m 和二阶矩 v 都初始化为 0,指数滑动平均意味着前几步它们严重偏向 0:m₁=0.1g₁,若直接拿来用,有效步长只有真实值的 1/10——起步瘫痪。偏差修正用m̂ₜ=mₜ/(1-β₁ᵗ)、v̂ₜ=vₜ/(1-β₂ᵗ) 做无偏估计:t=1 时 m̂₁=0.1g₁/0.1=g₁,恰好还原。随着 t 增大 1-βᵗ→1,修正自动淡出。关掉它(本章开关实测):Adam 前几步几乎原地不动——这块"出生补丁"是 Kingma & Ba 2014 原论文的关键细节,也是所有框架默认开启它的原因。
学习率之渊 · 焰之第一击
渊底悬着你的模型晶核——一颗多面体水晶。你选了 Adam,把学习率旋钮拨到了 0.1——0.001 收敛太慢,你想"快一点"。第 1 步 loss=2.3,第 2 步 5.7,第 3 步 47.2,第 4 步 1.2×10⁴,第 5 步 NaN。火光从渊底升起,凝成一张没有五官的火焰面孔。
发散之焰
「再大一点。哈哈哈哈!第 1 步!你连第 1 步都没挺过去——我是发散之焰,不住在你的无知里,住在你'这次会不一样'的侥幸里。」
高斯老祖
「梯度告诉你方向,学习率告诉你步子。步子太大,一脚踩出损失函数的地图。训练初期最危险——先小后大,叫 warmup。」
训练崩溃模拟器 · loss 爆炸 + 学习率扫描 + warmup
触发 η=0.1 NaN 崩溃 → 学习率扫描找稳定区间 → warmup 稳定训练 → 晶核裂痕
详解 · K07-17 训练稳定性:梯度范数监控/损失尖峰/学习率探测
训练崩溃有三种典型先兆:loss 尖峰(某个 batch 后 loss 突跳然后 NaN)、梯度范数暴涨(‖∇L‖ 比平时大几个数量级)、激活值饱和。工程对策是监控三件套——每 step 记录 loss、梯度范数、学习率,异常即告警。学习率探测(LR Range Test,Smith 2017):让 lr 从极小值指数增长到极大值,画 loss-lr 曲线,选"下降最快处"的数量级作为初始 lr——比拍脑袋靠谱。本章崩溃序列 2.3→5.7→47.2→1.2×10⁴→NaN 是 lr 超阈值的经典形态:二次近似下 lr>2/λ_max(λ_max 为损失 Hessian 最大特征值)必然发散,一旦越界每步都在指数放大误差。
调度钟楼 · 节拍与裁剪
钟楼内部悬着三口巨大的钟,各自标着不同的节拍图案:StepLR 是台阶式的断崖、Cosine 是一条平滑的余弦曲线、Warmup 是一段从零升起的斜坡。钟楼中央还有一个红色拉杆,标着"梯度裁剪"。
高斯老祖
「学习率不是一成不变的。它有自己的节拍。而梯度裁剪是最后一道护栏:不管梯度多大,都别让它超过这条线。」
学习率调度可视化器 + 梯度裁剪实验
切换三种调度策略看 lr/loss 联动 → 梯度裁剪兜底 bad batch → 组合策略稳定训练
详解 · K07-06 学习率调度:StepLR/CosineAnnealing/Warmup
StepLR:每 k 个 epoch 学习率乘 γ(如 30 epoch ×0.1),阶梯式——loss 在每次降阶时跳降一档,ResNet 时代标配。Cosine Annealing:ηₜ=η_min+(η₀-η_min)(1+cos(πt/T))/2,平滑降到接近零,后期震荡小,当前主流。Warmup:训练最初几百到几千 step 把 lr 从 0(或极小)线性升到目标值——训练初期参数随机、梯度方向未稳、Adam 二阶矩未就位,大 lr 直接自杀;Transformer 训练几乎必须 warmup。现代大模型配方 = warmup(~2000 步)+ cosine 衰减至峰值 10%。
详解 · K07-11 梯度裁剪:按值裁剪/按范数裁剪
按值裁剪(clip by value):把每个梯度分量截到 [-τ, τ]——简单但会改变梯度方向。按范数裁剪(clip by norm):若 ‖g‖>τ 则 g←g·τ/‖g‖——只缩不放、保持方向,是工业界标准(Pascanu 2013 为 RNN 梯度爆炸提出)。τ 常用 1.0;本章 bad batch 注入梯度范数 47.3,裁剪到 τ=1.0 后 loss 只起小尖峰。要点:裁剪是"安全带"而非"刹车"——它不改变常态训练,只在异常梯度出现时兜底;大模型训练中它是与 warmup 并列的必选项。
调参擂台 · 超参与精度
擂台中央立着一块巨大的石碑,上面刻着一个三乘三的网格——每个格子代表一组超参数组合。石碑旁还有一面铜镜,镜面上浮动着"FP32"和"FP16"两个标记。
高斯老祖
「三个旋钮,每个几十种选择。全部试一遍?还是聪明地试?另外,你的训练太慢了——铜镜能帮你加速,但它有代价。」
超参数搜索可视化器 + 混合精度训练模拟器
三种搜索策略热力图对比(网格27/随机8/贝叶斯8) → FP16/BF16 切换 + 损失缩放防下溢
混合精度铜镜
详解 · K07-07 超参数调优:网格搜索/随机搜索/贝叶斯优化
网格搜索:每个维度取若干值穷举所有组合——3 维 ×3 值=27 次试验,维度一多就爆炸(维度灾难),且在不重要维度上浪费大量算力。随机搜索(Bergstra & Bengio 2012):各维度独立随机采样——反直觉地更高效:真正影响结果的超参往往只有 1~2 个,随机采样让这些"重要维度"被覆盖得更密,8 次试验常胜网格 27 次。贝叶斯优化(TPE/GP):用代理模型拟合"超参→性能"的映射,每次选期望改进最大的点试——8 次就能逼近最优,但串行难并行。实践:粗调随机搜索、精调贝叶斯,学习率先对数均匀采样。
详解 · K07-12 混合精度训练:FP16/BF16 与损失缩放
FP16(1 符号/5 指数/10 尾数):显存减半、Tensor Core 吞吐 2~8 倍,但最小次正规数仅 2⁻²⁴——大量梯度直接下溢为零。对策是损失缩放(loss scaling):loss×S(S=2¹⁶=65536),链式法则让梯度同步放大 S 倍、越过下溢线,更新前再 ÷S 还原(Micikevicius 2018)。BF16(1/8/7):指数位与 FP32 相同、动态范围不缩水,无需损失缩放,代价是尾数精度低——大模型训练主流。FP32 保留主权重副本(master weights)是共同配方:半精度算前向反向,全精度存权重做更新。
正则之壁 · 防线构筑
你面前是一面巨大的石壁,壁上刻着四个空位。石壁前的训练台上,一个网络正在过拟合——训练 loss 降到 0.01,验证 loss 却从 0.3 飙到 0.8。它在背答案。
高斯老祖
「训练集上每个样本它都记住了,没见过的一来就错。你要给它建防线——不是一道,是四道。」
正则化防线构筑 · 四道开关 + train/val 双曲线 + 权重衰减 vs L2
逐一启用 L2/Dropout/数据增强/早停 → train/val 曲线变化 → SGD/Adam/AdamW 等价性对比
权重衰减 vs L2 等价性 · SGD/Adam/AdamW 三组
详解 · K07-08 正则化方法总结:L2/Dropout/DataAug/EarlyStop
四道防线机制各异:L2 在损失上加 λ‖w‖²,梯度更新等价于每步先把权重乘 (1-ηλ) 缩小——惩罚大权重、偏好平滑函数;Dropout(Hinton 2012)训练时以概率 p 随机将神经元输出置零、推理时缩放 1/(1-p)——迫使特征冗余分布,可看作指数级子网络的集成平均;数据增强扩充有效数据集、注入不变性先验;早停把"训练轮数"本身当作超参数,在验证 loss 拐点喊停并回滚到最优权重。四者可叠加——它们作用在训练的不同环节,互不冲突。
详解 · K07-09 数据增强策略:图像/文本/语音
图像:随机翻转/裁剪/旋转/颜色抖动是基础款;进阶有 Cutout(随机遮挡方块)、Mixup(两张图线性混合、标签也混合)、CutMix(剪贴一块区域)、RandAugment(自动搜增强策略)。文本:同义词替换、随机插入/删除/交换、回译(中→英→中)、EDA 四件套;大模型时代更多是改写与蒸馏。语音:加噪、变速变调、SpecAugment(频谱上遮挡时间/频率条带)。核心思想一致:用领域知识构造"答案不变"的变换,把不变性先验免费注入模型——数据量不变,有效多样性翻倍。
详解 · K07-10 早停法 Early Stopping 的原理与实现
验证 loss 通常呈 U 形:先降(学习有效模式)后升(开始背训练集噪声)。早停在"连续 patience 轮验证 loss 无改善"时停止训练,并把权重回滚到验证最优的那个 checkpoint——patience=10 是常用值。理论上早停等价于一种正则化:限制有效训练步数 ≈ 限制参数可到达的区域大小(与 L2 的隐式约束类似,Goodfellow 花书 Ch7 有二次损失下的等价推导)。实现要点:必须用独立验证集、保存最优权重而非最终权重;与 cosine 调度同用时,早停常退化为"调度自动走完",但保留监控仍是安全网。
详解 · K07-14 权重衰减与 L2 正则化的等价性
对 SGD:L2 损失 L+λ‖w‖²/2 的梯度是 ∇L+λw,更新 w←w-η(∇L+λw)=w(1-ηλ)-η∇L——与"先权重衰减再梯度步"完全等价。对 Adam:L2 项 λw 进入梯度后会被自适应缩放 m̂/√v̂ 扭曲——梯度大的参数正则化效果被削弱,各参数实际衰减力度不一,等价性破裂。AdamW(Loshchilov & Hutter 2019)把衰减项从梯度中解耦:w←w-η·m̂/√v̂-ηλw,衰减直接、均匀地作用于所有参数——泛化显著提升,成为 Transformer 训练的事实标准。结论:论文里写"weight decay"用 Adam 实现的,几乎都该用 AdamW。
诊断之眼 · 从曲线到迁移
诊断之眼是一面巨大的悬浮镜面,镜面上实时映出训练曲线——train loss 和 val loss 两条线,像两条纠缠的蛇。镜面旁立着一座祭坛,祭坛上封着一个巨大的预训练模型——内部刻满了在百万张图像上学到的特征纹路。
高斯老祖
「训练跑完了不等于跑好了。你得先会读曲线——它在告诉你网络的状态。有时候,你不需要从头炼——祭坛上有别人炼好的。」
发散之焰
「模式C那条 NaN 曲线,你在 S4 亲手画过。旧伤未愈——晶核裂痕又该闪了。」
训练曲线诊断器 + 迁移学习模拟器
四种异常曲线逐一诊断 → 加载预训练权重 → 冻结/分层LR/渐进解冻三种微调
迁移学习 · 小数据集(1000图/10类)
详解 · K07-13 训练诊断:训练曲线/验证曲线分析
四种典型曲线对应四种处方:①双高不降(train/val 都高且贴合)=欠拟合——加容量、减正则、训更久;②train 降 val 升=过拟合——加正则、数据增强、早停;③突然蹿天(loss 尖峰→NaN)=训练崩溃——降 lr、warmup、梯度裁剪,查 bad batch;④极慢下降=lr 太小——调大 lr 或用 LR Range Test 定位。诊断顺序建议:先看 train loss 能不能降(不能=模型/优化器/实现 bug),再看 val 跟不跟(不跟=泛化问题),最后看曲线形状定处方。吴恩达口诀:先拟合训练集,再谈泛化。
详解 · K07-15 迁移学习:预训练+微调的范式
在大数据集(ImageNet 1400 万图、海量语料)上预训练的模型,其底层学到的是通用特征(边缘/纹理/词法),高层是任务特化特征。迁移学习把预训练权重搬过来,在小数据集上微调——1000 张图/10 类从头训练必然欠拟合,迁移后却能达到可用精度,所需数据量可降 1~2 个数量级。适用条件:源任务与目标任务有特征可迁移性(同模态、相近分布);数据越少,越该冻结更多层。这一范式是当今 CV/NLP 的绝对主流——BERT、GPT、CLIP 全部是"预训练+微调/提示"路线。
详解 · K07-16 微调策略:冻结层/学习率分层/渐进式解冻
三种策略按"对预训练权重的尊重程度"递降:①冻结骨干——只训新分类头,最快最省、防过拟合,但性能上限受限于预训练特征的适配度;②分层学习率——底层小 lr(1e-5,通用特征少动)、高层大 lr(1e-3,任务特化层多调),ULMFiT(Howard & Ruder 2018)提出,性能与稳定性兼顾;③渐进式解冻——先冻全部只训头部,再自顶向下逐层解冻微调,每解冻一层先低 lr 热身——最稳,防"灾难性遗忘"(微调初期大梯度把预训练特征冲垮)。经验法则:数据越少越往 ①靠,数据越多、域差异越大越往 ③靠。
Boss 战 · 发散之焰
一切灯光齐灭。火焰从四面八方压过来,凝成一张巨大的、没有五官的火脸。"我是发散之焰。我不住在你的无知里——无知救不了我。我住在你'这次会不一样'的侥幸里。三问。答错一题,火就烈一分。"
发散之焰
「让我看看你这趟传功,是真学会了,还是只是逛了一圈。焰账上记着你每一次'再大一点'——现在,一笔笔还。」
焰账累计 0 笔 · 三问全对后清零
尾声 · 破晓
焰散尽时天刚破晓,你手里的模型晶核微微发光——不是它变了,是你变了。晶核上的梯度裂痕还在,像一枚没说出口的勋章。
高斯老祖
「你入门了。不是因为你答对了三问——答对的会忘。是因为你搭过的每一道防线、炸过的每一次 NaN、修过的每一道裂痕,都刻在你手上了。但你训练的网络,看见的世界和你一样吗?它把一张图片拉成一条长向量,丢了所有的空间结构。明天,我们去看网络怎么'看'。那叫卷积。」
知识图谱点亮 · 反向传功圆满
逐一点亮本章碎片 → 连线生长成网 → 境界突破
详解 · 全章复盘:从链式法则到工程堡垒
十幕主线:功台初燃搭计算图(K07-01)→前向殿两种微分比效率(K07-02,O(N) vs O(1))→反传天梯推导 δ 回传四式(K07-03)→优化器阁六器争锋与 Adam 补丁(K07-04/05)→学习率之渊 NaN 首炸(K07-17)→调度钟楼节拍+裁剪护栏(K07-06/11)→调参擂台搜索三法与混合精度(K07-07/12)→正则之壁四道防线与 AdamW 等价性(K07-08/09/10/14)→诊断之眼读曲线、迁移借力(K07-13/15/16)→焰账三问收网。一句话总纲:反向传播给你梯度,而训练稳定性——warmup 的起步、cosine 的节拍、裁剪的护栏、正则的锁链、诊断的读图——是把梯度安全走完全程的工程纪律。