卷积观象
你以为加层就能提升性能。从 LeNet 到 VGG 一路往深走,越深越强——直到你训练出 56 层网络,发现它比 20 层还差。不是过拟合,是退化。深度之壁在你面前凝成实体,你的优化器够不到那个解。
观象初醒
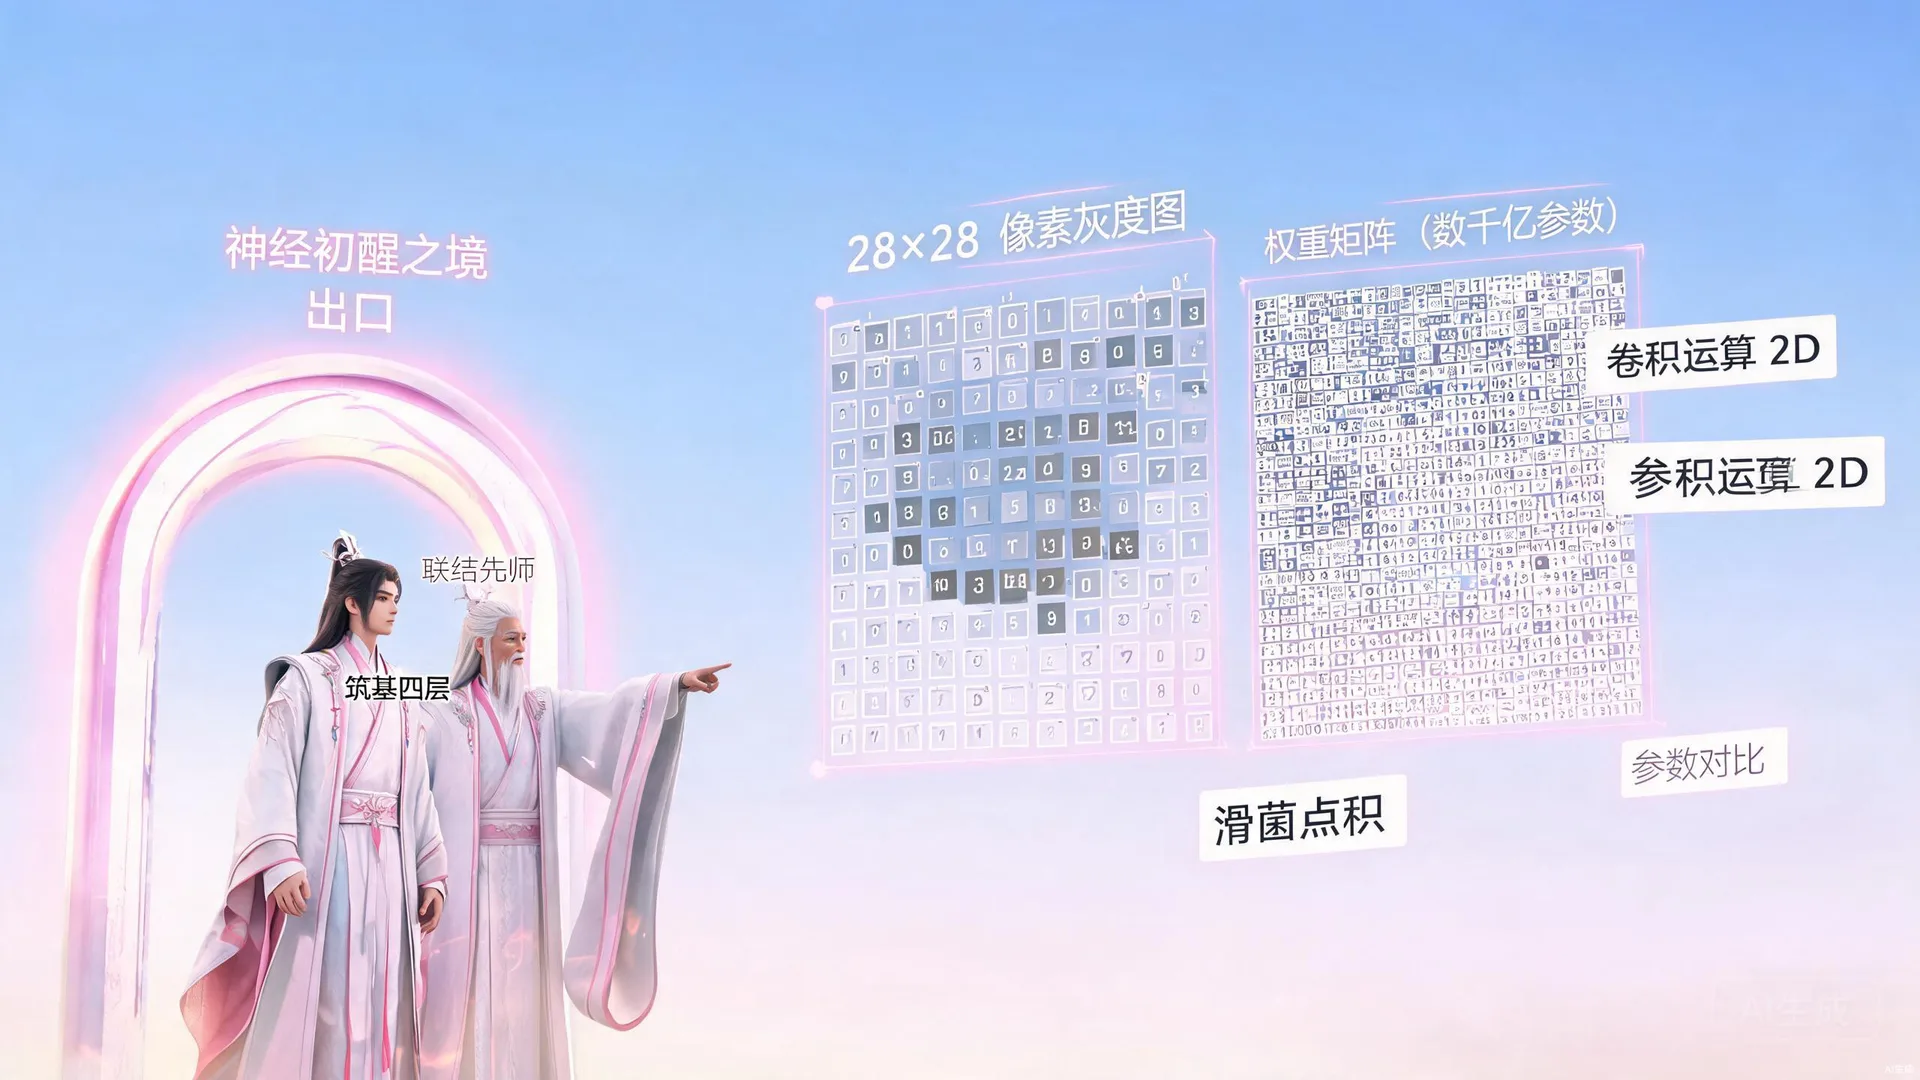
你从神经初醒之境的出口走出来。联结先师跟在你身后。面前悬浮着一张灰度图——28×28 的像素网格,每个格子是一个数字。一个巨大的权重矩阵浮现,数十亿个参数密密麻麻。联结先师指向那张图:「你的眼睛不是这么看东西的。」
 联结先师
「你学会了全连接,每个神经元看到所有输入。但世界不是一维的——你睁眼看见的是一张图,有行有列,有上下有左右。224×224 彩色图要 150,528 个输入,每个神经元连到所有像素。这行得通。但你的眼睛不这么看。」
 深度之壁
「全连接怎么了?参数多一点而已,算力够就行。干嘛要换法子?」
卷积滑窗演示台 · 1D/2D 滑窗点积
拖动核滑过信号 → 看每个位置的点积输出 → 全连接参数对比
滑窗殿 · 三大假设
殿内三根石柱,每根刻着一个词:局部。共享。不变。联结先师指向第一根柱:「全连接的问题——每个神经元看到所有输入。但图像的特征是局部的,一只猫的耳朵不会同时出现在图像的四个角落。」
联结先师
「三大假设不是三个技巧,是一个信念:图像的特征是局部的、可平移的、可复用的。全连接不懂这个信念,所以它需要一亿个参数。卷积懂,所以它需要九个。再用填充和步幅控制输出尺寸。」
三大假设验证台 · 参数对比 + 权值共享 + 平移不变性 + 填充步幅
数参数 → 看权值共享 → 拖猫测平移不变性 → 调填充步幅看输出公式
局部连接
平移不变性
填充 / 步幅实验台
详解 · K08-02 卷积的三大假设:局部连接/权值共享/平移不变性
①局部连接:每个输出位置只看输入的 K×K 邻域——图像特征是局部的(猫耳不会同时出现在四角),连接数从"全图"缩到"窗口";②权值共享:同一个核扫全图——猫耳检测器在左上角和右下角应该是同一个,参数进一步缩到每核一份;③平移等变:输入平移一格、特征图跟着平移一格(严格说是等变 equivariance;经池化/全局操作后才近似"不变" invariance)。三者合力使参数量与图像大小解耦:224×224×3 输入,全连接一个神经元要 150,528 个权重,3×3 卷积每核只要 9×C_in 个——这就是 S1 三张卡片参数对比背后的机制。
详解 · K08-03 填充Padding与步幅Stride对输出尺寸的影响
输出尺寸 O=⌊(N+2P−K)/S⌋+1。Padding 在四周补零,控制收缩:K=3 配 P=1、K=5 配 P=2 即"same"卷积(尺寸不变),这是 VGG/ResNet 全程的惯例;P=K−1 时输出反而变大。Stride 是滑窗步距:S=2 即硬下采样,输出尺寸约减半(例:N=6, K=3, P=1, S=2 → O=⌊(6+2−3)/2⌋+1=3)。若 (N+2P−K) 不能被 S 整除,右/下边缘像素被静默丢弃。设计惯例:卷积层只管"same",分辨率下降交给池化或 stride=2 卷积统一管理——账目清楚,感受野计算才有据可查。
观象台 · 感受野与池化
观象台中央悬浮着一张巨大的 224×224 图像。你手持一个 3×3 卷积核,信心满满——「滑过去就行了。」联结先师问:「你的核一次看几个像素?」「九个。」「这张图几个像素?」「50,176 个。」「你一滑动就能看到全图吗?」你犹豫了。你开始堆层。但堆着堆着,一个声音从深处传来——低沉,像石壁在呼吸。「再加一层。」
联结先师
「要看得远,就得堆得深——而深度,是有代价的。感受野随深度增长,池化层下采样减少计算量。但你堆了十层才看到 21×21 的感受野。要看完整张 224 的图,需要堆到多少层?这个问题的答案,是这章的噩梦。」
感受野计算器 + 池化实验台 + 深度账本
逐层加卷积 → 看感受野方框在原图扩大 → 切换池化类型 → 账本开立
感受野逐层计算器
池化实验台 · 最大 / 平均 / 全局
详解 · K08-04 感受野:定义/计算/与网络深度的关系
某层一个输出像素"看到"的输入区域大小。递推式:RFₗ=RFₗ₋₁+(Kₗ−1)·∏ᵢ₌₁ˡ⁻¹sᵢ——本层核扩张 (K−1),再乘上此前所有层的步幅累积(残差跳连不扩大感受野,只保梯度)。两层 3×3(s=1)=5×5,三层=7×7——S2 账本"十层 3×3 才 21×21"就是这么算的:RF=1+10×2=21。步幅/池化让感受野加速增长:VGG-16 五次下采样后,最后一层卷积感受野 196;stride=2 卷积同样一步把扩张速度翻倍。工程要求:分类骨干的最终感受野应≥输入尺寸,否则模型在"管中窥豹";检测/分割对大物体要求数百像素感受野——这正是深层 backbone 的存在理由。
详解 · K08-05 池化层:最大池化/平均池化/全局池化
最大池化取窗内最大值——保留最强激活、对小平移鲁棒,2×2/s2 是最常见配置;平均池化取均值——更平滑、保留整体能量(GoogLeNet 过渡层用它);全局池化 GAP 把整张 H×W 压成 1×1——每通道一个数,直接接分类头,替代千万参数的全连接层(NIN 提出、GoogLeNet/ResNet 采纳),且天然空间不敏感、几乎零参数。池化层无参数、不可学习,作用是下采样(减计算、扩感受野)+注入小平移不变性。现代趋势:下采样多改用 stride=2 卷积(可学习),但 GAP 作为"空间信息收束器"存活至今——SENet 的 squeeze 操作正是从它出发的。
灵图殿 · LeNet-5
殿中悬浮着一台古旧的法器——1998 年的 LeNet-5。石板上浮现架构图:Input(32×32)→Conv1(5×5,6)→Pool→Conv2(5×5,16)→Pool→FC(120)→FC(84)→Output(10)。深度账本翻到第一页。联结先师问:「你知道它每一层学到了什么吗?」
联结先师
「1998 年它就能识别手写数字。但它沉睡了十四年——那时候没有足够的数据、算力、技巧。它的同类要等到 2012 年才醒来。先搭架构,跑一遍前向传播,看它每层学到的特征。」
LeNet-5 架构搭建器 + 前向传播 + 特征可视化
拖入各层组件 → 逐步前向传播 → 看各层激活特征图
详解 · K08-06 LeNet-5:第一个成功的CNN架构
LeCun 1998(Gradient-Based Learning Applied to Document Recognition):Input 32×32 → C1(5×5×6) → S2 池化 → C3(5×5×16) → S4 池化 → C5(120) → F6(84) → 输出 10 类,约 6 万参数——正是 S8 计算器的第一行。三个首创:卷积+池化+全连接的架构范式、反向传播端到端训练、梯度下降直接优化识别误差;90 年代末投入银行支票手写数字识别商用。它的历史意义与它的沉睡同样重要:架构正确,但数据(百万级)、算力(GPU)、训练技巧(ReLU/Dropout)三缺——14 年后 AlexNet 集齐三块拼图才唤醒它。深度学习不是单点发明,是一整套条件的同时成熟。
详解 · K08-12 特征可视化:CNN学到了什么/激活最大化
S3 特征图画的就是这条"层次化学习"曲线:浅层=边缘/颜色/朝向(类似 V1 视皮层简单细胞);中层=纹理/部件(眼睛、轮子);深层=语义物体(狗脸、整车)。方法家族:①反卷积可视化(Zeiler & Fergus 2014,ZFNet)——把每层激活反投影回像素空间;②激活最大化(Simonyan 2014)——梯度上升合成"让这个神经元最兴奋"的图像;③导向反向传播(Springenberg 2014)与 Grad-CAM(2016,定位类别关注的区域)。用途不只是好看:ZFNet 由此发现 AlexNet 第一层核过大过密,改成 7×7/s2 后性能提升——可视化是调试 CNN 的显微镜,也是"深度特征可迁移"(ch07 迁移学习)的证据来源。
破壁殿 · AlexNet
2012 年 9 月。ImageNet 大赛。联结先师指着一块石碑:「2011 年冠军,传统方法,Top-5 错误率 25.8%。2012 年,AlexNet 把它砸到 15.3%。砸了十个百分点,整个领域炸了。」AlexNet:5 卷积 + 3 全连接,8 层,6000 万参数。「它做了三件以前没人做过的事。」
联结先师
「你在 ch06 见过梯度消失——ReLU 是你的第一把刀,它就是从这间殿里磨出来的。三大突破缺一不可:ReLU 解决梯度消失让深度可训,Dropout 解决过拟合让大模型不崩,GPU 解决算力让大规模训练可行。」
AlexNet 三大突破 · ReLU vs Sigmoid + Dropout + GPU
对比两种激活的梯度/损失 → 开关 Dropout → 拖算力滑块
ReLU vs Sigmoid 训练对比
Dropout 正则演示
GPU 算力滑块
详解 · K08-07 AlexNet:ReLU/Dropout/GPU训练
Krizhevsky et al. 2012,ImageNet 2012 冠军:Top-5 错误率 15.3%,比 2011 年传统方法冠军的 25.8% 砍掉十个百分点(当年第二名 26.2%)——深度学习元年的引爆点。8 层(5 卷积+3 全连接)、6000 万参数、约 7 亿 FLOPs。三大突破缺一不可:①ReLU——正区梯度恒为 1,替代深部饱和的 tanh/sigmoid,梯度不再消失,论文实测同精度收敛快约 6 倍;②Dropout p=0.5 加在全连接层——6000 万参数的过拟合防火墙;③两块 GTX 580 GPU 并行训练——大规模训练第一次在经费内可行。配角同样关键:数据增强(裁剪/翻转/PCA 色彩抖动);LRN 当时有用,后被 BN 取代。
叠核殿 · VGGNet
殿中并排放着两个卷积核:一个 11×11,一个 3×3。联结先师:「AlexNet 第一层用了 11×11 的大核。2014 年 VGG 问——一个 11×11 核的感受野,用几个 3×3 核能替代?五个。但参数 121 vs 45,少了 63%。而且五个 3×3 有五层非线性,一个 11×11 只有一层。更深,更省,更强。」
联结先师
「VGG 告诉你一个道理:深比宽好。与其用一个又大又笨的核,不如用几个又小又深的核。从此 CNN 的设计哲学变成——往深里走。还有个 1×1 卷积,它不碰空间,只在通道维度做线性组合。」
VGG · 大核 vs 小核堆叠 + VGG-16 搭建 + 1×1 卷积降维
对比大核与小核堆叠 → 搭 VGG-16 五段卷积 → 1×1 卷积降通道
1×1 卷积降维实验台
详解 · K08-08 VGGNet:小卷积核堆叠的设计哲学
Simonyan & Zisserman 2014,ImageNet 2014 亚军(Top-5 7.3%)。信条只有一条:全部用 3×3 核(配 P=1)+2×2 池化,往深里堆到 16/19 层。数学账:两层 3×3 的感受野=一层 5×5,但参数 18C² vs 25C²,且多一层非线性;三层 3×3=7×7,参数 27C² vs 49C²。VGG-16 的 1.38 亿参数中约 1.22 亿在全连接层(近九成)——后来 GAP 替代 FC 才挤掉这块水分。历史地位:①证明"深度本身"是关键变量;②架构极度规整(同构块堆叠),backbone 从此模板化;③ VGG 特征多年充当通用特征提取器——迁移学习时代的硬通货。
详解 · K08-11 1×1卷积的作用:降维/跨通道信息交互
Network in Network(Lin et al. 2014)提出,参数量 = C_in·C_out,每个空间位置共享同一组权重。三个作用:①跨通道交互——对每个像素位置做一次 C_in→C_out 的线性组合,相当于"逐像素全连接";②降维/升维——通道瓶颈:Inception 每路前置 1×1 把计算量压下来(S6 实验台可开关实测)、ResNet bottleneck 先 1×1 降 4 倍通道再 3×3 再升回;③增加非线性——Conv+ReLU 在通道维度做非线性重组合。它不改变 H×W,只动通道维——"空间归 3×3、通道归 1×1"是现代架构的分工惯例。
分形殿 · GoogLeNet
殿中悬浮着一个十字形的结构——四个分支并排展开。联结先师:「VGG 往深走。但 Google 的人问了另一个问题——我们不确定这张图该用 1×1 看、3×3 看、还是 5×5 看。那就同时看。这就是 Inception 模块。」四个分支:1×1、1×1+3×3、1×1+5×5、3×3 池化,四路输出在通道维度拼接。
联结先师
「网络自己决定哪一路有用,你不用猜。而且每一路先用 1×1 卷积降维——不然参数爆炸。GoogLeNet 用 22 层、500 万参数,超过了 VGG 的 16 层、1.38 亿参数。效率的胜利。」
Inception 模块搭建器 + 多尺度特征 + GoogLeNet 概览
搭四分支 → 开关 1×1 降维看参数 → 看多尺度特征 → GoogLeNet 架构
详解 · K08-09 GoogLeNet:Inception模块与多尺度特征
Szegedy et al. 2015(Going Deeper with Convolutions),ImageNet 2014 冠军:22 层、500 万参数、Top-5 6.7%——参数约为 AlexNet 的 1/12、VGG 的 1/27。Inception 模块四路并行(1×1 / 1×1→3×3 / 1×1→5×5 / 3×3 池化→1×1)在通道维拼接——设计动机:"我不知道这个位置该用多大感受野看,那就都看,让下一层自己学权重组合"。两个关键工程件:①每路前置 1×1 瓶颈降维,否则 5×5 路参数爆炸(S6 实验台可开关实测);②两个中途辅助分类器(权重 0.3)缓解深层梯度衰减,推理时丢弃。后续演进:Inception v2/v3 引入 BN 与大核分解(5×5→两个 3×3、7×7→1×7+7×1),v4 与 Inception-ResNet 融合残差。
视野殿 · CV 任务全景
殿中三面墙,各显一幅画面。左墙:一张猫的图,标注「分类:这是什么?」中墙:一张街景图,多个物体被框住,标注「检测:哪里有什么?」右墙:一张街景图,每个像素被涂色,标注「分割:每个像素属于什么?」联结先师:「你做的都是分类。但视觉任务不止分类。」
联结先师
「分类只回答'是什么',检测回答'在哪里',分割回答'每个像素是什么'。CNN 不只是一个分类器——它是一个视觉特征提取器,接上不同的头就能做不同的任务。检测的核心是锚框+IoU+NMS,分割的核心是 U-Net 的跳跃连接。」
CV 三大任务 · 检测锚框/NMS + 分割 FCN/U-Net
看同一张图三种输出 → 铺锚框算 IoU 执行 NMS → FCN vs U-Net 跳跃连接
目标检测 · 锚框 + IoU + NMS
语义分割 · FCN vs U-Net
详解 · K08-13 经典CV任务:图像分类/目标检测/语义分割
三级颗粒度:分类(图→一个标签)、检测(图→多个"框+类别+置信度",定位+识别)、语义分割(图→每像素一个类别标签;再区分同类个体则叫实例分割,Mask R-CNN)。难度递增的原因:分类只需全局判断,检测要解决"哪里有多少个",分割要逐像素判决。共同范式:同一个 CNN 骨干做特征提取,换不同的头接不同的任务——分类头(GAP+FC)、检测头(锚框回归+分类)、分割头(上采样解码器)。这就是"预训练骨干+任务头"范式:ImageNet 上学的特征直接迁移(ch07 迁移学习的落地现场)。指标也分级:Top-5/mAP/mIoU。
详解 · K08-14 目标检测基础:锚框/NMS/IoU
锚框(Faster R-CNN,Ren et al. 2015):在每个位置预设一组多尺度多长宽比的先验框(典型 3 尺度×3 比例),网络只学"相对锚框的偏移和缩放"——把开放式回归变成相对参考框的微调,收敛快、覆盖全。IoU=交集面积/并集面积,框重合度的标准量尺:预测框与真值 IoU>0.5 记为命中。NMS:按置信度排序→保留最高分→抑制与它 IoU 超阈值(常 0.5)的其余框→循环——一图多框去重的通用解。两条路线:两阶段(Faster R-CNN 先提候选再精修,精度高)vs 单阶段(YOLO/SSD 一次前向直接出框,速度快)。指标 mAP=各类别 precision-recall 曲线下面积的均值。
详解 · K08-15 语义分割:全卷积网络FCN/U-Net
分割的固有矛盾:下采样换感受野和语义,却把空间细节磨掉了。FCN(Long et al. 2015):把全连接层换成 1×1 卷积——网络变"全卷积",可吃任意尺寸输入;再用转置卷积(反卷积)上采样回原图分辨率,并从浅层跳接细节。U-Net(Ronneberger 2015,医学影像):编码器下采样提语义、解码器对称上采样恢复分辨率,跳跃连接把编码器同尺度特征图直接拼接给解码器——语义与细节在每一级会师。U-Net 用极少量标注即可训练(医学场景刚需),后来成为扩散模型去噪网络的标准底座——一个 2015 年的医学影像架构养活了半个生成式 AI。
深壁殿 · 退化之壁
殿中央是一面巨大的石壁——上面刻满了层数:7、8、16、19、22,越深误差越低。你信心满满刻上「20 层」,训练——误差更低。你刻上「56 层」,训练。深度账本翻到最关键的一页——56 层的训练误差,比 20 层更高。不是验证集。是训练集。石壁上那个声音不再低语了。它在你面前凝成一面墙。「你以为越深越强。56 层比 20 层还差。不是过拟合——你的训练集误差也高。这不是泛化问题。这是退化。」
深度之壁
「你想用更多正则化解决退化?翻开你的账本——训练误差本身就高。正则化是治过拟合的,治不了优化困难。你的优化器够不到那个解。」
退化实验台 · 参数量FLOPs + 20vs56层 + 退化过拟合辨析
算四个网络参数量FLOPs → 训练 20/56 层看曲线 → 辨析退化与过拟合
参数量 / FLOPs 计算器
退化实验 · 20 层 vs 56 层 plain 网络
退化 vs 过拟合辨析
前路预览 · 注意力与轻量化
详解 · K08-18 CNN参数量与计算量(FLOPs)分析
两张账分开记:参数量(存储/过拟合风险):卷积层 =(K·K·C_in+1)·C_out,全连接 =(D_in+1)·D_out;计算量 FLOPs(延迟,按乘加 MAC 计):卷积 =O_h·O_w·K·K·C_in·C_out。三条规律:①卷积参数量与输入尺寸无关,FLOPs 却随它平方增长——分辨率减半、FLOPs 降为 1/4;②VGG-16 参数近九成在全连接层,FLOPs 几乎全在卷积层——两条账各记各的;③本章计算器四行实测:LeNet-5 6 万/36 万、AlexNet 6000 万/7 亿、VGG-16 1.38 亿/155 亿、GoogLeNet 500 万/15 亿——参数省 27 倍、算力省 10 倍还能赢,这就是"效率架构"的意义(S8 前路预览的伏笔)。
详解 · K08-16 通道注意力与空间注意力:SENet/CBAM
SENet(Hu et al. 2018,ImageNet 2017 冠军):Squeeze-Excitation 两步——GAP 把每个通道整张特征图压成一个数(squeeze),两层小 FC(C→C/r→C,r 常 16)+sigmoid 学出每通道重要性权重(excitation),再逐通道缩放特征——"这 512 个通道,哪些更值得听"。CBAM(Woo 2018)在其上加空间注意力:沿通道做 max/avg 聚合→拼接→7×7 卷积→sigmoid,学"特征图上哪里重要"。两个模块即插即用、开销极小——SE-ResNet-50 仅增加约 3.9% FLOPs 就逼近 ResNet-101 的精度。它是 CV 侧的注意力序章——ch12 的自注意力把"加权"推广到全图所有位置。
详解 · K08-17 MobileNet/EfficientNet:轻量级网络设计
MobileNet v1(Howard 2017)核心件:深度可分离卷积 = 逐通道卷积(depthwise,每通道独立做 3×3)+逐点卷积(pointwise 1×1 融合通道)。标准卷积 FLOPs=H·W·K²·C_in·C_out,拆开后 =H·W·K²·C_in+H·W·C_in·C_out,两者之比 =1/C_out+1/K²——3×3 场景约省 8~9 倍。v2 加倒残差(1×1 升维 6 倍→depthwise→1×1 线性降维)治低维信息损失。EfficientNet(Tan & Le 2019):复合缩放——深度、宽度、分辨率按 α·β²·γ²≈2 联动缩放(B0→B7),比单维度瞎堆高效得多。设计哲学一脉相承:手机/边缘设备算力和电量有限,"同精度更少 FLOPs"本身就是研究目标——S8 计算器就是这条赛道的裁判。
Boss 战 · 深度之壁
石壁在你面前凝成一个巨人。灰色的石块堆叠成一张没有表情的脸。它开口了,声音像很多层石头在摩擦。「你以为更深的网络一定更强。但 56 层比 20 层还差。不是过拟合——是退化。你的优化器够不到那个解。三问。答对了,你过去。答错了,你的网络永远停在 22 层。」三道光门浮起。
深度之壁
「我住在你以为'越深越强'的信念里。我输给'学残差,不学映射'——恒等映射变成零映射,SGD 终于够得到。但你记住——我只退了一步,更深的墙在后面。」
退化债累计 0 笔 · 三问全对后清零
顿悟 · 残差之链
石壁合拢后,地面上留着一道金色的线——残差连接的痕迹。它从网络的第一层直通最后一层,绕过了中间所有的退化。联结先师走到你身边:「回顾一下你走过的路。」一面墙亮了起来,上面刻着你这章的全部足迹:从卷积滑窗到三大假设,从感受野到池化,从 LeNet 到 AlexNet 到 VGG 到 GoogLeNet,从分类到检测到分割,从退化到残差。
联结先师
「你搭的每一个架构都对。LeNet 证明可行、AlexNet 证明可大、VGG 证明可深、GoogLeNet 证明可宽。但 56 层打碎了一个信念——'越深越好'。残差连接修复了它——不是通过让网络变浅,而是通过给深路一条捷径。记住,它只退了一步。下一站,循环网络——世界不只有空间,还有时间。」
CNN 发展脉络拼图 · 18 知识点 + 深度账本 + 刻痕终览
拖 18 张知识卡到时间轴正确位置 → 看七组架构账本 → 五道刻痕终览
详解 · K08-10 ResNet:残差学习与深度网络的训练
He et al. 2016(CVPR 最佳论文)。残差块 y=F(x,{W})+x:不直接学目标映射 H(x),而学残差 F(x)=H(x)−x。两重机制:①优化——当最优解接近恒等映射时,F(x)→0 只需权重趋零,比普通网络"每层都要精确拟合一个非线性恒等"容易得多;②梯度——∂y/∂x=1+∂F/∂x,那个"+1"是梯度无损直通的恒等高速路,千层不衰减。战绩:ImageNet 2015 冠军(ResNet-152 集成 Top-5 3.57%);CIFAR-10 上 ResNet-56 测试误差 6.97%(plain-56 反而更差),千层网络可训;ResNet-50(2560 万参数/41 亿 FLOPs)至今仍是通用骨干。深网标配 bottleneck(1×1 降维→3×3→1×1 升维)控制计算量;跳连要求维度匹配,不匹配处用 1×1 投影补齐。
复盘 · 卷积观象主线:从滑窗点积到残差破局的十八步
十幕回望:观象初醒滑窗点积(K08-01)→ 滑窗殿三大假设与填充步幅(K08-02/03)→ 观象台感受野与池化(K08-04/05)→ 灵图殿 LeNet-5 与特征层次(K08-06/12)→ 破壁殿 AlexNet 三件套 ReLU/Dropout/GPU(K08-07)→ 叠核殿 VGG 小核堆叠与 1×1(K08-08/11)→ 分形殿 Inception 多尺度(K08-09)→ 视野殿分类/检测/分割三任务(K08-13/14/15)→ 深壁殿 FLOPs 账本、退化实证与注意力轻量化前路(K08-18/16/17)→ 残差之链 y=F(x)+x 破局(K08-10)。一句话总纲:三大假设让卷积用 9 个连接打全连接的 15 万个,架构演进一路往深走到 56 层撞上退化——那不是过拟合而是优化困难;残差连接把"学恒等"改写成"学零",深度从此不再有墙。