通联之道
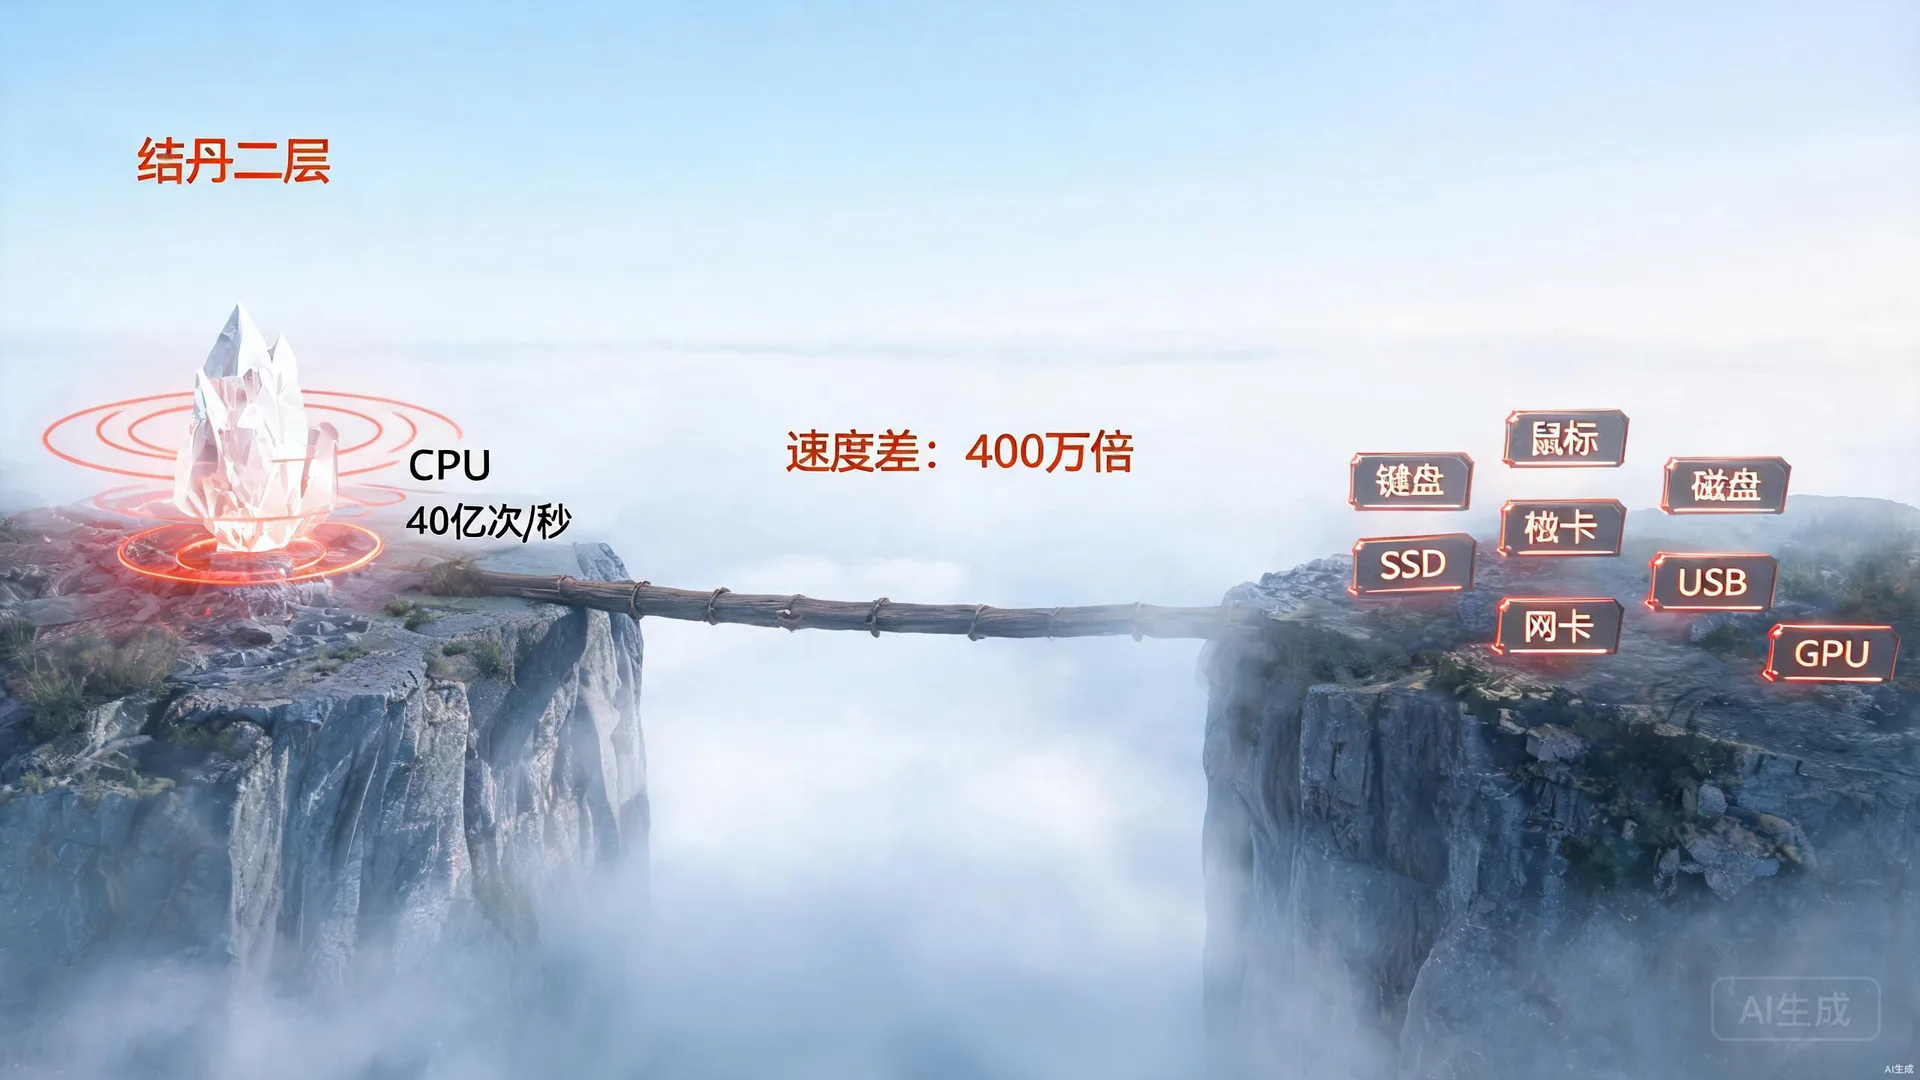
CPU 4 GHz,磁盘 8 ms——相差三千万倍。I/O 系统的全部意义,就是在一条时间不对等的桥上,让两端都能说话。
天堑之桥
桥从浓雾中伸出来——悬在两座悬崖之间的独木。左边一颗白色晶体以每秒四十亿次脉动,那是 CPU。右边散落着七块铭牌:键盘、鼠标、磁盘、SSD、网卡、USB、GPU,各自在自己的节奏里呼吸。
 诺依曼老祖
「你以为发个命令就过去了?这条桥上,时间不是同一条河。」
 中断之乱
「猜猜,CPU 4 GHz 和磁盘 8 ms 之间差多少倍?猜错了,我记一笔。」
IO 速度天堑预测挑战器
先下注猜倍率 → 再拖拽七块设备铭牌到速度谱上 → 切换对数标度
详解 · K10-01 I/O 系统的基本任务:跨越速度天堑
CPU 以纳秒计,外设以微秒到毫秒计——最快也差五个数量级。I/O 系统的三大任务由此而来:① 速度匹配(缓冲、缓存、批量传输,让快的不等死的);② 格式转换(串行↔并行、电平↔数据);③ 控制卸载(让 CPU 从「逐字节搬运」中解放)。本章的轮询、中断、DMA、通道四级演进,本质上都是围绕「谁等谁、等多久」这一个问题的答卷。
编址殿 · 两道门牌
桥的另一端是一座石殿,殿墙上开着两排门洞。左排刻着"内存域"——门牌号从 0x00000000 到 0xFFFFFFFF,整整齐齐。右排空着,门楣刻着"I/O 域——独立编址,专用指令"。
诺依曼老祖
「把设备铭牌挂上去。它需要一个地址,CPU 才找得到它。」
中断之乱
「不就是个地址嘛。你以为内存地址和 I/O 地址是一回事?」
双域门牌分配 + 总线信号示波器
拖拽设备寄存器到内存域 / I/O 域,用示波器对比两种访问周期
内存域(内存映射 I/O)
I/O 域(端口映射 I/O)
总线信号示波器
详解 · K10-02 两种编址:内存映射 vs 端口映射
内存映射 I/O(MMIO)把设备寄存器编进内存地址空间,load/store 直接读写设备——驱动可用任何访存指令与指针,还能享受内存保护;代价是吃掉一块地址空间,且必须小心编译器/CPU 的乱序与缓存优化(x86 用 MTRR/PAT 标记为不可缓存)。端口映射 I/O(PMIO)用独立的 I/O 地址空间与专用 IN/OUT 指令(x86 的 0x60 键盘、0x1F0 IDE 磁盘),不占内存地址、总线上用 M/IO# 信号区分两类周期;代价是指令专用、寻址能力弱。现代架构(ARM/RISC-V)几乎全押 MMIO。
轮询谷 · 空转的代价
石阶尽头是一条幽谷。谷中一台 CPU 晶体悬浮在半空,连着远处的外设。老祖说"不停地问",晶体开始闪烁:未就绪、未就绪、未就绪……四十万里路,每一里都在问同一句话。
中断之乱
「CPU 不停地问就行了呗。多简单。」
诺依曼老祖
「看看功率表。看看晶体表面。」
轮询循环代码拼装 + CPU 利用率仪表盘
拼出轮询循环 → 运行 → 观测 CPU 利用率与焦痕
详解 · K10-03 程序查询(Polling):效率怎么算
轮询的效率公式很直白:CPU 有效利用率 = 单次查询开销 / 设备服务间隔。4 GHz CPU 一次查询约 10 周期(2.5 ns),设备 1 ms 才就绪一次——利用率 0.00025%,空转 99.99975%。但轮询并非一无是处:当设备足够快(间隔与查询开销同量级)或系统无其他任务可调度时,轮询反而比中断省掉上下文切换的五步开销。高性能网络框架(DPDK)与自旋锁,正是主动选择轮询的场景——关键是算清这笔账再选边。
中断碑 · 第一声呼唤
焦黑的 CPU 还在冒烟。谷壁深处那声电铃越来越清晰。老祖带你走到一面石碑前——256 个格子,每个格子写着一个地址。"这叫中断向量表。外设准备好了,拉一下 IRQ 线——像拽铃铛。"
诺依曼老祖
「CPU 听见铃声,放下手里的活,按这张表找到该去哪儿。但得先把手头的活记下来——不然回来就忘了。」
中断处理五步流水线动画器
填中断向量表 → 单步/自动执行五步流程 → 对比轮询效率
轮询 vs 中断 效率对比
详解 · K10-04 中断驱动 I/O:向量表与五步流程
中断的硬件链条:外设拉 IRQ 线 → 中断控制器(PIC/APIC)仲裁 → CPU 在当前指令完成后响应。五步流程缺一不可:完成当前指令(指令级原子性)→ 保存现场(PC+状态寄存器压栈,否则回来就失忆)→ 查中断向量表(IRQ 号索引出 ISR 入口,x86 实模式 256 项)→ 执行 ISR(读数据、清中断标志)→ IRET 恢复现场。键盘 IRQ1、定时器 IRQ0、主 IDE 磁盘 IRQ14 是 PC 沿袭四十年的经典编号。中断把 CPU 利用率从 0.00025% 救回 ~99.9%,代价是每次铃声都有五步固定开销。
优先级塔 · 谁先被听见
碑面的噪音越来越大。键盘、磁盘、定时器、网卡——四个铃声同时响起,叠成一片刺耳的蜂鸣。一座七层石塔从地面升起,每一层对应一个优先级,越往上越急。
诺依曼老祖
「有的声音等得起,有的等不起——定时器晚了,整个系统的时钟就乱了。给它们排个序。」
中断之乱
「给所有中断同等待遇就行了。平等多好。」
优先级塔拖拽 + 中断嵌套追踪器 + 屏蔽字
拖设备到塔层 → 触发嵌套中断 → 观察 ISR 栈
ISR 嵌套栈
中断屏蔽字
详解 · K10-05 中断优先级与嵌套
优先级解决「同时拉铃听谁的」:高优先级中断可以打断正在执行的低优先级 ISR——这就是中断嵌套,栈里会压入多层现场。中断屏蔽字(IMR/优先级阈值寄存器)则是软件侧的闸门:置位即屏蔽对应级别,常用于保护临界区。定时器必须最高级——它晚了,系统时钟漂移、调度失序;键盘、磁盘可以等。但分级不是万能药:当优先级遇上共享资源,就会迎来 S6 的反转死链。
总线关 · 三脉归一
塔的影子带你来到一座关隘——所有设备到 CPU 的路都汇到这里。三股力量在流动:数据、地址、控制信号。关隘上方悬着两块令牌:一块刻"同步",一块刻"异步"。
诺依曼老祖
「这就是总线。三条脉——CPU 和所有外设共享这一条路。」
总线三脉归一三旋钮实验台
选总线类型 → 切同步/异步 → 调频率/握手延迟 → 看示波器
总线信号示波器
详解 · K10-08/09 总线:三条脉与两种节拍
总线按功能分三脉:数据总线(位宽决定单次搬运量,32 位一次 4 字节)、地址总线(位宽决定可寻址空间)、控制总线(读写使能、中断请求、仲裁信号)。按节拍分两派:同步总线所有设备共享时钟,设计简单、吞吐高,但周期必须迁就最慢设备——时钟一快,慢设备采样全错;异步总线用 Request/Acknowledge 握手(全互锁四次握手最稳),快慢设备自由混挂,代价是每次传输多付握手延迟。带宽估算:32 位 × 200 MHz ÷ 8 = 800 MB/s——位宽与频率就是总线的全部本钱。
风暴眼 · 优先级反转
风暴从总线缝隙里渗出来。数百个中断信号同时涌入,在总线上挤成一团。CPU 晶体上的焦痕在风暴中开始发红。"低优先级拿着总线的锁。高优先级要总线。它在等。但中等优先级来了——它抢 CPU 时间。三个任务,一条死链。系统——停了。"
中断之乱
「高优先级永远不会被低优先级阻塞?你押上这条信念——我现在当面砸碎它。」
中断风暴 + 优先级反转时间线 + Pathfinder 案例
观测中断风暴 → 推演三任务死链 → 重演火星探路者号
优先级反转推演
Mars Pathfinder 1997
VxWorks RTOS:低优先级气象任务持总线锁,高优先级总线管理任务被阻塞,看门狗超时复位。
详解 · K10-05 进阶 优先级反转与优先级继承
死链三幕:低优先级任务 T_low 持锁 → 高优先级 T_high 等锁被阻塞 → 中优先级 T_mid 抢占 T_low——T_high 实际被 T_mid 间接压制,优先级名存实亡。1997 年 Mars Pathfinder 在火星上反复看门狗复位,地面团队远程打开调试日志才定位到总线任务的优先级反转,修复方案是优先级继承:持锁的低优先级任务临时继承等待者的优先级,T_low 借 T_high 的优先级跑完临界区、放锁、被打断——死链断开。VxWorks 事后通过补丁开启了默认关闭的继承开关。备选方案还有优先级天花板协议(锁自带优先级上限),实时系统必修课。
DMA渊 · 借道者
暗道通向一处深渊。深渊底部有一个独立的晶体——不是 CPU,比 CPU 小,但它的手直接伸向了内存和外设。"DMA 控制器,它只做一件事——搬数据。CPU 给它一个地址、一个长度、一个方向,它就去搬。"
诺依曼老祖
「它要搬数据,就得用总线。CPU 也在用总线。谁让谁?这叫总线仲裁。」
DMA 参数配置 + 三种传输模式 + 四种总线仲裁
配置 DMA 四参数 → 切换三种模式 → 比较四种仲裁方案
四种总线仲裁方案
详解 · K10-06 DMA:三种传输模式
DMA 控制器拿到四参数(源地址、目的地址、长度、方向)后独立搬运数据,全程只在启动与完成时打扰 CPU。三种模式是总线占用策略的权衡:突发模式一次传完,效率最高但 CPU 长时间失去总线;周期窃取每传一个字就把总线还给 CPU 一个周期,透明平滑、双方折中;透明模式只在 CPU 不使用总线的间隙传输,对 CPU 零影响但速度受制于空闲窗口。磁盘读写、网卡收包、显存搬运——凡是成块的数据,都走 DMA。
详解 · K10-07/10 总线仲裁:谁说了算
DMA 与 CPU 争总线,需要仲裁。集中式三策:菊花链(授权信号逐级串传,结构简单但靠前设备永远优先,不公平)、轮询仲裁(仲裁器轮流询问,公平但响应慢)、独立请求(每台设备专线 BR/BG,并行裁决最快,成本是线数翻倍)。分布式仲裁(如 CAN 总线的逐位线与竞争)没有中心仲裁器,设备靠总线电平自行比出优先级,可扩展性最好。仲裁的本质问题只有一个:当多个主设备同时要路权,谁让谁、多快决定。
通道阁 · 卸下重担
阁楼里没有 CPU 的位置。一排小型处理器——通道——各自运行着长长的指令序列。另一侧,一条串行链路上挂着一串设备,热插即用。"USB,现代 I/O 的标准接口。CPU 只管发'枚举设备',剩下的事 USB 控制器自己办。"
诺依曼老祖
「CPU 给通道发一条命令——不是'搬这一个字节',而是'执行这整段程序'。然后 CPU 就走了。」
通道程序 + 四种 I/O 控制方式对比 + USB 探索
拼通道程序序列 → 对比四种方式 CPU 占用率 → 探索 USB
四种 I/O 控制方式 CPU 占用率
USB 协议探索
详解 · K10-13 通道与 I/O 处理器:把程序也外包
通道(Channel)是 DMA 的完全体:DMA 只能执行「搬这一块」的单条命令,通道能执行一整段通道程序——读状态、设参数、启动传输、校验、发中断,全序列自主完成。CPU 的角色从逐条指挥退到一句「执行这段程序」。大型机的 Channel Subsystem、现代智能网卡(SmartNIC/DPU)里的可编程引擎,都是通道思想的直系后裔:I/O 处理器越聪明,CPU 越像元帅。
详解 · K10-11 USB:串行总线的统一帝国
USB 用一对差分串行线统一了键盘、鼠标、存储、音频的接口:树形拓扑 127 设备、热插拔、主机自动枚举(分配地址、读描述符、配驱动)——设备的「自我介绍」协议是 USB 的灵魂。速率从 1.1 的 12 Mbps 到 USB4 的 40 Gbps,跨越三千多倍,但主机调度、帧结构的框架未变。串行取代并行是物理层的必然:并行走线多时钟偏移(skew)随频率致命,差分串行反而能上高频。
Boss 战 · 中断之乱
风暴凝聚成一个人形——无数中断信号纠缠的红色涡旋,涡旋中心有两只眼睛。它手里握着一本账。"你在桥上走了十级台阶。每一级,你都在低估我。"
中断之乱
「三问。答对,我散。答错,从 S3 重走。但你的断痕——不会消失。」
渊账累计 0 笔 · 三问全对后清零
通联之道 · I/O 墙
风暴散尽。远方天际线上,一条比独木桥宽百倍的路正在延伸。路边立着两块碑:一块刻"RAID"——多块磁盘拼成阵列,为速度、为可靠;一块刻"PCIe/NVMe"——串行通道取代并行总线,固态存储摆脱机械枷锁。
诺依曼老祖
「你走过了轮询、中断、DMA、通道。但 I/O 的故事远没结束。CPU 越快、外设越杂,I/O 墙只会更高。」
通联之道 · 12 知识图谱节点点亮
点击节点点亮知识链 → 探索 RAID / PCIe / NVMe
RAID 级别可视化
PCIe 带宽计算器
NVMe vs AHCI 队列对比
详解 · K10-14 RAID:用冗余买可靠性
单盘 MTBF 有限,N 盘全串行可靠度相乘只会更差——RAID 的思路是把冗余设计进阵列:RAID 1 镜像(容量 50%,坏一块无损);RAID 5 分布式校验(XOR 校验条带轮换存放,容量 (N−1)/N,坏一块可由其余盘异或重建);RAID 6 双校验(Reed-Solomon,坏两块仍可重建);RAID 10 先镜像再条带,性能与冗余各付一半。RAID 0 只是条带化提速,没有冗余——坏一块全阵列报废,它不配叫「冗余阵列」。
详解 · K10-15 PCIe/NVMe:I/O 的近代史
PCIe 用点对点串行 lane(128b/130b 编码)取代共享并行 PCI 总线:带宽 = 速率 × lane 数 × 128/130 ÷ 8,PCIe 4.0 ×16 ≈ 31.5 GB/s,且每 lane 独享不必仲裁。NVMe 则是为闪存重写的协议:AHCI 为机械盘设计,1 队列 × 32 深度;NVMe 支持 64K 队列 × 64K 深度,多核各自提交互不锁——SSD 的并行性第一次被喂饱,延迟从 ~100 μs 压到 ~10 μs。总线(PCIe)与协议(NVMe)双升级,才把存储从毫秒时代带进微秒时代。
详解 · K10-12 I/O 性能分析:瓶颈永远在最低环
I/O 性能分析的第一定律:系统吞吐量 = min(CPU 处理率、总线带宽、设备服务率),瓶颈之外的一切优化都是浪费。排队论给出第二把尺:设备利用率 ρ = 到达率 × 服务时间,ρ→1 时延迟趋向无穷——所以 I/O 系统不能跑满,磁盘利用率过 70% 就该扩容。实战顺序永远是先测量(iostat/perf 找瓶颈环)、再优化(换快设备、加队列深度、改批量),而不是反过来。这就是本章所有技术的使用说明书。