资源御灵
你以为多进程共享资源就行。但死锁、竞态、饥饿让并发编程成为深渊。操作系统的灵魂不是管理充裕的资源——是承认资源永远不够。
资源殿
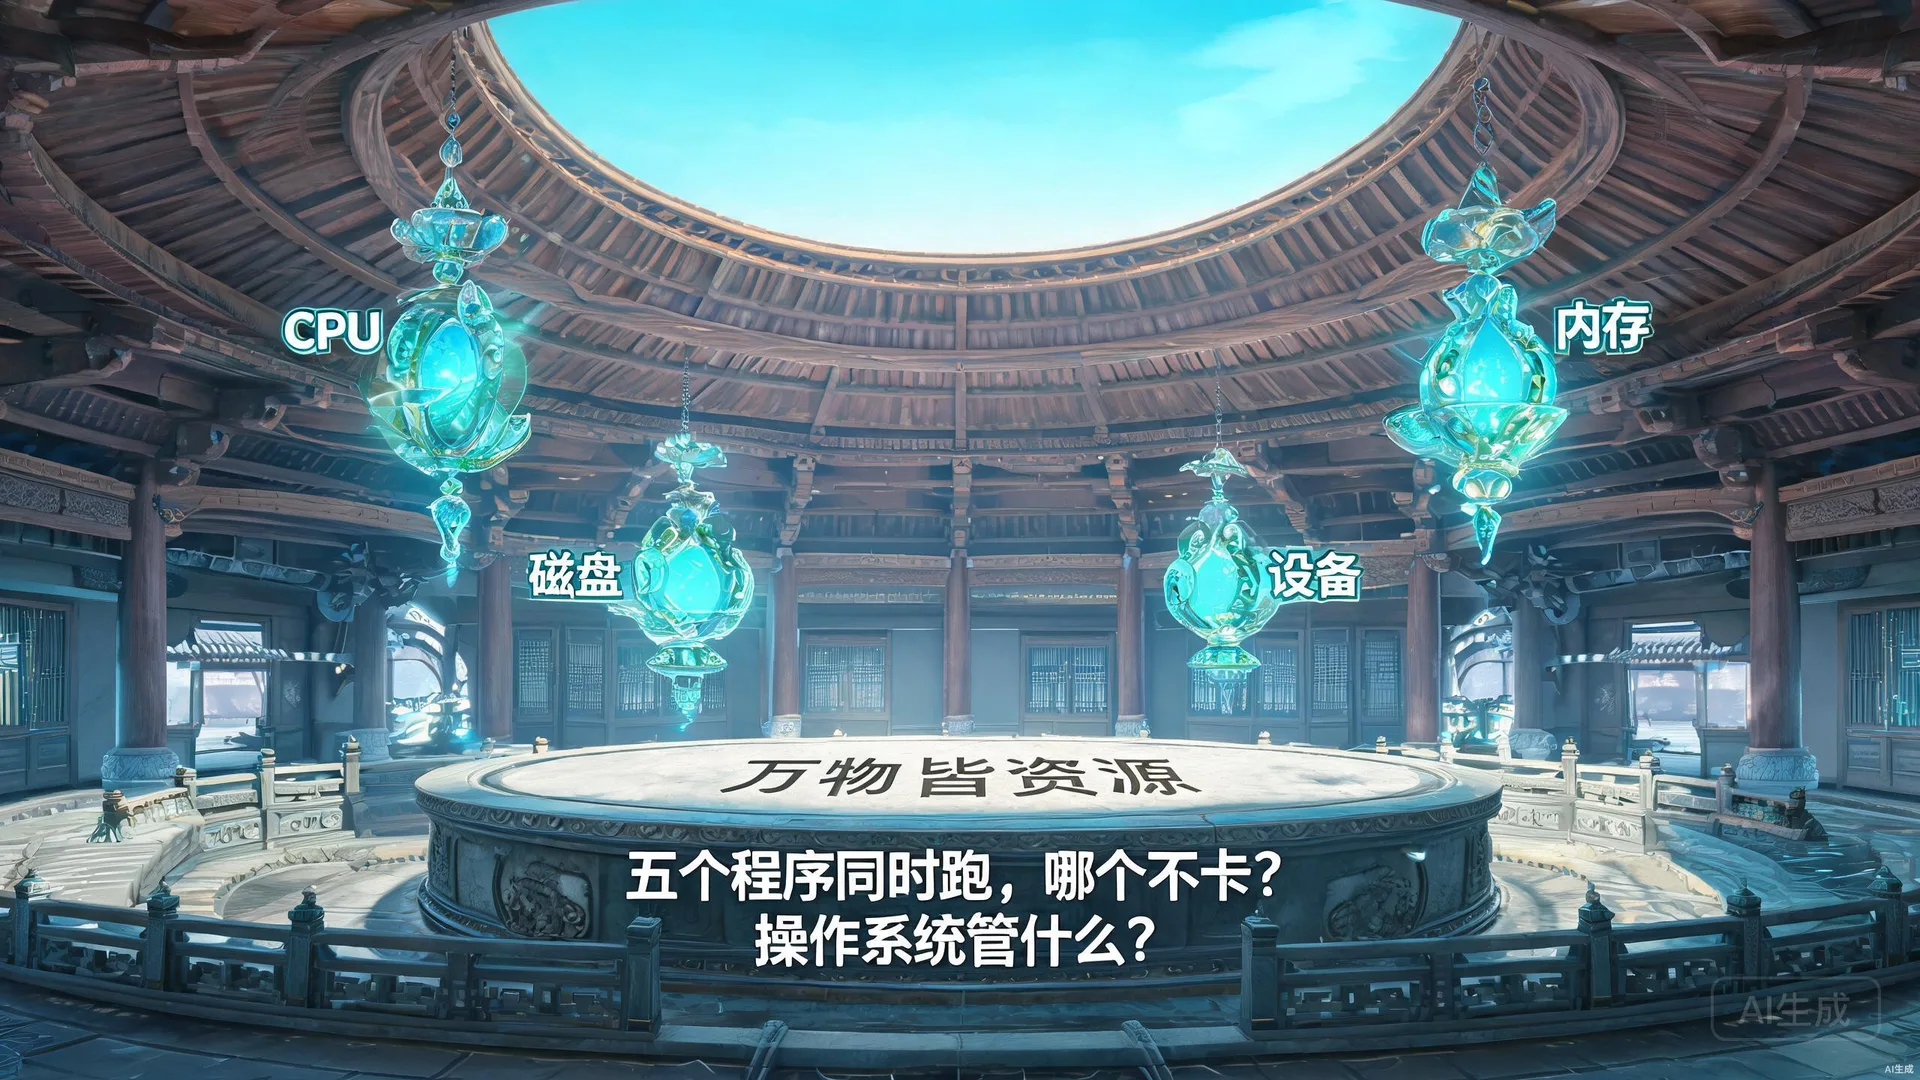
资源殿穹顶悬着四盏法器灯:CPU、内存、磁盘、设备,各泛着冷光。殿中央是一座环形祭坛,坛上刻着四个字——"万物皆资源"。
 诺依曼老祖
「操作系统是御灵者。它分配、调度、隔离、保护——让无数进程在一具肉身上共存。」
 死锁之环
「简单。开五个程序,资源够用的。赌不赌?」
资源够用预测挑战器
反直觉下注(五选一,可连错)→ 资源占用全景拼合 → OS演进时间轴
资源占用全景 · 四类资源全部爆满
OS演进时间轴 · 每一代都在回答"不够,怎么分?"
详解 · K17-01 操作系统的基本功能与角色:资源管理者/抽象提供者
Tanenbaum《现代操作系统》Ch1 给了操作系统两副面孔:自顶向下,它是「扩展机器/抽象提供者」——把裸的中断、磁盘、寄存器抽象成进程、文件、虚拟内存这些干净的接口;自底向上,它是「资源管理器」——仲裁 CPU、内存、I/O 的争夺。Silberschatz《操作系统概念》Ch1 则称它为控制程序:管理用户程序的执行,防止错误与计算机的不当使用。这个双重身份的硬件基础是 CPU 的双态:内核态/用户态由保护位区分(Motorola 68000 于 1979 年引入管理态/用户态,x86 演化为 ring0-ring3),定时器则是最后的底线——否则一个死循环就能永远独占 CPU。系统调用(S7 的 trap 之门)是两态之间唯一的合法通道。台上五程序全景的账目——CPU 220%、内存 200%、I/O 250%、带宽 175%——说明需求总和永远大于供给,抽象掩盖了争夺,但争夺不会消失,OS 每一次分派都是一次裁决。「万物皆资源」还有后半句:OS 把裸铁变成虚拟机——每个进程都以为自己独占 CPU 与内存,这份错觉的管理,就是操作系统的本职。
详解 · K17-02 操作系统的演进:批处理→分时→实时→分布式
时间轴上每一代都有原始出处。批处理:1956 年 GM-NAA I/O 监督程序(为 IBM 704 而写),作业成批上卡带,CPU 却常在等磁带——利用率是那个年代最疼的数字。多道程序:IBM System/360 于 1964 年发布,研发投入逾 50 亿美元(超过曼哈顿计划),OS/360 的多道程序让 I/O 与 CPU 重叠,Fred Brooks 的《人月神话》即诞生于此项目。分时:MIT 的 CTSS 在 1961 年 11 月公开演示,把改装的 7094 分给数十名用户同时交互,响应进入秒级;后继 Multics(1964-1969)带来环形保护与层次文件系统,贝尔实验室 1969 年退出后,Thompson 与 Ritchie 在一台 PDP-7 上写出了它的极简后继——Unix。实时:RT-11(1971)开先河,VxWorks(Wind River,1987)统治嵌入式,硬实时要求可调度性证明而不只是「够快」。分布式:Google Borg 约 2003 年上线(EuroSys 2015 论文公开细节),其开源后裔 Kubernetes 2014 年发布,把资源管理扩展到机群。演进的答案各不相同,问题从未变过:不够,怎么分——先分时间(批处理/分时),再分空间(多道程序),再要确定性(实时),最后跨机分(分布式)。
进程阁 · 状态之轮
阁中央悬着一架巨大的状态轮:就绪、运行、阻塞三盏灯,被箭头连成环。轮下排着五个进程晶核。
诺依曼老祖
「进程是运行中的程序。程序是死的,进程是活的——它有状态、有身份、有上下文。开五个,看看会怎样。」
死锁之环
「开嘛。五个一起跑。资源够用的。」
进程状态轮转模拟 · 上下文切换实验台
激活五进程 → 状态轮转 → 切换频率滑块(CPU利用率先升后降)→ PCB解剖
PCB解剖 · 进程控制块
详解 · K17-03 进程(Process)的概念与状态转换
进程是执行中的程序(Silberschatz Ch3):代码是静态的尸体,进程是代码+数据+堆+栈+PCB 的活体,有身份、有现场、有历史。内存布局:正文段、数据段(.data 存初值、.bss 存零初始化)、堆向上生长(brk/mmap)、栈向下生长,堆栈之间的空隙就是虚拟内存表演的舞台。状态机完整版是五态(新建/就绪/运行/阻塞/终止),台上状态轮画的是中间三态,但四条转换一条不能少:就绪→运行叫分派(dispatch),运行→就绪叫剥夺(时钟中断强制),运行→阻塞是主动的(等 I/O 不可剥夺),阻塞→就绪在 I/O 完成时发生——注意关键不对称:阻塞态禁止直达运行态,I/O 完成后进程必须回就绪重新排队,CPU 不欠它的。点晶核轮转时 readout 报的就是这三条。Unix 的 fork() 复制 PCB 与地址空间(现代实现是写时复制 COW,只拷页表),exec() 换身加载新程序——两步分离的设计给 shell 留下在 fork 与 exec 之间改重定向、接管道的空隙,这是「一切皆组合」的哲学起点。进程创建以 ms 计,状态转换以 μs 计——量纲差三个数量级,调度才玩得起。
详解 · K17-04 进程控制块(PCB)与上下文切换
PCB(Silberschatz Fig 3.5)是进程的灵魂档案:PID、程序计数器 PC、寄存器组、CPU 调度信息(优先级/队列指针)、内存管理信息(页表基址寄存器 PTBR、段表指针)、I/O 状态列表、打开文件表、信号掩码——台上 PCB 解剖卡的 8 个字段与此一一对应。上下文切换 = 旧 PCB 写回内存、新 PCB 读入寄存器,其间 CPU 不做任何用户工作,是纯开销。代价分两层:直接代价是寄存器与内核栈的保存恢复,数百至数千个时钟周期,Linux x86-64 实测约 1-3μs;间接代价是缓存变冷——旧进程的 cache 行与 TLB 表项对新进程全是废物,TLB 全刷的锅由 ASID/PCID 地址空间标签来背。切换频率 f 与利用率构成先升后降曲线:f 太小进程轮不上,f 太大 CPU 全在存档读档。台上的模型 util = 90·(f/30)·e^(1−f/30) 在 f=30 处取峰值 90%——把 freq 拖过 60,利用率跌回 55% 以下,PCB 解剖卡弹出,刻痕①落下:任何权衡的最优点都在中间,这是「资源管理的艺术」第一次定量现身。
调度场 · 公平之妄
调度场是一片开阔的石台,台面刻着五道调度符文。台边立着一排进程——有长有短,有急有缓。
诺依曼老祖
「CPU只有一个,进程有六个。谁先跑?你选一种调度,看看公不公平。」
死锁之环
「公平嘛。先来先服务,天经地义。选它。」
调度五算法推演器
线程切分 → 五算法符文切换 → 甘特图实时模拟 → 平均等待/周转时间 → 三种公平崩塌
详解 · K17-05 线程(Thread)的概念:用户级线程vs内核级线程
线程是调度的最小单位(Silberschatz Ch4):同进程内线程共享代码、数据、堆与打开文件,但各自保有 TID、PC、寄存器组与栈——台上分灵刀的八字口诀「共享内存 · 各有栈」就是定义本身。共享的红利:线程切换不必换页表基址、不必刷 TLB,同进程切换比进程切换快一个数量级;线程通信直接读同一块内存——但这正是 S8 竞态的祸根,共享即风险。用户级线程(ULT)的切换完全在用户态线程库里完成,内核甚至不知道线程存在,代价约几十 ns,但一个线程发起阻塞系统调用就拖死全进程(多对一模型的死穴);内核级线程(KLT)由内核直接调度,多核上真并行,切换要过 trap,μs 量级(一对一模型,Linux NPTL、Java 默认)。多对多模型试图两全——Go 的 goroutine/GMP 调度器就是当代最成功的实现。Tanenbaum Ch2 的经典例证:文本编辑器拆成键盘输入、自动保存、界面渲染三个线程,任何一个阻塞都不拖死其余。切出三线程再进调度场,你会看到同一套算法作用在更轻的单位上——公平问题不变,代价变小。
详解 · K17-06 CPU调度算法:FCFS/SJF/RR/优先级/多级反馈队列
台上六进程(burst 20/4/6/3/8/30 ms,到达 0-5 ms)全部可手算验证(Silberschatz Ch6)。FCFS:P1→P6 依到达序,平均等待 22.2ms、平均周转 34.0ms——护航效应就是 P1 的 20ms 挡住身后所有人。SJF 非抢占:可证平均等待最优(相邻交换论证),前五进程平均周转降至 26.8ms,但 burst=30 的 P6 饿死;burst 无法预知,实践中用指数平均预测:h(n+1)=α·t(n)+(1−α)·h(n),α 常取 1/2。RR(时间片 q=4ms):平均等待 21.2ms;q 的选择是权衡——切换开销 s 为 μs 量级,q 过小则 s 占比爆炸,q 过大退化为 FCFS,典型 q=10-100ms 让开销占比压在千分之一以下。优先级调度:平均等待 17.0ms 五法最优,但优先级反转借火星探路者号(1997)名垂青史——低优先级持锁、高优先级等锁、中优先级抢 CPU,解法是优先级继承。MLFQ(Corbato 1962 为 CTSS 发明):时间片 4/8/16ms 三级降级,新进程入最高级,用完降级,I/O 型天然留在高优先级——在不知道 burst 的前提下逼近 SJF,平均等待 21.8ms。没有冠军,只有目标函数:吞吐、周转、响应、公平,各要各的命。
实时钟 · 截止之刃
石台尽头是一座倒计时钟塔,塔面嵌着多个任务,每个任务都带一个红色截止刻度。
诺依曼老祖
「这些不是普通进程。刹车、气囊、心脏起搏器——迟一毫秒,就是一条命。RM按周期分配优先级,EDF按截止期最近优先。选一种,看看能不能让它们全部准时。」
实时调度模拟器 · RM/EDF双模式
RM试炼(U=0.958超充分上界0.780,T3错过截止期)→ EDF试炼(上界1.0,全部准时)→ 过载实验(U>1,EDF也错过)
详解 · K17-07 实时调度:Rate Monotonic/Earliest Deadline First
Liu 与 Layland 1973 年在 J.ACM 的一篇论文里同时奠定两个算法。RM(速率单调):静态优先级,周期越短优先级越高——周期短意味着请求更密、更「急」。充分可调度条件 U ≤ n(2^(1/n)−1):n=1 时上界 1.0,n=2 时 0.828,n=3 时 0.780,n→∞ 时收敛到 ln2≈0.693。台上任务集 (T=4,C=1)(6,2)(8,3) 的 U = 1/4+2/6+3/8 = 0.958,超过 0.780——但上界只是充分条件,精确判定用响应时间分析:R3 = C3 + Σ⌈R3/Tj⌉·Cj = 3 + ⌈R3/4⌉·1 + ⌈R3/6⌉·2,迭代 3→6→7→9→10 收敛于 R3=10,大于截止期 D3=8,T3 确实错过——台上 RM 模式的 ✗ 就是这么算出来的。EDF(最早截止期优先):动态优先级,谁的截止期近谁抢占;单处理器抢占式 EDF 可证最优——U≤1 即可调度,同一 0.958 的任务集全部准时,这就是「RM 天花板比 EDF 低」的严格含义。代价是每拍都可能重排优先级,队列维护与抢占开销更大。按下过载按钮加 T4(10,4):U=1.358,连 EDF 也全线错过——利用率超过 1 是物理矛盾,任何算法都造不出 CPU 时间。实时调度的第一课不是更快,是承认上限。
内存域 · 分而治之
内存域是一片悬浮的方格阵列,每一格是一个内存页框。域中央有三座分配法器:连续分配柱、分页塔、分段阁。
诺依曼老祖
「进程要占内存。怎么分?连续分配最直觉——但会碎。分页最整齐——但要查表。分段最贴合程序——但也会碎。你试。」
内存分配三法器 · 虚拟内存映射
连续/分页/分段切换 → 碎片可视化 → 虚拟页→物理页框映射 → 缺页中断
虚拟内存 · 页表映射 + 缺页中断
详解 · K17-08 物理内存管理:连续分配/分页/分段
连续分配(Silberschatz Ch9 / Tanenbaum Ch3):固定分区(OS/360 MFT)在分区内浪费,动态分区配 first/next/best/worst fit——Knuth 1965 年对分配策略做过系统分析,best fit 反而碎片更多,first-fit 平均表现不差;外部碎片靠压缩(compaction)整理,但搬迁代价大且要求地址可重定位。分页把物理内存与地址空间都切成等大的帧/页(典型 4KB=2^12 字节),虚拟地址拆成(页号 p,页内偏移 d),偏移恰是地址低 12 位。页表多大?32 位地址空间 + 4KB 页 → 2^20 个页表项,每项 4B → 每进程页表 4MB,比很多进程本身还大——于是两级页表登场:10 位外层 + 10 位内层 + 12 位偏移,外层表仅 4KB 常驻,内层表按需分配,稀疏地址空间几乎不占内存(64 位则用三/四级)。查表即一次额外访存,TLB 快表救场——台上勾选框的手算:无 TLB 时 EAT = 2×100ns = 200ns;TLB 命中率 98%、查找 20ns 时 EAT = 0.98×120 + 0.02×220 = 122ns。分段按逻辑单位切(代码/数据/栈,x86 的历史遗产),段表存(基址,限长),贴合程序员视角、支持按段共享保护,但段长不等又生外部碎片——三座法器的碎片形态各不相同,没有免费的午餐。
详解 · K17-09 虚拟内存的OS管理:置换策略/工作集/内存映射文件(mmap)
请求分页的第一次工程落地是曼彻斯特 Atlas 计算机(Kilburn 团队,1962)——把「一级存储」的幻觉卖给程序员。缺页流程即台上六步:MMU 查 present 位为 0 → 陷入内核 → 校验地址合法 → 找空闲帧(没有就先置换一页)→ 发磁盘 I/O 读入 → 更新页表 → 重新执行被中断的指令。「可重新执行」是硬约束,指令的副作用必须能回滚。代价账(Silberschatz Ch9):访存约 100ns,缺页服务约 8ms(寻道+旋转+传输),差 10⁵ 倍——缺页率 p=0.001 时 EAT ≈ 0.999×0.1μs + 0.001×8ms ≈ 8.1μs,慢 81 倍;要把性能损失压在 10% 以内,p 必须低于百万分之一点二五。所以置换策略之外还要工作集模型(Denning 1968):以 Δ 为窗口统计活跃页集合,各进程工作集之和一旦超过物理内存就进入抖动——S5 的深渊正是这里的续集。mmap 把文件直接映射进地址空间:读文件变成访内存,缺页驱动磁盘读入,msync 写回,省掉 read/write 在用户缓冲与内核缓冲之间的双份拷贝——零拷贝的思想源头,也是动态链接库共享正文段的机制。虚拟内存的魔术费写在井壁上:用不到的页在磁盘上,用到时才调回来。
置换渊 · 抖动之痛
置换渊是一口深井,井壁嵌满了内存页框。井底是磁盘——换出去的页沉下去,换回来时再浮上来。井沿刻着四种置换符文。
诺依曼老祖
「内存只有3个页框。进程要访问7个页。换谁出去?选一种。」
死锁之环
「换出去再换回来嘛,能有多难?选FIFO,简单的。」
置换曲线追踪器
四算法切换 → 帧数滑块(Belady异常检测)→ 缺页计数 → 抖动实验
抖动实验 · 并发进程数 vs CPU利用率
详解 · K17-10 页面置换算法:FIFO/LRU/Optimal/Clock
台上访问序列 1,2,3,4,1,2,5,1,2,3,4,5 正是 Silberschatz Ch9 教材里演示 Belady 异常的那条经典串。3 帧手算:FIFO 缺页 9 次(命中率 25%),LRU 10 次,Optimal 7 次;加到 4 帧:FIFO 反而升到 10 次——1969 年 Belady、Nelson、Shedler 在 IBM System/360 的实测中发表了这一反例,帧多缺页反多,直觉彻底破产。LRU 永不得此病:它是栈算法——n 帧的内存集恒为 n+1 帧内存集的子集,单调性天然免疫 Belady;但精确 LRU 要求每次访问都更新时间戳或维护访问序链表,通用硬件极少提供(x86 只给 accessed/dirty 两个位),所以工程上用 Clock 二次机会近似:页排环形队列,引用位在命中时置 1,指针扫过 1 就清零放行,遇 0 者淘汰——行为介于 FIFO 与 LRU 之间(台上曲线 3 帧 9 次、4 帧同样 10 次,此串上也非单调,近似终究是近似)。Optimal(Belady MIN)淘汰「未来最久不用」的页,需要预知未来,不可实现,只作下界基准:7 次/6 次。FIFO 与 OPT 的差距是算法的空间,LRU 与 OPT 的差距是现实的代价。帧数滑块拖过临界点,抖动曲线告诉你终极惩罚:置换救得了缺页,救不了工作集超卖。
文件塔 · 持久之器
文件塔是一座层叠的石塔,每一层是一块磁盘盘面,盘面上布满扇区。塔基立着三座分配法器。
诺依曼老祖
「进程死了,文件还在。怎么存?怎么找?怎么读得快?」
文件分配三法 + 磁盘调度四算法
连续/链接/索引分配 → inode解剖 → FCFS/SSTF/SCAN/C-SCAN磁头移动
inode解剖 · 文件的身份卡
磁盘调度 · 磁头从53柱面出发
详解 · K17-11 文件系统基础:文件组织/目录结构/文件操作
文件是 OS 提供的最小持久化抽象单元:有名字、可读写、可共享、寿命长于创建它的进程——台上那句「进程死了,文件还在」就是定义。open("/usr/a.txt") 的完整旅程(Silberschatz Ch11):路径逐段解析——目录本身也是文件,内容是「文件名→inode 编号」的映射表;跨挂载点时跳到另一设备的超级块。找到 inode 后做权限校验(rwx 三组 9 位,外加 setuid/setgid/sticky)。然后在进程级打开文件表分配一个 fd 表项,指向系统级打开文件表(存偏移量与访问模式),后者再指向 v-node 表(存 inode 内容)——三层结构使 dup() 出的两个 fd 能共享同一偏移量,而两次独立 open 各有各的偏移。之后的 read/write 只拿 fd 做数组下标,O(1) 直达。目录实现从线性表演化到 B 树/哈希(ext4 的 htree、NTFS 的 B+ 树),万级文件的目录不再线性扫描。硬链接是同一 inode 的多个目录项,i_nlink 计数;删文件的本质是 unlink——计数减一,归零且无人打开才真正释放磁盘块。软链接(symlink)自身是一个存路径字符串的小文件,可跨设备、可指向目录、可悬空——两种链接的区别,就是「名字指向实体」与「名字指向名字」的区别。
详解 · K17-12 文件分配方式:连续/链接/索引/FAT/ext4
文件塔三法器对应 Silberschatz Ch12 三式。连续分配:目录项 = (起始块, 长度),随机访问一次乘法搞定,顺序读可整段预取;但外部碎片让文件长不大——今天只剩 3 块分散空闲,文件要长 4 块就无家可归,故现代只用于只读场景(光盘镜像、系统安装器)。链接分配:每块头部存下一块指针,文件可无限长、无外部碎片;但随机访问要 O(n) 顺藤摸瓜,且指针本身每块吃掉 4-8B。FAT 把整张链表提到盘首集中存放(MS-DOS 1981;FAT12/16/32 的名字即簇号位宽,FAT32 实际用 28 位):FAT 小到可整表缓存进内存,摸瓜变成查表——代价是 FAT 单点损坏全盘皆输、且无权限概念,故 NTFS/ext 取而代之。索引分配:每文件一个索引块,4KB 块 + 4B 指针 → 单层索引最多 1024 项 = 4MB;Unix inode 用 12 直接 + 一/二/三级间接(台上解剖卡的字段清单):12 + 1024 + 1024² + 1024³ 块,4KB 块下最大文件约 4TB+——小文件 12 个直接指针即中,大文件逐级展开,一种结构吃两头,间接层就是空间税。ext4 改用 extent(起点+长度)描述连续区段,配延迟分配与 JBD2 日志,大文件性能与崩溃一致性双双翻身。
详解 · K17-13 磁盘调度算法:SSTF/SCAN/C-SCAN
HDD 访问时间三段:寻道(磁头臂移动,ms 量级、占比最大)、旋转等待(7200rpm 转一圈 8.33ms,平均半圈 4.17ms)、传输(μs 量级)——磁盘调度的目标几乎只剩一个:最小化总寻道距离(Silberschatz Ch12)。台上经典队列:请求 98,183,37,122,14,124,65,67,磁头起始于 53 柱面,盘面 0-199。手算四条轨迹:FCFS 忠实按到达序,总移动 640 柱面;SSTF 贪心取最近——65→67→37→14→98→122→124→183,总移动 236,省了 63%,但远端请求可能被无限插队(饥饿,调度场的老病复发);SCAN 电梯算法先上行扫到盘端 199 再折返:65→67→98→122→124→183→199→37→14,总移动 331,中部柱面每轮被服务两次,等待方差小于 SSTF;C-SCAN 只单向服务,到 199 后快速归零再从头上行:…→199→0→14→37,总移动 382——多花 51 柱面买所有柱面近乎均匀的等待时间。LOOK/C-LOOK 是工程变体:到最后一条请求就折返/归零,不跑空盘端。SSD 时代寻道物理性消失,NVMe 有数万条硬件队列,经典算法集体退役——Linux 块层只剩合并、公平与 QoS(mq-deadline/BFQ/kyber),但「减少昂贵动作」的思想原样搬进了缓存与网络。
设备阵 · 内核之门
设备渊是一条向下延伸的通道,尽头是一扇刻着"内核"二字的巨门。通道两侧悬着各种设备。
诺依曼老祖
「用户程序在门外,硬件在门里。这扇门,叫系统调用。CPU有两种姿态——用户态和内核态。门只朝一个方向开。」
设备管理 · 系统调用 · 内核架构
三法I/O对比(CPU占用率)→ trap穿越动画 → 宏/微内核光谱滑块
系统调用 trap 演示 · 点击 read()
内核架构 · 性能↔安全光谱
详解 · K17-14 设备管理:设备驱动程序与I/O子系统
I/O 子系统是分层的洋葱(Silberschatz Ch13 / Tanenbaum Ch5):用户层(printf)→ 库函数 stdio(用户态缓冲)→ 系统调用 read/write/ioctl → 内核 I/O 调度层 → 设备驱动 → 中断处理 → 硬件控制器。设备独立性由驱动统一接口实现:内核把块设备都看作块数组,用主/次设备号标识(/dev/sda 主号 8),open 一个设备文件就是打开一条通往驱动的路。台上 CPU 占用率对比是三代演进:程序化 I/O 让 CPU 忙等设备状态寄存器(轮询,95% 白烧);中断驱动让 CPU 发令后去干别的,设备完成时举中断(15%——但每块数据一次中断仍有开销);DMA 让控制器直接搬运内存,CPU 只参与「设置命令」与「完成中断」两次(3%)。DMA 与 CPU 争内存总线叫周期窃取(cycle stealing),成批搬运则是突发模式。IBM System/360(1964)的 I/O 通道更进一步——能执行通道程序的协处理器,是今天 SmartNIC/DPU 的祖师爷。中断分上下半部:上半部关中断只保存现场、置标志,下半部(Linux 的 softirq/tasklet/workqueue)慢慢做重活,网卡收包的 NAPI 还会在风暴期关中断改轮询——轮询与中断,绕一圈又成了混合体。
详解 · K17-15 系统调用(System Call)的机制与分类
三个概念要分开:API 是你调的接口(POSIX 的 open/read),库函数(glibc)负责装参数与发起调用,系统调用是内核的服务入口本身。穿越机制即台上 trap 五步:x86-64 用 syscall 指令——服务号放 rax,硬件自动把返回地址存 rcx、标志存 r11,跳到 MSR_LSTAR 预设的内核入口;32 位老路是 int 0x80 软中断,ARM 是 svc。本质都是软件触发的陷入:硬件切到内核态,内核按系统调用表(sys_call_table)索引服务例程,执行完 sysret/iret 回用户态。代价 = 模式切换 + 特权检查 + 参数拷贝 + 缓存扰动,约数百 ns 至 μs——比普通函数调用贵百倍,所以高性能路径都在攒批:select→poll→epoll 一次等待管上万连接,io_uring(Linux 5.1,2019)用提交/完成两个共享环队列把理想情况的系统调用次数压到零。分类六种(Silberschatz Ch2):进程控制(fork/exec/wait/exit)、文件操纵(open/read/write/close)、设备操纵(ioctl)、信息维护(getpid/stat)、通信(pipe/socket/shm)、保护(chmod/umask)。特权指令(关中断、改页表基址、执行 halt)只能在门里跑——用户态敢碰,硬件直接抛异常,这就是「门只朝一个方向开」的电路保证。
详解 · K17-16 操作系统内核架构:宏内核vs微内核
宏内核:调度、内存管理、文件系统、网络栈、驱动全跑在 ring0,组件间用函数调用互访,快——Linux 是最后的赢家;但一个驱动的野指针就是全机 panic,可加载模块 LKM(90 年代中期进入 Linux)让巨核获得动态扩展性,却没改变「同生共死」的本质。微内核:内核只保留地址空间、IPC 与底层调度,驱动与文件系统贬到用户态服务器——Mach(CMU,1985)开山;L4(Liedtke,1993)把 IPC 开销砍掉一个数量级,证明微内核慢主要是实现差;MINIX 3(Tanenbaum,2005)让驱动崩溃后自动重启,主打自愈;QNX 至今统治车机与硬实时。1992 年 Tanenbaum-Torvalds 论战在 comp.os.minix 开打:「LINUX is obsolete」对「可移植与性能」,三十年后两边都赢——Linux 吞下服务器,微内核血统守住了航空与汽车(seL4 于 2009 年成为首个通过形式化功能正确性验证的通用内核)。外核(MIT Aegis,Engler/Kaashoek,SOSP 1995)走到光谱尽头:内核只做受保护复用,应用链接 LibOS 直接管硬件——「抽象是一种选择,且每种抽象都有代价」。台上滑块四档就是这条性能↔隔离曲线:宏内核(Linux)→混合(Windows NT/macOS XNU:Mach 微核+BSD 组件)→微(MINIX/QNX)→外核(Aegis),没有银弹。
同步殿 · 共享之祸
内核门后是一座环形阵法,阵中央悬浮着一个共享变量水晶——多个进程的触手都伸向它。
诺依曼老祖
「两个进程同时往一个账户里加钱。会发生什么?」
死锁之环
「加两次呗。共享嘛,大家一起用就行。」
死锁四条件公式组装器
竞态演示 → 三法同步 → 死锁构造(四条件拖拽组装)→ 栈溢出三防护
死锁构造器 · 拖条件碎片进插槽
栈溢出攻击 · 8字节缓冲区写16字节
详解 · K17-17 同步机制:互斥/信号量/管程
竞态的根源是临界区不原子:台上 balance=100,两进程各自 LOAD→ADD 50→STORE,交错执行后余额 150——三条指令的读-改-写被拦腰打断,一次更新永久丢失。临界区问题的三条件(Dijkstra 1965 年首先形式化):互斥、前进(空闲让进)、有限等待(不饿死)。Peterson 算法(1981)证明仅用 flag+turn 两个共享变量就能解决两进程互斥——不需要任何硬件特权,但难以推广;硬件原语直接给原子性:test-and-set、compare-and-swap(CAS,IBM System/370 于 70 年代引入,x86 即 LOCK CMPXCHG)——今天所有无锁结构(无锁队列、RCU、Java Atomic)都构建在 CAS 上,代价是 ABA 问题(用带版本的指针化解)。互斥锁的工程形态是 futex(Linux 2.5.7,2002):快路径一条用户态 CAS,无竞争时零系统调用;失败才睡进内核哈希表。信号量(Dijkstra 1963-68 年为 THE 系统设计):计数型即资源池,wait(S) 把 S 减一、为负则阻塞,signal(S) 加一并唤醒——台上生产者 P(empty) 写 V(full)、消费者反向,配对使用永不乱。管程(Hoare 1974 CACM;Brinch Hansen 并行发明):共享数据+操作+条件变量封装成模块,编译器自动上锁——Java 的 synchronized/wait/notify 即其后裔,Mesa 语义要求 notify 可能丢失,所以条件必须放在 while 里重查。三个按钮,三层抽象:硬件原子 → OS 对象 → 语言构造。
详解 · K17-18 死锁:条件/预防/避免(Banker算法)/检测
四个必要条件史称 Coffman 条件(Coffman、Elphick、Shoshani,ACM Computing Surveys 1971):互斥、占有且等待、不可剥夺、循环等待——台上四枚碎片一一对应,四者同时成立才有死锁,破坏任一即可破局。处理策略四档:鸵鸟算法(装作不存在——Unix/Windows 的默认选择,Tanenbaum 直言:用户宁可偶尔死机也不愿频繁被强制约束);预防(一次性申请全部资源破占有等待、允许抢占破不剥夺、资源全局编号按序申请破循环等待——代价是低利用率与编程纪律);避免(需预知最大需求:Dijkstra 银行家算法,1965 年为 THE 系统设计——每次分配前跑安全检查,找一条安全序列使每个进程都能靠现有可用资源加上已持有资源跑完,复杂度 O(m·n²),教材标准例是 5 进程 3 类资源;名字来自银行家绝不放光全部现金);检测与恢复(资源分配图找环:每类资源单实例时,有环等价于死锁;多实例需化简算法。检出后杀进程或剥夺资源——Android 的 ANR 弹窗与 lowmemorykiller 走的就是这条线)。Boss 第三问的标准答案藏在四个字里:破一条件。Banker 检查安全性是避免,资源有序分配破坏循环等待是预防——「多买资源」不是答案,S0 你赌的就是这个。
详解 · K17-19 缓冲区溢出攻击与栈保护机制
x86-64 栈帧从高地址往低地址排(CSAPP Ch3):调用者参数、返回地址、保存的 %rbp、金丝雀(若开启)、局部缓冲区——缓冲区在低地址往高地址写爆,正好一路碾过返回地址。strcpy/gets/sprintf 不查边界,1988 年 Morris 蠕虫利用 fingerd 的 gets() 溢出,一夜瘫痪约 6000 台主机——当时互联网的十分之一;作者被判三年缓刑与 $10,050 罚金。1996 年 Aleph One 的《Smashing the Stack for Fun and Profit》(Phrack #49)把 shellcode+NOP 雪橇的攻击美学传遍世界——台上「8 字节缓冲区写 16 字节」就是它的最小教具。三盾:Canary 栈保护(Cowan 等 1997 年 StackGuard;GCC -fstack-protector 在缓冲区与返回地址之间放随机值,ret 前校验,被碾即 abort——注意 canary 含 \0,逼停字符串类溢出);NX/XD(2004 年 AMD NX bit、Intel 跟进 XD,W^X 原则——可写页不可执行,栈上 shellcode 直接失活,攻击者遂转向 ROP 返回导向编程,借用现有代码片段拼出恶意逻辑,Shacham 2007);ASLR(PaX 2001 → Linux 2.6.12 → Windows Vista 2007:栈/堆/libc 基址每次运行随机化,32 位仅十余比特熵可被暴力猜破,64 位才让猜谜真正无望)。三盾不治本——本是语言层无边界检查,Rust/Go 的编译期与运行期检查才是根治,那是另一殿的故事。
Boss 战 · 死锁之环
阵法灯火齐灭。暗紫色的环从四面八方压过来,凝成一个巨大的、缓慢自转的环——环上四道刻痕明灭可见。
死锁之环
「我是死锁之环。我不住在你的错误里——错误你能改。我住在你'以为资源总是够的'那份傲慢里。三问。答错一题,环就紧一分。」
渊账累计 0 笔 · 三问全对后清零
尾声 · 御灵之悟
环散尽时资源殿重归清明,你手腕上的资源环微微发光——四道刻痕还在,像四枚没说出口的印章。
诺依曼老祖
「你入门了。不是因为你答对了三问——答对的会忘。是因为你摔过的每一跤,都刻在你手上了。但——你管好了机器内部的资源。进程、内存、文件、设备、同步、死锁,你都摸过了。可你写的那些程序,从高级语言到机器码,中间那层翻译——会不会也丢了什么资源?明天,我们去看那座翻译殿。那座殿,叫编译原理。」
知识图谱点亮 · 御灵之悟
点亮全章11块碎片 → 死锁破局居中 → 境界突破
复盘 · 御灵主线:从「资源总够用」到「承认不够,在不够里权衡」
一条主线贯穿全殿:资源永远不够,OS 是一连串在不够里做出的漂亮妥协。S0 赌局(K17-01/02)——五程序四类资源全景全部超 100%,从批处理到 Borg,每代 OS 只回答「不够,怎么分」;S1 状态轮(03/04)——进程是活的程序,切换是有价的错觉,利用率曲线峰值恰在 f=30:权衡的最优点永远在中间;S2 调度场(05/06)——护航、饥饿、优先级反转三种崩塌证明公平是多目标问题,FCFS 平均等待 22.2ms、优先级 17.0ms、SJF 饿死 P6,MLFQ 是妥协不是答案;S3 实时钟(07)——U=0.958 冲破 RM 充分上界 0.780,R3=10 大于截止期 8,EDF 的最优天花板 1.0 也被过载砸穿:确定性有物理边界;S4 内存域(08/09)——连续碎外、分页碎内要查表、分段贴身也碎,TLB 把 200ns 的双倍访存赎回到 122ns;S5 置换渊(10)——Belady 异常 3 帧 9 次、4 帧反 10 次,工作集超卖的终极惩罚是抖动;S6 文件塔(11/12/13)——三种分配各付各税,inode 12 直接+三级间接撑起 4TB,磁头轨迹 640/236/331/382 柱面写尽寻道执念;S7 设备阵(14/15/16)——轮询 95%、中断 15%、DMA 3%,trap 是唯一的门,宏核/微核光谱没有银弹;S8 同步殿(17/18/19)——余额 150 是竞态的价,Coffman 四条件亲手凑齐,三盾护住被碾的返回地址;S9 三问破环、S10 点亮十一块碎片。倒过来读更清楚:抽象掩盖不够 → 调度分配不够 → 虚拟内存向磁盘赊账不够 → 文件持久化不够 → 同步管教共享的不够 → 死锁是不够冻结成环的那一刻。你管好了机器内部的资源;下一章 ch18 编译之桥要问:从高级语言到机器码,那层翻译的资源与优化,又归谁管?