数据筑基
你以为一致性是免费的。隔离级别调高就调高,加锁就加锁,崩溃重做就行——可每一次"以为免费"的代价,不一致之雾都给你记着账。
雾锁数据之门
数据筑基殿的门楣上刻着一行字:"数据不灭,并发不乱。"门内悬浮着五道剪影——银行、电商、航班、社交、物流——在灰雾中半透明地晃动。诺依曼老祖背着手站在一旁。
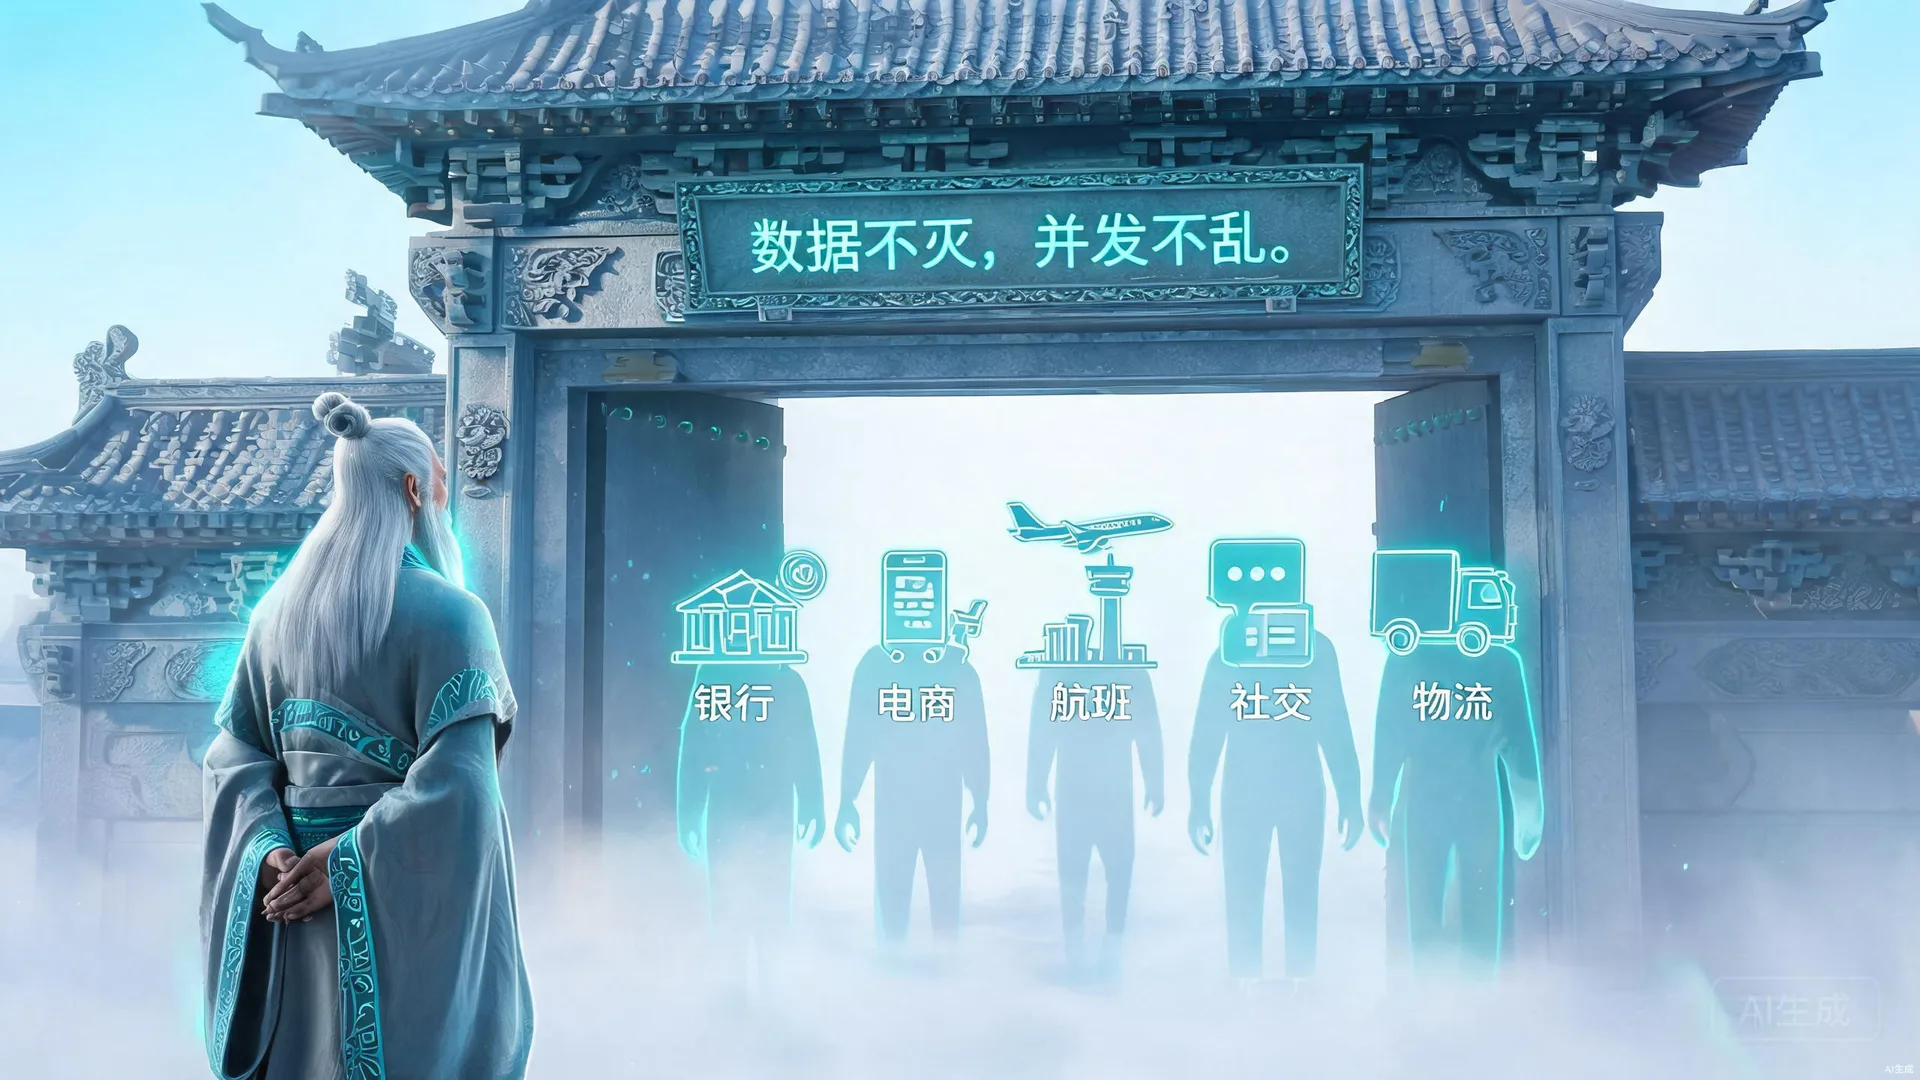
 诺依曼老祖
「这是数据库。它管三件事:数据不丢、并发不乱、状态一致。你猜,这五样东西里,哪一样其实不需要它?」
 不一致之雾
「这五样东西,哪一样其实不需要数据库?猜错一笔,我记一笔。账记满了,到 S9 一起算。」
数据库依赖预测挑战器
反直觉下注(五选一)→ 每点一次露出底层并发冲突现场 → 一致性文明图谱拼合
一致性文明图谱
详解 · K20-01 数据库系统的基本概念与应用场景
Ramakrishnan & Gehrke《Database Management Systems》Ch1:数据库系统的定义不是"存数据的软件"(文件系统也能做),而是"让并发、崩溃、不一致三头怪兽都不至于毁掉数据的系统"。台上五剪影逐个验证:银行转账撞原子性(T1转出未提交、T2读旧余额算账——脏读,钱凭空多出);电商库存撞隔离性(两用户同读库存=1各下一单——丢失更新,超卖);航班订座撞行锁缺失(12A被重复售出);社交动态撞读写并发(热点帖写入与亿级读同时发生——无读写分离则缓存击穿、DB雪崩);物流追踪撞持久性(写入途中宕机,改了一半未落盘——只有WAL重放能救回订单)。五样东西全部需要数据库——S0下注的反直觉之处正在于此:你以为"社交动态、物流追踪"这种"不就是读写吗"的场景能绕开数据库,实际上它们只是把数据库的代价转移给了缓存层与日志层。数据库与文件系统的分界线还有一条:DBMS提供三级模式结构(外模式/概念模式/内模式)与两级数据独立性(逻辑/物理)——应用程序只见外模式,存储引擎怎么换页、怎么建索引,上层不动。这张"账"本章反复翻:S9三问的第一问,问的就是隔离级别的代价权衡。
关系殿 · 表与代数
推开殿门,迎面是一排排悬浮的表——行是元组,列是属性,表与表之间有看不见的连线。诺依曼老祖递给你三枚符印:σ、π、⋈。
诺依曼老祖
「关系代数是过程性的——你要亲手排出运算顺序。σ选行、π选列、⋈连表。把'CS系学生选了哪些课'排出来。」
不一致之雾
「写个 SELECT 不就完了?干嘛要排运算顺序——多此一举。」
关系代数运算台 · σ/π/⋈ 流水线
依次放置三种运算符 → 看流水线如何从两张表取出结果
详解 · K20-02 关系模型:关系/属性/域/键/完整性约束
Codd 1970《A Relational Model of Data for Large Shared Data Banks》(CACM 13(6))——关系模型用一张二维表终结了层次/网状数据库的"指针迷宫":关系=表、元组=行、属性=列、域=列的取值集合(每个域有原子语义)。台上两张表是完整示范:students(sid, name, dept) 与 enroll(sid, course, credit)。键是关系中能唯一标识元组的最小属性集:students 的候选键是 sid;enroll 的候选键是 (sid, course) 组合——单独 sid 不够(一个学生选多门课),单独 course 也不够(一门课多个学生选)。从候选键中选一个做主键,主键在另一张表中的引用即外键:enroll.sid → students.sid。两条完整性约束是关系模型的"法制":①实体完整性——主键非空且唯一(这正是S3插入异常的根源:新生没选课时主键(sid, course)含 course 列,插不进去);②参照完整性——外键引用的值必须在被引用表中存在(不能给不存在的学生记成绩)。再加用户自定义完整性(如 credit>0)。关系模型的数学根基是集合论:关系是笛卡尔积的子集,因此关系代数的每个运算结果仍是关系(封闭性)——这为S2的SQL与S5的优化器提供了可组合的代数基础。Codd 因此获1981年图灵奖。
详解 · K20-03 关系代数:选择/投影/连接/除法等运算
Ramakrishnan Ch4:关系代数是过程性查询语言——每个表达式显式给出运算顺序。五大基本运算:选择σ(取满足谓词的行)、投影π(取若干列并去重)、笛卡尔积×、并∪、差−;导出运算:连接⋈(=σ+×的缩写:先笛卡尔积再按条件选择)、交∩、除÷。台上这道"CS系学生选了哪些课"是标准三步流水线:先⋈连接 students 与 enroll(按 sid 相等配对),再σ_dept=CS 选出CS系行,最后π_name,course 投影出姓名与课程——完整表达式 π_name,course(σ_dept=CS(students ⋈ enroll))。运算顺序不是装饰:σ与π可交换(选择先行能减少中间结果行数),但谓词涉及两张表的列时必须先连接——这正是S5优化器代数优化的空间:谓词下推(pushdown)把σ尽早压到扫描层,投影下推把π压到只读需要的列,中间结果一缩,代价天差地别。除法÷回答"对全部"型查询("选了所有CS课的学生"= π_sid,course(enroll) ÷ π_course(σ_dept=CS(courses)))——它是唯一不能只用基本运算直觉理解、却仍可由差与笛卡尔积复合表达的运算。关系代数与关系演算(元组演算/域演算)在表达能力上等价(Codd 1972 证明关系完备性);SQL取的是演算的声明式外壳、代数的可实现内核——你在S2写"要什么",优化器在S5替你选"怎么拿"。
SQL 炼炉 · 三咒与高阶
关系殿深处是一座炼炉,三个炉口分别刻着 DDL、DML、DCL。墙上贴着九张咒文符纸——CREATE、SELECT、GRANT……散乱一片。
诺依曼老祖
「SQL 是声明式的——你写'要什么',不写'怎么拿'。但这九张咒文分三类,投错炉口就炼废。投完再看一句 SELECT 怎么分层。」
SQL 炼炉 · 三咒分类 + 查询分层 + 视图封装
九张咒文投入正确炉口 → 查询分层展开 → 视图封装
详解 · K20-04 SQL基础:DDL/DML/DCL语句
Ramakrishnan Ch5:SQL按功能分三咒——炉口投错就炼废。DDL(数据定义):CREATE/ALTER/DROP TABLE,定义模式结构,且隐式提交(每条DDL自带COMMIT、不可回滚——生产事故一大来源:误 DROP TABLE 没有后悔药,只能靠闪回或备份)。DML(数据操纵):SELECT/INSERT/UPDATE/DELETE——注意 SELECT 在标准里也属DML,台上正是九张咒文三三归类:CREATE/ALTER/DROP TABLE 进 DDL 炉;SELECT/INSERT/UPDATE/DELETE 进 DML 炉;GRANT/REVOKE 进 DCL 炉。DCL(数据控制):GRANT/REVOKE 管权限——GRANT SELECT ON students TO reader 这样把权限收放,最小权限原则的第一道闸。SQL本质是声明式的:写"要什么"不写"怎么拿"——同一句 SELECT 有 N 种等价执行计划(S5三面镜子:顺序扫描/索引扫描/哈希连接,代价10000/120/350),优化器替你选。声明式的代价是丧失路径控制权:你无法强制"用哪个索引"(CBO可以不理会hint),得到的是"语义正确"而非"路径正确"。DML内还有一道分界:集合式(一条语句操作一批行,如 UPDATE students SET dept='AI' WHERE dept='CS')与游标式(DECLARE CURSOR 逐行导航——过程性,可逐行判断,但性能与并发都差,仅必须逐行处理时用)。三咒各管一张表的生老病死与大门钥匙:DDL管结构、DML管数据、DCL管权限。
详解 · K20-05 SQL高级:子查询/连接/聚合/视图/存储过程
Ramakrishnan Ch5-6:台上分层展开的那句查询正是三层结构:外层 SELECT name FROM (...) 只关心最终列;中层派生表 (SELECT * FROM students WHERE dept='CS') AS cs 是 FROM 子句里实体化的子查询;谓词层 WHERE cs.sid IN (SELECT sid FROM enroll) 是嵌在谓词里的子查询——相关子查询(引用外层列)与无关子查询(可独立执行)代价天差地别,优化器常把相关子查询改写为半连接(semijoin)。连接三型:内连接(丢不匹配行)、外连接(LEFT/RIGHT/FULL 保一侧或两侧、NULL补位——"没选课的学生也要列出"必须 LEFT JOIN)、自连接(一表当两表用,如"同院系同事对")。聚合:GROUP BY 分组 + COUNT/SUM/AVG/MIN/MAX + HAVING 过滤分组结果——WHERE 在分组前过滤行、HAVING 在分组后过滤组(写错位置是高频bug:WHERE dept='CS' 是行过滤,HAVING COUNT(*)>2 是组过滤)。视图:CREATE VIEW cs_students AS SELECT * FROM students WHERE dept='CS'——封装查询,对外只暴露 cs_students。两个价值:逻辑独立性(底层表加列改结构,视图不变、上层应用不动)与权限裁剪(GRANT ON VIEW 只放行可见列)——台上符纸那行正是此意。存储过程:预编译SQL过程存数据库端,省往返、集中逻辑;代价是绑定数据库实现(迁移痛)、业务逻辑分散在应用与数据库两侧难测试——现代实践多把逻辑收回应用层,只留触发器与约束在库内。
设计阁 · 范式之缚
设计阁中央摆着一张大表——学号、姓名、课程、学分、院系、院系电话,全塞在一张表里。表身上布满裂纹,像随时会碎。诺依曼老祖皱眉。
诺依曼老祖
「这张表违反了范式。点那三个按钮,看看会发生什么——插入、删除、修改,每个都会让数据自相矛盾。」
不一致之雾
「一张表多省事,干嘛拆?来,我帮你改几笔——保证越改越乱。」
范式升降机推演器 · 异常复现 + ER建模 + 1NF→BCNF
触发三类更新异常 → ER建模拆表 → 范式滑块逐级愈合裂纹
反范式大表 · 异常复现沙盘
详解 · K20-06 数据库设计:ER模型与关系模式规范化
Ramakrishnan Ch3+Ch19:ER模型是"先画世界、再翻译成表"的设计法。三件套:实体(矩形,如学生/课程/院系)、属性(实体上的字段)、联系(菱形,带基数)。台上ER图是完整样例:学生—选课—课程是 M:N 联系(一个学生选多门课、一门课多个学生选);学生—属于—院系是 N:1 联系(多个学生属一个院系)。ER→关系模式的翻译规则:①每个实体→一张表(实体属性作列、实体键作主键);②N:1 联系→把"1"端的键作为外键放进"N"端表(students 里放 dept 外键);③M:N 联系→必须独立成表、两端键组成复合主键(enroll(sid, course) 正是"选课"菱形翻译出来的表)。设计的两难:ER图是需求侧的自然语言,范式是存储侧的军规——同一份需求既可翻成一张反范式大表(沙盘那张 students(sid, name, dept, dept_phone, course, credit)),也可翻成四张范式表;前者读起来一次JOIN都不用,后者更新不炸。规范化理论(下一块)给出拆表判据:函数依赖决定表该不该拆。工程顺序是四步:先ER建模(对业务建模、防遗漏实体与联系)→映射为关系模式→逐级检查范式→最后按读性能适度反范式(冗余列/汇总表)——S3顿悟那句"范式是在数据一致性与查询代价之间的权衡"正是流程的最后一环。
详解 · K20-07 范式理论:1NF/2NF/3NF/BCNF
Ramakrishnan Ch19:范式不是教条,是更新异常的解药。反范式大表 students(sid, name, dept, dept_phone, course, credit),主键 (sid, course),函数依赖集:sid→name,dept,dept_phone;course→credit;dept→dept_phone。三类异常实锤(台上三个按钮):插入异常——新生没选课,主键含 course 列不能为空,插不进去;删除异常——删掉某院系最后一个学生的最后一门课,院系电话随之蒸发;修改异常——换院系电话要改该院所有学生行,漏改一行即不一致(雾账的来源)。逐级治愈:1NF(原子值、无重复组——大表已满足但异常仍在,1NF是底线不是解药);2NF(非主属性不部分依赖候选键——credit 只依赖 course(组合键的一部分),拆出 course(course, credit) 让 enroll 不再存 credit:插入/删除异常愈合);3NF(非主属性不传递依赖候选键——sid→dept→dept_phone 传递链,电话移进 dept(dept, dept_phone) 表:修改异常愈合);BCNF(每个非平凡函数依赖的决定因素都是候选键——换代理键 dept_id 后全表达标,异常清零)。判定口诀:2NF看部分、3NF看传递、BCNF看决定因素。代价:拆成四表后"查CS系学生选课学分"从单表直读变多表JOIN——为读性能适度反范式(物化汇总、冗余列)是工程常态,但每次反范式都在亲手埋一颗更新异常的雷,必须用触发器或应用层补偿写回。
索引塔 · B+树与哈希
索引塔是一座高塔,塔身是层层叠叠的节点。诺依曼老祖指着塔顶和塔基。
诺依曼老祖
「B+树:内部节点只路由,数据全在叶子层,叶子用链表串起——范围查询友好。哈希:等值查询 O(1),但不支持范围。查询形状决定用哪个。」
索引塔 · B+树建造器 + 哈希分桶器 + 查询形状匹配器
插入键值建B+树 → 哈希分桶 → 匹配查询形状选索引
B+树建造器
哈希分桶器 · h(k)=k%4
查询形状匹配器 · 点格子判断索引适用性
详解 · K20-08 索引技术:B+树索引的原理与操作
Ramakrishnan Ch10:B+树是磁盘时代的杰作——为页式存储而生。结构铁律(台上建造器逐次插入10/20/30/40/50演示):所有数据只存叶子层,内部节点只存路由键不存数据,叶子用双向链表串成有序序列。查询=从根到叶一次下潜(O(log_F N),F为扇出):等值查询 WHERE id=42 走到叶即定位;范围查询 WHERE id>20 或 BETWEEN 10 AND 50 到叶后沿链表顺序扫描(O(logN+K),K为结果行数);ORDER BY id 直接沿链表输出免排序。为什么不用二叉搜索树:节点大小对齐磁盘页(4KB),一页可存几百个键,扇出数百——三四层即可索引亿级行(扇出500时500^4≈6×10^10);二叉树亿级行要27层,每层一次随机IO是灾难。插入时节点满则分裂:键复制上移到父节点(注意是复制不是移动——叶子保有全量键,这是与B树的关键区别、也是范围查询友好的根源),分裂可能级联到根、树长高一层;删除时节点过瘦则向兄弟借键或合并。B+树 vs 哈希的选型表(台上查询形状匹配器):id=42 两者皆可,>20、BETWEEN、ORDER BY 只B+树——范围与排序是B+树的护城河。工程附注:聚簇索引(叶子存整行,如 InnoDB 主键)vs 二级索引(叶子存主键引用需回表——S5索引扫描代价80里就含回表);复合索引最左前缀原则(索引(a,b)对 WHERE b=? 无效)。
详解 · K20-09 哈希索引与可扩展哈希
Ramakrishnan Ch10:静态哈希索引的原理一台演尽:h(k)=k%4,插入 12→桶0、25→桶1、38→桶2、41→桶1、56→桶0。等值查询 O(1)——一次哈希一次桶内查找,这是它对B+树唯一的碾压项。但静态哈希有三宗罪:①不支持范围查询(h(20)=0 与 h(21)=1——相邻的键散进不相邻的桶,序被哈希打碎,>20 与 BETWEEN 退化为全桶扫描即全表扫描);②桶数固定——数据涨了溢出页挂成长链(查找退化为链表遍历),数据缩了空桶浪费空间;③扩容重哈希要停机重建整个索引。可扩展哈希(extendible hashing)是对②③的手术:加一层目录(directory),桶只收哈希值前 i 位匹配的键。桶满不做全局重建,只做局部分裂:若桶的局部深度 i_local < 全局深度 i,分裂该桶并把目录中指向它的指针一分为二;若 i_local = i,先目录翻倍(i+1)再分裂。结果:空间随数据平滑增长,分裂只波及一个桶,代价是目录的间接层与偶发的全局翻倍。自适应哈希(InnoDB AHI)是第三条路:不给整表建哈希,运行时观察到某页被等值热点命中就自动为该页建页内哈希——观测驱动的按需索引。选型一句话(台上匹配器判分表):点查询密集且键分布均匀→哈希;任何范围、排序、前缀匹配→B+树;主键B+树+热点自适应哈希并存,是主流引擎的现实。
执行计划镜 · 查询的秘密
执行计划镜是一面巨大的镜子,同一句 SQL 在镜中映出三个不同的影子——顺序扫描、索引扫描、哈希连接,每个影子上都标着代价。
诺依曼老祖
「优化器基于代价(CBO)选计划。代价 = IO + CPU。但代价靠统计信息估算——统计信息一陈旧,选错计划。」
不一致之雾
「统计信息?那玩意儿反正会自动更新——不用管。」
执行计划镜 · 代价拆解 + 统计刷新
点三个计划看代价拆解 → ANALYZE 刷新统计 → 优化器重选
详解 · K20-10 查询处理与执行计划
Ramakrishnan Ch12:一句SQL到结果要过四站:解析(语法树)→重写(视图展开、谓词规范化)→优化(生成物理计划,见下一块)→执行。逻辑计划只说"用什么算子"(扫描/连接/投影/聚合),物理计划才说"怎么做"(顺序扫描还是索引扫描、嵌套循环还是哈希连接、内存排序还是外部归并)。台上三面镜子的代价拆解正是物理层的语言:顺序扫描 students 代价10000 = IO 9500 + CPU 500——全表逐页读入、逐行判断 dept='CS';索引扫描 120 = IO 80 + CPU 40——走 dept 上的B+树定位CS行再回表,页数行数都按选择性计价;哈希连接 350 = IO 120 + CPU 230——对 enroll 建哈希表(一遍构建)、students 探测(一遍探测),代价主要在CPU哈希计算。注意代价单位不是毫秒,是页IO数+CPU元组数的加权和——优化器在计划生成时不可能真的执行一遍,只能用可校准的模型量估价。连接算子三选择:嵌套循环(小外表驱动+内表索引,O(N·logM))、排序归并(两输入有序时线性归并 O(N+M)+排序费)、哈希连接(等值连接的默认王者 O(N+M) 但耗内存,内存不够分批落盘就慢)。算子间数据流还有两种形态:流水线(volcano迭代子模型,拉一行算一行,省内存)与物化(中间结果落盘,可共享可重用)——执行计划是"算子树+每算子实现+数据流动方向"三合一的完整图纸。
详解 · K20-11 查询优化:基于代价的优化器(CBO)
Ramakrishnan Ch13:CBO的工作分两半——造计划空间+给计划标价。造:等价变换靠关系代数恒等式(σ与π交换、σ级联合并、谓词下推、外连接消除),连接顺序枚举用动态规划(System R 经典算法:n张表的连接顺序空间是 n! 量级,DP把它压到 2^n 个子集×分裂点);标价:靠统计信息——每表行数、每列不同值数(NDV)、最频值列表、等宽/等深直方图,选择性=谓词筛掉的比例。台上正是完整事故现场:dept 列陈旧直方图误判选择性100%(统计收集于院系调整前,以为全表都是CS),顺序扫描(代价10000)被估为"反正全要读";ANALYZE 后直方图刷新,真实选择性5%(约500行),顺序扫描固定读全表(IO 9500+CPU 500=代价10000),索引扫描只要120——优化器改选索引,计划翻转。CBO的阿喀琉斯之踵正在于此:代价模型的输入是估算值,估算的输入是统计信息,统计信息是采样快照——数据一变统计就陈旧,统计一陈旧计划就翻车。"统计信息自动保鲜"刻痕(S5排除项)的由来:主流引擎的自动统计(PostgreSQL autoanalyze、MySQL innodb_stats_auto_recalc)都是阈值触发的近似保鲜,大批量ETL后仍需手动 ANALYZE。规则优化(RBO)是前CBO时代的产物:写死的启发式(有索引就用索引)——在低选择性列上反而翻车(选择性90%时走索引=90%的行随机回表,比全表扫描还慢)。现代优化器是CBO为主+规则兜底的混合体,用执行反馈修正估算的学习型优化器是当前前沿。
事务之环 · ACID 誓言
事务之环是四个悬浮的圆环——A、C、I、D——上面刻着誓言。诺依曼老祖让你依次触碰。
诺依曼老祖
「A 靠 undo、C 靠约束、I 靠锁/MVCC、D 靠 redo。四承诺各有代价——没有一个免费的。测完再看并发双事务。」
不一致之雾
「隔离级别?直接拉满 Serializable 不就完了——最安全嘛。」
事务之环 · ACID 四环检验 + 并发双事务沙盘
点 A/C/I/D 看检验 → 切换隔离级别看脏读/不可重复读/幻读
详解 · K20-12 事务(Transaction)的概念与ACID特性
Ramakrishnan Ch15:事务是"一组要么全做、要么全不做的操作"——转账是经典例子:A账户-100与B账户+100必须同生共死,A+B总额不变。ACID四承诺各有实现机制(台上四环检验逐一验证):原子性 A——全做或全不做,靠 undo 日志(崩溃/回滚时按日志把已做的修改逐条倒回去),代价是日志存储+回滚开销;一致性 C——从一个合法态到另一个合法态(约束不破:余额非负、外键存在、A+B守恒),靠约束检查+应用层逻辑共同守护——C是目的,AID是手段(常被误解成C也由数据库单独保证);隔离性 I——并发事务互不干扰,靠锁(S/X锁、两阶段锁)或 MVCC(多版本并发控制:读旧版本快照、读写不互斥),代价是吞吐下降+死锁风险(S7整场戏);持久性 D——提交后永不丢失,靠 redo 日志/WAL(先写日志再改数据,S8整场戏),代价是每次提交的日志落盘延迟。四承诺没有一个免费(S6顿悟)——这是全章主线的第一次显式陈述。隔离性的度量工具是异常谱(沙盘四档切换):脏读(读到未提交值)、不可重复读(两次读同值不同)、幻读(范围内冒出新行)——隔离级别越高挡得越多但吞吐越低,Serializable 全挡但近乎串行执行,这正是 S9 第一问"哪个隔离级别最好"的陷阱所在:答案是"按异常容忍度与吞吐权衡",没有最好。
并发锁阵 · 2PL 与死锁
锁阵是一片密密麻麻的锁具网格,两个事务 T1、T2 各持一盏灯。诺依曼老祖刚说完"2PL保证可串行化",T1 锁了 A,T2 锁了 B——然后它们互相对望,谁也不让谁。
诺依曼老祖
「两阶段。先都加锁,再都放锁——2PL。但你看,T1 等 B,T2 等 A,等待图成环了。」
不一致之雾
「死锁。你亲手造的。加锁即安全?呵——安全从来不是免费的。」
死锁等待图相图探索器 · 2PL + 画环 + 死锁处理
T1/T2 加锁 → 互相等待 → 等待图成环 → 选处理策略 → 事务之伤
2PL 加锁执行器
等待图画环器
死锁处理策略 · 选一个
详解 · K20-13 并发控制:封锁协议/两阶段锁(2PL)
Ramakrishnan Ch16:两阶段锁是"用锁换可串行化"的经典协议:每个事务分两阶段——增长阶段只加锁不放锁,收缩阶段只放锁不再加锁(台上相图:T1锁数、T2锁数构成的坐标系里,一旦开始放锁就再不能回头加锁)。锁的相容矩阵是协议的原子规则:S锁(共享,读)与S锁相容(多读者并存)、S与X(排他,写)不相容、X与X不相容。2PL保证冲突可串行化——证明思路:冲突操作(同对象、至少一个写)在加锁序与执行序上强制一致,最终等价于某个串行顺序。但2PL有两处软肋:①死锁——增长期各事务交叉持锁互等,等待图成环(T1持A等B、T2持B等A,台上画环器正中死锁区),死锁不是bug而是2PL的必然税,只能靠处理(见下一块);②级联回滚——收缩期放锁后若事务还要回滚,读过它放锁后数据的事务都读到了未提交值,被迫连环回滚。修正是严格2PL(S2PL):X锁持有到事务提交/回滚才放——放弃一点并发度换免级联,这是商用数据库的默认。另一条路是MVCC(时间戳排序/快照隔离):写不阻塞读(读旧快照)、读不阻塞写——吞吐大幅提升,代价是写偏序异常(快照隔离下两个并发事务各读旧值各写不同行、联合破坏不变量——PostgreSQL 的可串行化快照隔离 SSI 用危险结构检测补这个洞)。锁与MVCC不是二选一:InnoDB=2PL写锁+MVCC读快照的混合体。
详解 · K20-14 死锁处理:死锁预防/检测/超时
Ramakrishnan Ch16:死锁四条件(互斥、持有并等待、不可抢占、循环等待)在锁阵里全部就位:T1持A的X锁等B、T2持B的X锁等A——等待图 G=(V,E) 上 T1→T2→T1 成环,环即死锁(台上画环器把环标成暗红)。处理三路线(台上策略卡):①检测+回滚:周期性跑等待图找环,选"回滚代价最小"的牺牲者(victim)回滚重启——代价通常按事务已做工作量(已持锁数、已执行时长)估;台上T1被选为牺牲者,青色碎片悬空——本命事务之伤,S8才愈合。②时间戳预防(两式):wound-wait——老事务抢:T1(老)请求T2(新)持有的锁时直接把T2 wound回滚、自己抢占;wait-die——老事务等:T1(老)可以等T2(新),反过来T2(新)请求T1(老)持有的锁则T2只能 die 自轮回滚。两式共同保证时间戳单向有序、等待图永不成环("老等新"与"老抢新"都不产生环)。代价:被回滚事务重启后时间戳保留(防饿死),但新事务在wait-die下可能反复die——台上读数"新事务有饿死风险"正是此意。③锁超时:等待超过阈值自动回滚——最简单、无需全局结构,但会误杀长事务(合法长查询被超时炸掉)。工程现实:InnoDB 用检测+回滚(默认 innodb_deadlock_detect=on);PostgreSQL 周期检测;高并发热点场景有人关掉检测纯用超时(检测本身在极高并发下成为争用热点)。预防、检测、超时是"全局信息量 vs 实现复杂度"的三档权衡——没有免费的处理,正如死锁是可串行化的必然税。
灾厄日志 · ARIES 复苏
S7 留下的青色碎片还悬在半空——本命事务之伤未愈。灾厄日志殿里卷起一轴金色日志卷轴,上面刻满 LSN 序号。诺依曼老祖指着卷轴。
诺依曼老祖
「WAL——先写日志,再改数据。日志在,就能重来。先组装 WAL 顺序,再走 ARIES 三阶段,把你的事务之伤补回来。」
不一致之雾
「崩溃了重做 winner 不就行?干嘛要重复全部历史——多此一举。」
ARIES 三阶段公式组装器 · WAL + Analysis/Redo/Undo + CLR
组装 WAL 顺序 → Analysis 扫描 → Redo 重放全部历史 → Undo 倒序撤销写 CLR → 事务之伤愈合
WAL 原则组装 · 拖碎片到正确顺序
日志卷轴扫描器
Analysis 分析
Redo 重做
Undo 撤销
详解 · K20-15 日志与恢复机制:ARIES算法基础
Ramakrishnan Ch17 + Mohan et al. 1992《ARIES: A Transaction Recovery Method Supporting Fine-Granularity Locking and Partial Rollbacks Using Write-Ahead Logging》(ACM TODS 17(1)):WAL铁律(台上三步组装:先写日志→日志落盘→改数据)——数据页落盘前,描述该修改的日志必须已在磁盘上;崩溃后只要日志在,数据就能重来。日志记录核心字段 <T, X, old, new>(卷轴 LSN=1 的 <T1, A, 100, 90>:T1把A从100改成90——old值供undo、new值供redo)。ARIES三阶段(台上三张卡逐步点亮):①Analysis——从检查点扫描到日志尾,标记 winner(有COMMIT记录,如T1)与 loser(崩溃时未提交,如T2),并找最早脏页定 redo 起点;②Redo——从最早脏页起重放所有更新日志(LSN 1: A=90、LSN 3: B=150、LSN 5: C=250),包括 loser T2 的修改——重复历史(repeating history),先把数据库精确恢复到崩溃前一瞬的物理状态;③Undo——对 loser 倒序撤销(先LSN 5的C、再LSN 3的B),每撤销一条写一条CLR(补偿日志记录):撤销LSN 5(<T2,C,300,250>,T2把C从300改成250)写 CLR <T2,C,250,300>(把C改回300)——CLR记录的是撤销动作本身,且幂等:恢复途中再次崩溃,重启后CLR可重放,undo不会做两遍。"Redo必须重复全部历史"是台上排除项的正解——不能只重做winner:崩溃瞬间磁盘上的数据页可能是任何中间状态(有些页落盘了、有些没有),只有全量重放才能确定地到达崩溃前状态再统一undo;选择性redo会漏掉"已落盘但属loser"的页,留下不一致。检查点(LSN=4)的作用:fuzzy checkpoint 只记脏页表+事务表,把恢复扫描从全量日志缩到检查点之后——日志越长,这个锚越值钱。
Boss 战 · 不一致之雾
日志殿灯火齐灭。灰雾从四面八方压过来,凝成一张巨大的、没有五官的脸——由无数行不一致的数据构成,同一个余额有三个不同的值。
不一致之雾
「我是不一致之雾。你在每一处都欠了我的账——现在,一笔笔还。三问。答错一题,雾就深一分。第三问,用排除法——你走过的每一条死路,都会浮出来。」
渊账累计 0 笔 · 三问全对后清零
异界远眺 · NoSQL 与向量
雾散尽时数据筑基殿灯火重明。殿后推开一扇窗,窗外是另一片天地——NoSQL 的异界,规则全然不同。诺依曼老祖站在窗边。
诺依曼老祖
「关系数据库不是唯一答案。NoSQL 舍关系完整性换伸缩,LSM-tree 舍读性能换写吞吐,列存舍行事务换分析 IO,向量索引舍精确换语义相似。每种存储都是一次权衡——和你刚走过的 ACID 权衡,本质一样。」
异界远眺 · NoSQL 对照 + LSM/列存/向量 + 知识图谱
对照4类NoSQL权衡 → LSM/列存/向量索引 → 点亮10块碎片 → 境界突破
LSM-tree · 写优化存储
列存对比 · 分析查询友好
向量索引 · 语义近邻搜索
详解 · K20-16 NoSQL数据库概览:键值/文档/列族/图数据库
Kleppmann《Designing Data-Intensive Applications》Ch2:NoSQL不是一种数据库,是四类不同取舍的存储统称(台上对照卡的"舍/得"二字正是其本质)。键值KV(Redis/DynamoDB):舍关系完整性(无JOIN无外键、值对数据库是黑盒)换极致伸缩(按key哈希分片、无跨节点事务);文档(MongoDB/CouchDB):舍JOIN(子结构内嵌进文档、一次读取整文档)换灵活schema(同集合文档字段可不同——"读时schema" vs SQL的"写时schema":错误数据入库时无人拦截、读时才炸);列族(Cassandra/HBase):舍行事务(一行的事务边界碎成列族)换宽表高吞吐写(按行键聚簇、列族内列稀疏、底层正是下一块的LSM);图(Neo4j):舍海量扫描(全图统计聚合弱于SQL)换关系遍历(指针直达——多跳查询"认识认识张三的人"在SQL要多层自连接,图库走邻接O(邻居数))。NoSQL的诞生动因(2000s web规模):水平伸缩(单机关系库撑不住亿级并发写)、开发迭代速度(schema迁移慢于代码迭代)、专用查询形态(社交图、缓存、时序)。代价是丢掉的ACID与JOIN要在应用层重建(Saga补偿事务、应用层JOIN的N+1查询问题)。NewSQL(Spanner/CockroachDB/TiDB)是第三条路:分布式架构+保留SQL与事务(Spanner 用 TrueTime 原子钟做全球一致性)——证明"伸缩"与"SQL"并非二选一。台上图谱那句总结正是本块主旨:每种存储都是一次权衡,和你刚走过的 ACID 权衡本质一样。
详解 · K20-17 LSM-tree与写优化存储引擎
Kleppmann Ch3 + O'Neil et al. 1996《The Log-Structured Merge-Tree》(Acta Informatica 33):B+树与LSM的分歧在一个物理事实——磁盘顺序写与随机写差两三个数量级(HDD最悬殊、SSD缩小但仍在)。B+树原地更新(页内改+页间分裂)=写随机IO;LSM把全部写变成顺序追加(台上分层图):①写先进内存 MemTable(跳表/红黑树,写内存O(logN));②MemTable写满冻结为 Immutable(只读,同时开新MemTable接写);③后台把 Immutable 刷成磁盘上的 SSTable(有序字符串表,顺序写);④L0 SSTable 堆多后,后台 Compaction 把多轮合并进 L1、L1再进L2(尺寸逐级放大,典型10倍)——合并时顺带去重(同键保留最新版本)与落地删除墓碑(tombstone)。读的代价随之而来(台上红字注记):一次点查要查 MemTable+Immutable+每层SSTable——布隆过滤器先跳过"肯定没有该键"的SSTable、残余误判才真查,多层合并即读放大;Compaction 反复重写同一数据即写放大(Level式合并典型10-30倍);旧版本延迟清理即空间放大。三放大是LSM的三张账单,调参(层比、SSTable大小、Compaction阈值)就是三者间挪预算。结论(RocksDB/LevelDB实测传统印象):写吞吐LSM常胜B+树数倍、点读与范围读B+树稳。用户名单:RocksDB(MyRocks/CockroachDB/TiKV底层)、LevelDB、Cassandra、HBase、InfluxDB——"写密集、只增不改"负载(日志、遥测、时序)的默认底座。
详解 · K20-18 OLAP与列式存储基础
Kleppmann Ch3:OLTP与OLAP是同一种数据在两种负载下的分身。OLTP(联机事务处理):短事务、读写当前状态、行级点查("这个用户的订单")、并发高、延迟敏感——银行/电商在线库,行存+B+树。OLAP(联机分析处理):长扫描、读历史聚合("过去一年按地区按月的销售额")、列级统计、吞吐至上——数据仓库/BI报表。行存vs列存的物理差异(台上对比画布):行存一行连续存放(读整行快、改一行一页搞定);列存一列连续存放——SELECT AVG(age) 只读 age 列(台上高亮的那一列),其余列的字节根本不进内存。三个优势来源:①IO按需(百列表只查3列=IO省97%);②压缩率(同列同类型同分布——重复值用游程RLE/字典编码、整数列用增量/Delta编码,Parquet实测常5-10倍于行存);③向量化执行(列批进SIMD,聚合吞吐数倍于逐行解释)。代价三笔:单行重构贵(一行字段散在各列,需位置对齐重组——OLAP不在乎、OLTP致命);行级更新删除难(改一个值要动多个列文件——列存引擎基本是批量追加+定期重写);跨列原子事务弱。所以列存是OLAP专属:ClickHouse/Parquet/ORC/Druid;注意 Cassandra 虽叫"列族"但物理仍按行键聚簇宽行,不是这里的列存。数仓顺带一环:星型模式(事实表+维度表)与ETL/ELT把OLTP数据搬进仓库——AI特征工程读的正是这些列存大表。
详解 · K20-19 向量索引与近似最近邻搜索:IVF/HNSW
Kleppmann Ch2(embeddings)+ Malkov & Yashunin 2018《Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs》(IEEE TPAMI 42(4)):语义搜索第一步是把语义编码成向量(embedding——文本/图像经模型映射为几百到几千维空间中的点,语义相近则距离相近);第二步是在亿级点里找"离查询点最近的k个"——kNN。精确kNN(暴力扫描)每查询 O(N·d):千万级库×768维已是数百毫秒,亿级直接不可用。ANN(近似最近邻)的契约:牺牲一点召回率(比如top-10里9个是真近邻)换两三个数量级的延迟下降。两条主路线:IVF(倒排文件)——先对全库跑 k-means 聚成数千簇(质心即分桶),查询时只探查最近的 nprobe 个桶;代价是簇边界丢召回(真近邻恰在没探查的桶里)。HNSW(分层可导航小世界图,台上单层示意)——每个点与近邻连边建多层图:顶层稀疏长边负责快速粗定位、底层稠密短边负责精找,查询从顶层入口贪心图遍历逐层下沉,像"高速公路转街道"的导航——几跳就从全库范围收敛到目标邻域,亿级库毫秒级。HNSW对IVF的优势是对数据分布不敏感(IVF的簇质量决定一切),代价是建图慢、内存大(邻接表常驻)与增删复杂。统一权衡轴:召回率 vs 延迟 vs 内存(IVF加乘积量化PQ压缩再换内存)——nprobe/efSearch 参数就是这条轴上的旋钮。这是AI数据基础设施的地基:RAG检索(衔接AI篇ch13)、推荐召回、以文搜图全在它上面跑。S10顿悟最后一环:向量索引舍精确换语义相似——舍与得的语法,与全章每一次权衡完全同构。
复盘 · 数据筑基主线
一条主线串起全章:一致性是有价的。S0五剪影下注(银行撞原子性、电商撞隔离性、航班撞行锁、社交撞读写分离、物流撞WAL——五样东西没有一样不需要数据库,一致性只是代价被数据库替你扛了)→ S1关系代数流水线("CS系学生选了哪些课"=π_name,course(σ_dept=CS(students ⋈ enroll))——过程性语言,运算顺序亲手排)→ S2三咒分炉(DDL定义/DML操纵/DCL控制)+查询分层+视图封装(声明式外壳、优化器内核)→ S3范式升降机(反范式大表三异常:插入(主键含course插不进)/删除(院系电话蒸发)/修改(漏改一行不一致);2NF拆course表、3NF移dept_phone、BCNF上代理键——范式是解药不是教条,JOIN代价是账单)→ S4索引塔(B+树叶子有序链表管范围排序、哈希k%4管等值O(1)——查询形状决定索引)→ S5执行计划镜(顺序扫描10000=IO 9500+CPU 500、索引扫描120;ANALYZE把选择性100%修正为5%——CBO靠统计信息标价,统计陈旧计划翻车)→ S6 ACID四环(A靠undo、C靠约束、I靠锁/MVCC、D靠redo——四承诺无一免费;隔离级别是异常防护与吞吐的权衡矩阵)→ S7锁阵2PL(增长期只加锁、收缩期只放锁,可串行化到手、等待图成环死锁到手——死锁是必然税;检测+回滚/wound-wait/wait-die/超时三路处理)→ S8 ARIES复苏(WAL铁律三步;Analysis定winner/loser、Redo重复全部历史含loser、Undo倒序写CLR幂等)→ S9三问清账(隔离级别没有最好只有权衡、2PL是护甲兼死锁温床、一致性=所有代价之间的平衡点)→ S10异界远眺(KV舍完整性换伸缩、文档舍JOIN换灵活、列族舍行事务换宽表写、图舍扫描换遍历;LSM舍读换写、列存舍行换列、向量舍精确换语义——没有银弹,只有权衡)。三个贯穿顿悟:①一致性不免费——ACID每个承诺都有实现机制的账单;②异常靠处理不靠回避——死锁、崩溃、计划翻车都是必然,工程答案是机制化处理而非消灭;③所有存储决策都是权衡——范式vs JOIN、B+树vs哈希、SQL vs NoSQL、写优化vs读优化,要问"舍什么得什么"而不是"哪个最好"。元婴四层圆满——单机数据筑基已成,但数据一摊到多台机器:网络会断、时钟会漂、节点会死,一致性的账单要重新算。下一章,分布之壁。