记忆长存
没有永恒的记忆,只有不同时间尺度的秩序——SRAM靠供电、DRAM靠刷新、Flash靠势垒、MRAM靠自旋——工程师不是打败熵,是和熵达成妥协。
存储金字塔
镜纹在本命石上发出银辉——那是电流镜和反馈的光。你从模拟训练场继续前行。前方豁然开朗——一片星海。
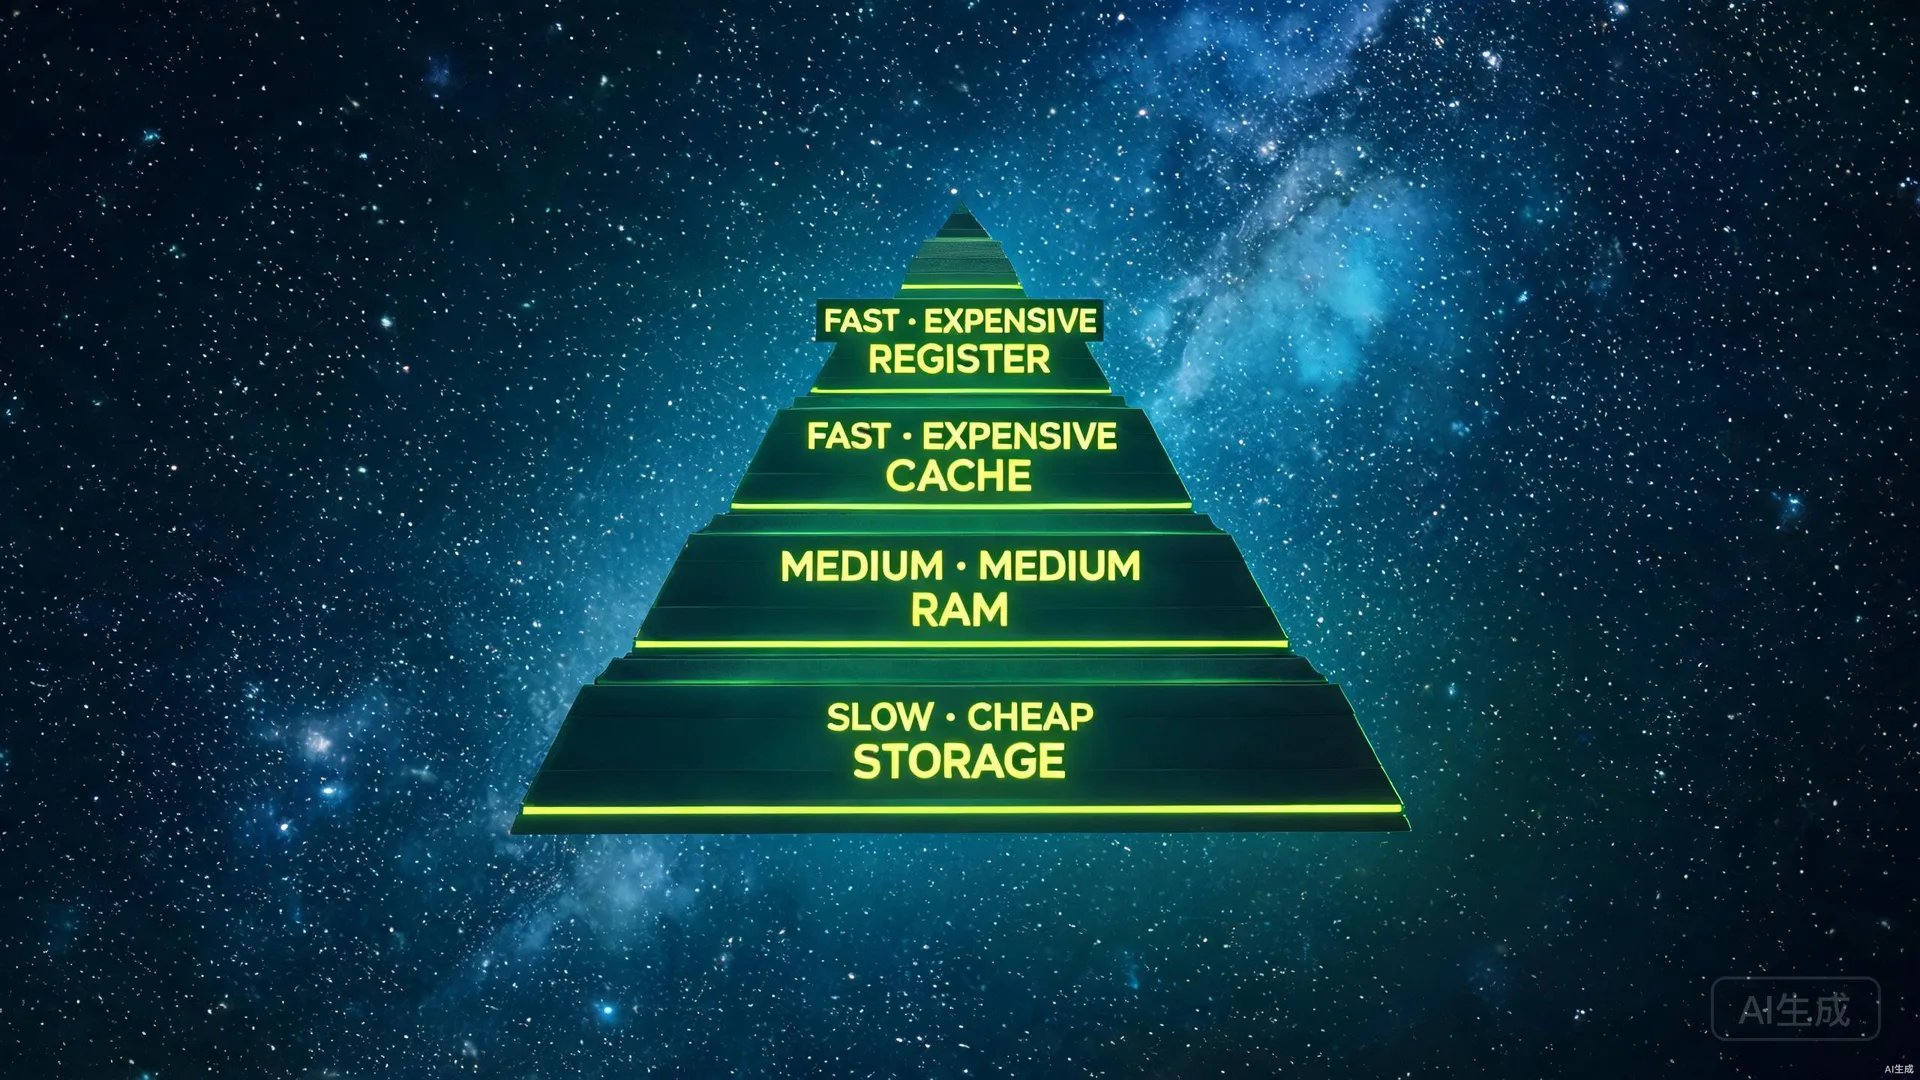
脚下是晶圆晶格铺成的金色大地,头顶是无数闪烁的星辰,每一颗星辰明灭一次就是一个 bit 的存取。星辰疏密不同、颜色不同、明灭速度不同——
- 最靠近身边的星辰最亮,明灭最快(ns 级一闪),数量少,颜色纯白——那是寄存器,在 CPU 核心内部
- 稍远一些,星辰密了几万倍,明灭稍慢(1-2ns),颜色银白——SRAM 缓存
- 再远,星辰密了几百万倍,明灭较慢(~100ns),颜色淡蓝——DRAM 主存
- 更远,星海铺展成银河,明灭慢得多(μs-ms 级),颜色深蓝——SSD NAND 闪存
- 最远处是一片沉重的暗金色星云,旋转缓慢(ms 级)——HDD 机械硬盘
 萨支唐
「这是存储器金字塔——从快到慢、从贵到便宜、从易失到非易失、从稀到密。存储器是计算机中"记忆"的物理载体——没有存储器,算过的数据立刻丢失,CPU 就是一个傻子。」
 肖克利
「1967 年姜大元(Kahng)和施敏(Sze)在贝尔实验室发明浮栅非易失存储;1970 年 Intel 1102 1kb SRAM;1970 年 Intel 1103 1kb DRAM;1987 年 Toshiba 舛冈富士雄发明 NAND Flash——每一次存储器件革命,都让计算机小一个数量级、便宜一个数量级。」
萨支唐继续:「评价一种存储器,看五个指标——」五颗金色星辰在你面前排成五角星:速度(Access Time)、密度(Density,决定成本)、功耗(读/写/待机)、非易失性(断电后数据保持时间)、耐久性(Endurance,能承受多少次写入)。
萨支唐
「这五者——永远不可能同时最优。SRAM 快但贵(6 管占面积);DRAM 密但要刷新;Flash 非易失但写慢有磨损;MRAM 快要来了但密度和成本还不够。工程师要根据应用选——这就是存储器金字塔存在的物理原因。」
存储金字塔 · 五指标权衡
下注:哪一句是存储器金字塔分层的"物理必然"解释?
详解 · K16-01 存储器分类与层级体系
存储器按易失性分两大类:易失性(Volatile)断电即丢——SRAM(双稳态正反馈锁存,只要 VDD 在就保持)和 DRAM(电容存电荷,漏电 64ms 刷新);非易失性(Non-Volatile)断电保持——Flash(浮栅/电荷俘获,势垒囚禁电子 10 年)、MRAM(磁矩方向)、PCRAM(晶态/非晶态电阻差)、ReRAM(导电细丝通断)。层级体系(Memory Hierarchy)由 Hennessy & Patterson 在《Computer Architecture: A Quantitative Approach》中系统化:L0 寄存器(<1ns,KB 级,触发器)→ L1/L2/L3 SRAM 缓存(1-10ns,MB 级,6T 单元)→ DRAM 主存(50-100ns,GB 级,1T1C)→ NAND SSD(10-100μs,TB 级,浮栅串联)→ HDD/磁带(5-10ms,PB 级,磁记录)。每层容量约增 100-1000 倍、速度约降 10-100 倍、每 bit 成本约降 10-100 倍。金字塔存在的根本原因是物理互斥:速度与密度矛盾(6T 占面积换速度 vs 1T1C 极简换密度)、速度与非易失矛盾(电荷存储快但漏 vs 势垒囚禁持久但写慢)。局部性原理(Locality)——时间局部性和空间局部性——让层级体系有效:CPU 90% 时间访问 10% 数据,缓存命中率 >95% 使平均访问时间逼近 SRAM。(Streetman Ch9; Sze Ch7; Hennessy & Patterson Ch5)
详解 · K16-16 存储器性能指标:速度/密度/功耗/成本/耐久性
评价存储器的五维指标互相制约,构成工程折中空间。①速度(Access Time):寄存器 <0.5ns、L1 SRAM 1-2ns、L3 10-20ns、DRAM 50-100ns(tRCD+tCL)、NAND 25-100μs(页读)、HDD 5-10ms(寻道+旋转)。②密度(Bit Density):3nm SRAM 0.021μm²/bit、1α DRAM 0.002μm²/bit(6F²,F=18nm)、200 层 3D NAND 等效 ~0.001μm²/bit(垂直堆叠后平面投影)。密度决定每 GB 成本。③功耗:SRAM 待机漏电 ~nA/bit(VDD=0.7V 时 ~pW/bit)、DRAM 刷新功耗占待机 30-40%(DDR4 典型 1.5W/8Gb 其中刷新 ~0.5W)、NAND 编程 ~20μJ/page(F-N 隧穿需 18-20V 电荷泵)。④成本($/GB,2024 年量级):SRAM ~$1000/GB(嵌入逻辑 die)、DRAM ~$3-5/GB、3D NAND ~$0.05-0.1/GB、HDD ~$0.015/GB。⑤耐久性(Endurance,P/E cycles):SRAM/DRAM 无限(>10¹⁶)、SLC Flash ~10⁵、MLC ~10⁴、TLC ~10³、QLC ~300、MRAM >10¹²、PCRAM ~10⁸、ReRAM ~10⁶-10⁹。五维雷达图上没有任何一种存储能同时占满——这就是金字塔分层的工程必然。(Streetman Ch9; Sze Ch7; ITRS 2.0 Emerging Research Devices)
双稳之锁
你停在 SRAM 星域一颗明亮的星辰前。星辰放大变成一个六管电路——这就是 6T SRAM bitcell:
- M1(NMOS 下拉)+ M3(PMOS 上拉) 组成反相器 1,输入 Q、输出 QB
- M2(NMOS 下拉)+ M4(PMOS 上拉) 组成反相器 2,输入 QB、输出 Q
- 两个反相器交叉耦合:反相器 1 输出 Q 接反相器 2 输入 QB 端,反相器 2 输出 QB 接反相器 1 输入 Q——互相输入对方的输出
- M5/M6(NMOS 访问管):字线 WL 接栅极,位线 BL/BLB 接源漏,M5 连 Q 和 BL、M6 连 QB 和 BLB
萨支唐
「看——两个反相器交叉耦合后,有两个稳态。稳态 1:Q=0, QB=1(存"0")——Q=0 → 反相器 2 输入 0 → 输出 QB=1 → 反相器 1 输入 1 → 输出 Q=0,自洽锁定。稳态 2:Q=1, QB=0(存"1")——同样自洽。中间点 Q=QB=VDD/2 是亚稳态(metastable,像笔倒立),任何微扰都会把它推到一个稳态。只要 VDD 在,正反馈就会把状态锁住——这就是'记忆'。」
萨支唐
「待机时 WL=0,M5/M6 关断,两个反相器形成闭环正反馈,状态自己保持——静态功耗只有漏电流(nA 级/bit)。但 6 管占面积大(~0.02μm²/bit @ 3nm,是 DRAM 的 10 倍)——这就是 SRAM 快但密的代价。」
你观察 6T 单元——上拉 PMOS 通常做很弱(小 W/L)、下拉 NMOS 做很强(大 W/L)、访问管 M5/M6 中等——这种比例(pull-up : pass-gate : pull-down 通常 1 : 1.5 : 2)是为了读/写容限(下一场 S2 讲)。
双稳态可视化 · β 比与正反馈环
操作提示:① 切换"稳态 1/2/亚稳态"看 Q/QB 自洽环 ② 调 β 比看正反馈强度 ③ 把 β_p/β_n 调到 1(上拉=下拉)看读容限崩
详解 · K16-02 SRAM 基本单元(6T)结构与工作原理
6T SRAM bitcell 由两个交叉耦合 CMOS 反相器(M1/M3 和 M2/M4)加两个 NMOS 访问管(M5/M6)组成。反相器 1 输出 Q 接反相器 2 输入,反相器 2 输出 QB 接反相器 1 输入——形成正反馈环路。环路增益 A = gm,N·ro,N·gm,P·ro,P ≫ 1(典型 >100),使系统只有两个稳态:Q=0/QB=1(存"0")和 Q=1/QB=0(存"1")。中间点 Q=QB=VDD/2 是不稳定平衡(亚稳态),任何微扰(热噪声 kT/q≈26mV)都会在 τ = Cnode/(gm1+gm2) ≈ 10-50ps 内指数放大到轨。待机时 WL=0,M5/M6 关断,环路自持——静态功耗仅亚阈值漏电(FinFET @VDD=0.7V 约 1-10nA/bit)。晶体管尺寸比是设计核心:下拉 NMOS(M1/M2)最强(W/L 最大)保证读稳定(βratio = PD/PG > 1.5);访问管(M5/M6)中等;上拉 PMOS(M3/M4)最弱(最小尺寸)保证写能翻转。面积:TSMC N3 节点 0.021μm²/bit(6T 占 6 个 FinFET),是同节点 DRAM 1T1C(~0.002μm²)的 10 倍——这就是 SRAM 快但贵的物理根源。历史:1963 年 Schmidlin & Farber(Bell Labs)做出第一个 6T SRAM;1969 年 Intel 1101(256-bit 双极型);1971 年 Intel 2102(1kb MOS);2024 年单 die L3 缓存已达 256MB+(AMD 3D V-Cache)。(Sze Ch7; Streetman Ch9; Rabaey Ch12)
读写之边
「读、写——是 SRAM 的两个核心操作。」萨支唐说。
【读操作】假设存"0"(Q=0, QB=1)。① BL/BLB 预充到 VDD=1V ② WL 拉高到 VDD→M5/M6 导通 ③ 对 BLB:QB=1 通过 M6 接 BLB(VDD)→BLB 保持 VDD ④ 对 BL:Q=0 通过 M5 接 BL(预充 1V)→BL 通过 M5 和 M1(下拉到地)放电,电压下降。
关键问题:BL 放电时,Q 点电压从 0 被 M5 上拉——Q 点电压上升多少取决于 M5(访问管)和 M1(下拉管)的电导比——读容限要求 M1>M5,让 Q 点电压 < VM(反相器翻转点),否则 Q 升到 VM 以上反相器 2 翻转,读翻转(read upset),数据被破坏。β_ratio = (W/L)1/(W/L)5 > 1.2~2 通常是设计目标。
【写操作】写"0"到"1"单元(原 Q=1, QB=0):① BL=0, BLB=1 ② WL 拉高 M5/M6 导通 ③ BLB=1 通过 M6 把 QB 从 0 上拉到 1,需要 M6 的电流大于 M2 下拉电流 ④ 同时 BL=0 通过 M5 把 Q 从 1 下拉到 0。写容限要求访问管 M5/M6 强于上拉管 M3/M4——所以上拉 PMOS 通常做最小尺寸。写是"强制翻转"操作。
萨支唐
「SNM 静态噪声容限——把两个反相器的 VTC 画在一起、一个转置 90°——得到蝶形图(butterfly curve)。蝶形两个眼睛能嵌套的最大正方形边长就是 SNM(典型 150-250mV @ VDD=1V)。SNM 随 VDD 降低而减小,到 VDD_min(数据保持电压≈0.3-0.5V)时 SNM→0,单元失效。」
低电压 SRAM 设计的核心是提高 SNM——用 8T/10T 单元(独立读写端口)、Schmitt 触发、FinFET 器件(steeper subthreshold)等手段。
读写操作实验台 · β 比滑块 + V_DD → SNM
操作提示:① 调 β_ratio(M1/M5)< 1 看读翻转 ② 调 β_p/β_pg(M3/M6)过大看写失败 ③ 降 V_DD 看 SNM 蝶形图收缩 → 刻痕
详解 · K16-03 SRAM 的读/写操作与稳定性分析
读操作:BL/BLB 预充 VDD → WL 拉高 → 存"0"侧(Q=0)BL 经 M5+M1 放电,Q 点被 M5 上抬。读稳定性判据:Q 点电压必须 < 反相器 2 翻转点 VM2,否则正反馈翻转数据(Read Upset)。读静态噪声容限 RSNM = 蝶形图左眼内接最大正方形边长,要求 βratio = (W/L)M1/(W/L)M5 > 1.5-2.0。典型 RSNM@VDD=1.0V ≈ 150-250mV;VDD 降到 0.5V 时 RSNM 缩至 <50mV,逼近 Vt 失配(σVt≈20-40mV @FinFET),良率骤降。写操作:BL=0/BLB=VDD → WL 高 → 访问管 M6 把 QB 从 0 上拉,需克服 M2 下拉。写能力判据:写翻转点 WTP——使内部节点翻转所需的最小 BL 电压差。上拉 PMOS 越弱(W/L 最小)写越容易。写裕量 WM = VDD - WTP,典型 200-400mV。读稳和写翻对 β 比要求相反——读要 PD≫PG,写要 PG≫PU——6T 单元的设计空间是两者交集。SNM 蝶形图:将两个反相器 VTC 正交叠画(一个转置 90°),两个"眼"的内接正方形边长即 Hold SNM / Read SNM。VDD,min:SNM→0 的电压,6T FinFET 典型 0.4-0.5V(数据保持);读操作 VDD,min 更高(~0.55-0.65V)。8T/10T 单元:增加独立读端口(2 个 NMOS 做读位线),读时不扰动存储节点——RSNM 退化为 Hold SNM,VDD,min 可降到 0.3V 以下。代价:面积增 33-67%。Intel/TSMC 在 sub-1V 嵌入式 SRAM 中采用 8T。(Sze Ch7; Rabaey Ch12; Grossman ISSCC 2006 8T SRAM)
读眼之灵
BL 和 BLB 上只有 50-100mV 差分——这个信号太弱,不能直接送进数字逻辑。需要灵敏放大器(Sense Amplifier, SA)把 mV 差分放大到 0/VDD。
萨支唐
「你在 ch15 学的差分对——加上正反馈锁存,就是灵敏放大器。」
经典时钟控制锁存型灵敏放大器(StrongARM/SAE):
- 预充阶段(SAE=0):输出节点 OUT/OUTB 预充到 VDD
- 放大阶段(SAE=1,时钟上升沿):差分对(NMOS 对)感应 BL/BLB 差分电压,一边电流稍大、一边稍小→交叉耦合反相器正反馈把小差分雪崩放大到轨到轨→OUT=0/1, OUTB=1/0
- 锁存阶段:放大后正反馈保持结果,送到数据总线
100ps 内把 50mV 差分放大到 0 和 1V——这是模拟差分放大 + 数字正反馈锁存的完美结合。
萨支唐
「SA 是存储器的'读眼'——它的灵敏度(能分辨多小差分)和速度(多久放大到轨)决定了存储器的读延迟和良率。工艺偏差让差分对 Vt 失配,失调电压 Vos 限制最小可分辨差分——典型 Vos=10-30mV(大 W/L 器件可减小)。」
SA 时序实验台 · 差分输入 + V_t 失配
操作提示:① 调差分输入 ΔV 看 SA 雪崩放大 ② 给 V_t 失配 ±20mV 看最小可分辨差分 ③ 大 W/L 减小失配
详解 · K16-04 灵敏放大器原理
灵敏放大器(Sense Amplifier, SA)是存储器读通路的核心——把位线上 50-100mV 的微弱差分信号在 100-300ps 内放大到轨到轨(0/VDD)。经典结构是时钟控制锁存型 SA(StrongARM / SAE):①预充阶段(SAE=0):输出节点 OUT/OUTB 预充到 VDD,差分对尾电流源关断;②放大阶段(SAE=1,时钟上升沿):NMOS 差分对(输入 BL/BLB)感应差分电压 ΔV,一侧电流稍大 → 交叉耦合 PMOS 正反馈把电流差雪崩放大 → 一侧 OUT 拉到 0、另一侧保持 VDD。再生(regeneration)时间常数 τregen = Cout/(gm,latch) ≈ 20-50ps,放大到轨需 ~3-5τ ≈ 100-250ps。③锁存阶段:正反馈自持结果,送数据总线。失调电压 Vos:差分对 Vt 失配(Pelgrom 模型 σΔVt = AVt/√(W·L),FinFET AVt≈2-4mV·μm)导致 SA 有固有偏移,典型 Vos=10-30mV。最小可分辨差分 ΔVmin > Vos + 3σnoise。增大差分对 W/L 可减小 Vos(但增面积和功耗)。SA 是模拟-数字桥梁:输入是模拟差分(mV 级),输出是数字轨(0/VDD),时钟控制采样时刻——本质上是一个 1-bit 闪烁型 ADC。DRAM 每列一个 SA(共享 512-1024 列),SRAM 每 bank 一组 SA。SA 速度直接决定存储器读延迟 tAA。(Rabaey Ch12; Sze Ch7; Schinkel ISSCC 2007 StrongARM)
电容之泪
你从 SRAM 星域继续前行——星辰从 6 管电路变成 1 管 + 1 个小电容。
DRAM 1T1C:一个 NMOS 管(T——访问管/字管)+ 一个存储电容 CS(电容值 10-30fF,f=10⁻¹⁵)。
写:BL 设 0 或 VDD → WL 高 → CS 通过 T 充电到 VDD(写 1)或放电到 0(写 0)。
读:① BL 预充到 VDD/2 ② WL 高 T 导通 ③ CS 和 BL 的寄生电容 CBL(~100-200fF)电荷分享:写 1 时 CS 电压=VDD → 分享后 BL 上升 ΔV=VDD·CS/(CS+CBL)/2 ≈ 100mV;写 0 时下降 100mV ④ SA 放大差分 ⑤ 读后 CS 电荷被改变(破坏性读)→ 必须回写(write-back)。
萨支唐
「注意——CS 只有 30fF。即使 T 关断(WL=0),亚阈值漏电 Ioff≈fA 级,加上 PN 结反向漏电 ~pA 级,且高温(85°C)漏电翻 10-100 倍。实际数据保持时间 tret≈64ms(工业标准)。」
你看到电容上的电荷像沙漏里的沙子一样一点一点漏走——金色的电子通过 M1 亚阈值沟道和 PN 结漏电流慢慢流失,CS 电压在几十 ms 里从 VDD 掉到 VDD/2 以下,数据丢失。
 熵魔
「记住——电容不能存永恒的电。所有电容都会漏电,这是热力学。你们能做的只是每 64ms 把所有行读一遍、回写一遍——刷新(refresh)。但 1T1C 的代价换来了什么?1 个管+1 个电容 vs 6 个管——密度是 SRAM 的 10-30 倍。」
刷新:内存控制器每 64ms 把每一行激活→读(SA 放大)→回写,把 CS 重新充到满电/放空。刷新消耗功耗(DDR4 DRAM 刷新功耗占待机功耗 30-40%)、占用带宽(刷新期间不能读写)、刷新周期随温度缩短(DDR4 有自动温度补偿刷新)。
1T1C 实验台 · C_S + 温度 → 信号 ΔV 与保持时间
操作提示:① 调 C_S 看电荷分享信号 ΔV ② 升温到 85°C 看 t_ret 从 200ms 骤降到 3ms(漏电 64 倍) ③ 把 C_S 缩到 1fF(想更密)→ ΔV<20mV SA 读不出 → 刻痕
详解 · K16-05 DRAM 基本单元(1T1C)结构与工作原理
DRAM bitcell 极简:一个 NMOS 访问管(T)+ 一个存储电容(CS=10-30fF)。写入:BL 设 VDD(写 1)或 0(写 0)→ WL 拉高 → CS 经 T 充/放电。读出(破坏性):①BL 预充 VDD/2 ②WL 高 T 导通 ③CS 与 BL 寄生电容 CBL(100-200fF)电荷分享:ΔV = CS/(CS+CBL) × VDD/2。手算:CS=25fF, CBL=200fF, VDD=1.2V → ΔV = 25/225 × 0.6 = 66.7mV(写 1 时 BL 升,写 0 时 BL 降)。④SA 放大差分到轨 ⑤读后 CS 电荷被改变(破坏性读)→ SA 输出同时回写(write-back)恢复原始数据。1T1C 面积 ≈ 6F²(F=特征尺寸),1α nm DRAM(F≈18nm)单元 ~0.002μm²/bit,是 3nm SRAM(0.021μm²)的 1/10——密度优势来自极简结构。代价:CS 小 → ΔV 小 → 对 SA 灵敏度要求高;破坏性读 → 每次读都要回写;电容漏电 → 必须刷新。历史:1966 年 Robert Dennard(IBM)发明 1T1C DRAM 并获专利 US3387286;1970 年 Intel 1103(1kb,三管结构过渡);1973 年 Mostek MK4096(4kb,真正 1T1C)。(Sze Ch7; Streetman Ch9; Dennard IBM J. Res. 1968)
详解 · K16-06 DRAM 刷新机制与原因
CS 上的电荷即使 WL=0(T 关断)也会泄漏:①亚阈值漏电 Ioff(FinFET ~fA 级/cell @25°C)②PN 结反向漏电(~fA-pA 级)③GIDL(栅致漏极漏电)。总漏电 ~0.1-1pA/cell @25°C。保持时间 tret = CS·VDD/(4·Ileak)(衰减到 VDD/4 以下 SA 读不出)。手算:CS=25fF, VDD=1.2V, Ileak=0.2pA → τ=150ms, tret=τ·ln4≈208ms。JEDEC 标准刷新间隔 64ms(DDR4/DDR5),给最"漏"的单元留 3× 裕量。温度每升 10°C 漏电约翻一倍(Arrhenius):25°C→85°C 是 6 个 10°C = 64× 漏电增加 → tret 从 208ms 骤降到 ~3ms。DDR4 引入自动温度补偿刷新(ATCR):>85°C 时刷新间隔减半到 32ms。刷新操作:内存控制器逐行激活 → SA 读出 → 回写(恢复满电/放空)。一个 8Gb DRAM 有 65536 行,64ms 内刷完 → 每行 ~977ns 刷一次 → 刷新带宽占用 = 65536×tRAS/64ms ≈ 35%。刷新功耗占 DRAM 待机功耗 30-40%(DDR4 典型 ~0.5W/8Gb)。DDR5 改进:同 bank 刷新(Refresh Same Bank)减少带宽阻塞;on-die ECC(128+8bit SEC)纠正刷新间隔内的单 bit 软错误。熵魔视角:刷新是"周期性做功对抗热力学第二定律"——不刷新,信息必然消散。(Sze Ch7; JEDEC DDR4 JESD79-4; DDR5 JESD79-5)
微缩之困
萨支唐
「摩尔定律让逻辑器件(MOSFET)每代缩 30%——但 DRAM 有个难题:CS 不能按比例缩。CS 太小(<10fF)信号 ΔV 太小 SA 读不出;但 cell 面积按比例缩,电容面积也缩。怎么在更小面积里做足够大的电容?」
电容三维化:
- 深沟槽电容(Deep Trench, DT):在硅片里挖 5-10μm 深、0.1μm 直径的沟槽,内壁长 High-K 介质(Al₂O₃/HfO₂/ZrO₂ k≈20-40),中心填多晶硅一个电极、外围硅衬底另一个电极——在 0.003μm² 占地面积上做 30fF 电容。IBM/英飞凌/美光技术路线。
- 叠层电容(Stack Capacitor):在硅片上堆叠多层柱状/碗状 MIM 电容(金属-绝缘体-金属,TiN/HfO₂/TiN),像摩天楼一样往上盖——三星/海力士路线,柱高 2μm 以上。
两种方法都把电容做成三维结构——"横向不够纵向补",和 ch19 FinFET/GAA 把逻辑器件做三维异曲同工。
DRAM scaling 其他挑战:Vt 波动(随机掺杂涨落 RDF)→ 访问管 Vt 变化 → 漏电变化 → 保持时间分布宽,最"漏"的单元决定刷新周期;字线 RC 延迟;邻单元干扰(位线-位线耦合电容)。解决方案:on-die ECC(DDR5 每 128bit 加 8bit ECC 自动纠错单 bit 错误)、温度补偿刷新、细粒度刷新。
萨支唐
「存储器阵列架构(通用于 SRAM/DRAM/Flash):单个 bitcell 没用——memory 是阵列。行(Row):WL 选中一行;列(Column):BL/BLB 一列,每列一个 SA,列选择 YMUX 选中要读的字节;行地址译码(Row Decoder):行地址 X→2^N 字线选中一个;列地址译码(Column Decoder/Y-MUX):列地址 Y→2^M 选 1。一个典型 DRAM 8Gb:2^16 行 × 2^14 列 × 8 个 bank × 4 个 I/O = 2^33 bit = 8Gb。」
三维电容 + 阵列架构快览台
依次点击:① 深沟槽电容 ② 叠层电容 ③ 阵列架构 ④ ECC/刷新策略(至少各点 1 张)。
详解 · K16-07 DRAM 的 scaling 挑战与解决方案
摩尔定律要求每代单元面积缩 ~0.7×(线性缩 30%),但 CS 不能等比缩——ΔV = CS/(CS+CBL)×VDD/2 必须 > SA 失调(~30mV),否则读不出。平面电容 C = εox·A/tox:面积 A 缩 → C 缩;tox 不能无限薄(<2nm 直接隧穿漏电暴增)。解决方案:三维电容——"横向不够纵向补"。①深沟槽电容(Deep Trench, DT):硅片中刻蚀 5-10μm 深、~100nm 直径沟槽,内壁生长 High-K 介质(Al₂O₃ κ≈9 / HfO₂ κ≈25 / ZrO₂ κ≈35),中心填多晶硅做上电极、硅衬底做下电极。有效面积 = π·d·h ≈ π×0.1×8 = 2.5μm²(平面占地仅 0.008μm²),C ≈ 30fF。IBM/英飞凌/美光路线。②叠层电容(Stack Capacitor):硅片上方堆叠柱状/碗状 MIM(TiN/HfO₂/TiN),柱高 2-4μm,三星/海力士路线。两种方法都在 <0.01μm² 占地面积上实现 25-30fF。其他 scaling 挑战:①Vt 波动(随机掺杂涨落 RDF,σVt ∝ 1/√(W·L·NA))→ 漏电流分布宽 → 最"漏"单元决定刷新周期;②字线 RC 延迟(WL 长 ~1mm,RWL~kΩ,CWL~pF → τ~ns 级)限制行激活速度;③邻位线耦合电容 → 读干扰。系统级对策:on-die ECC(DDR5 每 128bit+8bit SEC 码,纠正单 bit 软错误/弱单元)、温度补偿刷新、细粒度刷新(per-bank refresh)。(Sze Ch7; ITRS 2.0 DRAM Roadmap; Samsung V-Cap ISSCC)
详解 · K16-08 地址译码与存储器阵列架构
单个 bitcell 无用——存储器是阵列。架构核心:行(Row)× 列(Column)+ 行列译码 + SA 阵列 + Bank 并行。行译码(Row Decoder):行地址 X(N bit)→ 2N 条字线选 1(全译码)。一条 WL 上挂 512-1024 个 cell,WL 拉高后所有 cell 同时与 BL 电荷分享,每列 SA 同时放大——这是 DRAM 高带宽的来源(一次行激活读出整行 ~8KB)。列译码(Column Decoder / Y-MUX):列地址 Y(M bit)→ 从 2M 条 BL 中选 4-8 条送数据总线 I/O。地址复用(RAS/CAS):DRAM 封装引脚有限,行地址和列地址分两拍送(先 RAS 后 CAS),引脚数减半。现代 DDR 用 BA(Bank Address)+ ROW + COL 三组。Bank 结构:一个 DRAM die 分 8-32 个 bank,每 bank 独立阵列+SA,可并行操作(一个 bank 在刷新/预充,另一个在读/写)→ 隐藏延迟。手算 8Gb DDR4:8Gb = 233 bit。组织:8 bank × 216 row × 214 col × 4 I/O = 8×65536×16384×4 = 23×216×214×22 = 235... 实际 DDR4 8Gb:16 bank group × 215 row × 211 col × 8 I/O = 24×215×211×23 = 233 = 8Gb ✓。行大小 = 211×8 = 16Kbit = 2KB/行。tRCD(行到列延迟)~14ns,tRP(预充)~14ns,tRAS(行激活)~32ns。SRAM 阵列类似但无 RAS/CAS 复用(地址一次给完),bank 数更多(L3 可达 16-32 slice)。(Rabaey Ch12; JEDEC DDR4; Hennessy & Patterson Ch5)
浮栅之囚
DRAM 的电容即使刷新也只保持 64ms——但你继续向星海深处走,星辰变得更沉稳、更暗,明灭次数明显变少(读慢),但断电后它们仍然在发光——这是 Flash 存储的星域。
一颗星辰放大——不是 6 管、不是 1T1C,而是一个看起来像 MOSFET 但栅极分两层的管子:浮栅晶体管(Floating Gate Transistor, FGT):
- 衬底:P 型硅
- 隧道氧化层:SiO₂ 厚度 5-10nm(栅氧化层比 MOSFET 厚),包围浮栅
- 浮栅(FG):多晶硅"岛",被 SiO₂ 完全包围(上下前后都是氧化层,没有电接触,像一座孤岛)
- 栅间氧化层(ONO 叠层:Oxide-Nitride-Oxide,介电常数高)
- 控制栅(CG):外部字线加电压的端口
- 源/漏:N⁺ 扩散区
萨支唐
「浮栅——是存储器件最精妙的发明之一。Kahng 和施敏 1967 年在贝尔实验室发明浮栅器件时,只是做了件简单的事:在栅氧化层中间埋一个多晶硅'岛'。这个岛被 SiO₂(禁带宽~9eV、电阻率极高)完全包围——岛上的电子要逃出去必须穿过 SiO₂ 的势垒,室温下势垒太高、隧穿概率极低——电子被困在岛上可达 10 年甚至 100 年。这就是非易失(non-volatile)。」
你看着浮栅的结构——浮栅确实是被 SiO₂ 四面包围的孤岛,里面的电子(画成金色小点)在岛上跳跃但逃不出去。
编程(写 0,电子注入浮栅)两种方法:
① Fowler-Nordheim(F-N)隧穿(NAND Flash、NOR 擦除用):控制栅加高压 VCG=+18V~20V,源漏接地。氧化层电场 E=VCG/tox≈20V/10nm=20MV/cm——强电场把氧化层势垒压成三角形,电子通过量子隧穿穿过三角形势垒注入浮栅。浮栅带负电 → Vt 从 ~2V 升到 ~5V,读时 CG 加 Vread=3.5V(介于两个 Vt 之间)→ 管子不通 → BL 电流小 → 读为 0。
② Channel Hot Electron(CHE)热电子注入(NOR Flash 编程用):漏极加 +5-7V,源接地,CG 加 +8-10V。沟道电子被横向电场加速到高能量("热"),一部分电子能量超过 Si/SiO₂ 势垒 3.1eV → 越过势垒注入浮栅。CHE 编程快(μs/byte 级),但功耗大(有大电流)。
擦除(写 1,电子从浮栅走):F-N 隧穿反向——源极加 +12V 或衬底加高压、CG 接地/负压,电场反过来让电子从浮栅隧穿到源/衬底。浮栅失去负电 → Vt 回到 ~-1V~-2V。
你看到编程时电子像潮水一样涌入浮栅岛、擦除时又像退潮一样离开——但氧化层是电子的"牢墙",没有高压,墙不可越。
浮栅剖面 + 隧穿实验台 · V_CG → V_t 窗口
依次点击 tab:① 浮栅剖面(电子被囚禁)② F-N 隧穿(势垒三角化)③ CHE 热电子对比 ④ 保持时间(10 年电荷损失)。
详解 · K16-09 Flash 存储器:浮栅原理与 F-N 隧穿
浮栅晶体管(FGT)在 MOSFET 栅极中嵌入一个被 SiO₂ 完全包围的多晶硅"岛"(浮栅 FG)。SiO₂ 禁带宽 ~9eV,Si/SiO₂ 导带偏移 ΔEC=3.1eV——室温下电子热激发越过 3.1eV 势垒的概率 ∝ exp(-3.1/0.026) ≈ 10-52,实际上为零。电子一旦注入浮栅,无外部能量时被困 10-100 年(非易失性来源)。浮栅带负电 → 屏蔽控制栅电压 → Vt 升高:Vt = Vt0 + QFG/Cox,CG。编程态(有电子)Vt≈5-7V,擦除态(无电子)Vt≈-1~2V,Vt 窗口 ~5-8V。Fowler-Nordheim(F-N)隧穿:氧化层加高压 E > 8-10MV/cm 时,三角形势垒宽度 dB = ΦB/(qE)(ΦB=3.1eV)缩到 ~3-4nm,电子量子隧穿概率 T ≈ exp(-B·ΦB3/2/E),B=6.83×10⁷ V/(cm·eV3/2)。手算:E=20MV/cm(VCG=20V, tox=10nm)→ T ≈ exp(-6.83×10⁷×3.11.5/2×10⁷) = exp(-18.8) ≈ 7×10⁻⁹——看似小,但 1014 个电子/cm² 尝试 → 隧穿电流密度 J ≈ 10⁻⁴-10⁻³ A/cm²,足够在 μs-ms 内注入 10⁶-10⁷ 个电子改变 Vt。F-N 隧穿是 NAND Flash 编程/擦除和 NOR 擦除的主要机制。Kahng & Sze 1967 年贝尔实验室首次演示浮栅器件。(Sze Ch7; Kahng & Sze, Solid-State Electron. 1967; Lenzlinger & Snow, J. Appl. Phys. 1969 F-N 实验验证)
详解 · K16-12 浮栅存储器的编程/擦除机制深度
两种写入机制对比:①F-N 隧穿(NAND 编程/擦除、NOR 擦除):垂直电场驱动,氧化层 E≈20MV/cm,电子隧穿穿过整个 tox(5-10nm)。优点:功耗低(隧穿电流 ~μA 级)、可批量并行(NAND 整页同时编程);缺点:速度慢(μs-ms/page)、需片上电荷泵把 VCC=3V 升到 18-20V(Dickson 电荷泵,效率 ~60-70%)。②CHE 热电子注入(NOR 编程):横向电场加速沟道电子到 >3.1eV 动能,越过 Si/SiO₂ 势垒注入浮栅。VD=5-7V, VCG=8-10V。优点:快(~1μs/byte);缺点:功耗大(mA 级沟道电流)、只能逐字节编程、热电子损伤界面态。擦除:F-N 反向——源/衬底加 +12V 或 CG 负压,电子从 FG 隧穿回源。NAND 按块擦除(几百页同时),NOR 按扇区擦除。多值存储(MLC/TLC/QLC):Vt 窗口分 2/4/8/16 个等级存 1/2/3/4 bit。TLC 需要 8 个 Vt 态,相邻态间距 ~0.5-0.7V——编程精度要求 ±0.2V,迭代编程(ISPP, Incremental Step Pulse Programming)每步 +0.2V 验证直到达标。Vt 分布展宽来源:cell 间 tox 涨落(±0.3nm)、耦合干扰(邻 cell 编程通过 CFG-FG 影响)、P/E 磨损后陷阱辅助隧穿。分布 overlap → 误码 → LDPC ECC 纠错(TLC/QLC 必须)。(Sze Ch7; 陶元《半导体存储器》3版 Ch12; Micron TN-29-07 ISPP)
串并之分
NOR Flash(1988,Intel):浮栅管独立连到位线(每个管漏接 BL,源共接),读时给 WL 一个地址→一个管子导通/关断→BL 直接出数据。随机读取≈100ns(和 DRAM 相近,慢于 SRAM),可以 XIP(eXecute In Place,CPU 直接从 NOR 取指令执行),但密度低、擦除慢、容量小(MB-GB 级)。用于 BIOS、路由器固件、MCU 代码存储。
NAND Flash(1987,Toshiba 舛冈富士雄):浮栅管串成串(string)——16/32/64 个浮栅管串联,串顶端接位线(经 SGD 选通管)、串底端接公共源线(经 SGS 选通管)。同一页(page,2-16KB)共享 WL,编程/读取按页进行。读时选中 WL 加 Vread=0V(读 0 看 Vt)、未选中 WL 加 Vpass=8V(让它们不管编程态都导通)→ 串导通/不通由选中管决定。擦除以块(block,几十到几百页)为单位。
NAND 优点:密度高(cell size≈4F² vs NOR 8-10F²)、容量大(GB-TB 级)、页编程快;缺点:读是串行(μs 级)、不能 XIP、有位错误需要 ECC、按块擦除。SSD、U 盘、手机存储、SD 卡都是 NAND。
3D NAND(垂直 NAND/V-NAND,三星 2013 年量产):2D NAND 缩到 15nm 以下时浮栅间耦合电容变大、邻单元干扰严重,缩不动了——工程师把存储串垂直堆起来:存储孔(channel hole)3D 刻蚀出直径 100nm、深 10μm 的圆孔,内壁做沟道多晶硅(垂直沟道);栅极层层堆叠金属/氧化层(3D NAND 用电荷俘获型 CTF:SiN 电荷俘获层代替多晶硅浮栅,工艺更简单、耦合更小)。一个孔内串 64-200+ 层 WL,每片晶圆堆 200+ 层→每片 1Tb+ 密度。
萨支唐
「但浮栅/电荷俘获有个根本问题——每次 F-N 隧穿编程/擦除(P/E 循环),电子穿过氧化层时部分电子被氧化层/SiN 陷阱永久俘获→氧化层逐渐损伤→Vt 窗口(编程态和擦除态 Vt 差)变窄;同时氧化层中产生陷阱辅助隧穿路径→漏电流增大→保持时间缩短。」
P/E 循环次数(Endurance):SLC(1bit/cell)~10 万次;MLC(2bit/cell)~3 千-1 万次;TLC(3bit/cell)~1 千次;QLC(4bit/cell)~100-300 次;PLC(5bit/cell)~几十次。多 bit/cell 密度高但耐久低。SSD 靠磨损均衡(wear leveling)——FTL 固件把写入均匀分布到所有块、坏块标记、ECC 纠错(LDPC 码)、OP over-provisioning(额外容量做替换)来延长寿命。
熵魔
「你每次写一次 Flash,我就在氧化层里凿一个小洞——写 1000 次,墙就漏了。没有什么是永恒的——连石头(硅)都扛不住时间。」
NAND/NOR/3D NAND/磨损 快览台
依次点击 tab:① NOR 拓扑 ② NAND 串联(V_pass=8V 关键)③ 3D NAND 垂直堆叠 ④ P/E 磨损与磨损均衡(至少各点 1 张)。
详解 · K16-10 NAND Flash 与 NOR Flash 对比
NOR Flash(Intel 1988):浮栅管并联——每管漏极独立接 BL,源极共接。读:选中 WL 加 Vread,单管导通/关断直接决定 BL 电流 → 随机字节读取 ~60-100ns(接近 DRAM),支持 XIP(CPU 直接从 NOR 取指执行,无需先拷贝到 RAM)。写:CHE 热电子逐字节编程 ~5-10μs/byte。擦:F-N 按扇区(64-128KB)~0.5-1s。单元面积 8-10F²(每管需独立漏接触)。容量小(MB-GB 级)。应用:BIOS/UEFI 固件、路由器 Flash、MCU 内嵌代码存储、汽车 ECU。NAND Flash(Toshiba 舛冈富士雄 1987):浮栅管串联成 string(16/32/64/200+ 管)——串顶经 SGD 选通管接 BL,串底经 SGS 接公共源线。读:选中 WL 加 Vread=0V,未选中 WL 加 Vpass=8V(强制导通不管 Vt 态)→ 串电流通断由选中管单独决定。页读(2-16KB)~25-100μs(串行感应慢)。写:F-N 按页编程 ~200-500μs/page(ISPP 迭代)。擦:F-N 按块(256-512 页)~3-10ms。单元面积 4F²(串联共享源漏接触,无独立漏孔)→ 密度是 NOR 的 2-2.5×。容量大(GB-TB 级)。不能 XIP、有位错误需 ECC(BCH/LDPC)。应用:SSD、U 盘、SD/eMMC/UFS、手机存储。核心权衡:NOR 快读小容量 vs NAND 高密度大容量——两者共存于不同应用生态。(Sze Ch7; Toshiba NAND 原始专利 JPS60-194586; Intel NOR EP0273085)
详解 · K16-11 3D NAND 的堆叠工艺与电荷俘获机制
2D NAND 缩到 15-19nm 时遭遇物理墙:①浮栅间耦合电容 CFG-FG 随间距缩小急剧增大 → 邻 cell Vt 干扰(program disturb)②tox <7nm 后 F-N 隧穿漏电暴增 → 保持时间不够 ③光刻 pitch 极限。解决:把存储串垂直立起来——3D NAND(V-NAND)。工艺核心:①交替沉积 100-300+ 层 SiN/SiO₂(或 SiN/Al₂O₃)叠层,总厚 5-15μm ②一次刻蚀穿透整个叠层打出 channel hole(直径 ~100-150nm,深宽比 >50:1,高深宽比刻蚀 HAR 是关键工艺)③孔壁依次沉积:blocking oxide(Al₂O₃)→ 电荷俘获层(Si₃N₄,~5-7nm)→ tunnel oxide(SiO₂)→ 多晶硅沟道 → 中心填 SiO₂ ④替换栅极(Gate Replacement):湿法去掉 SiN 牺牲层,填入 W/TiN 金属做 WL。电荷俘获(CTF)vs 浮栅:SiN 中氮空位陷阱(能量深度 ~1-3eV)俘获电子——离散陷阱点而非连续导电岛。优势:①陷阱间无横向扩散 → cell 间耦合小(无 CFG-FG)②局部缺陷不导致全部电荷丢失(可靠性好)③工艺简单(无需浮栅多晶硅图案化)。劣势:俘获/释放动力学比浮栅慢 → 编程/擦除速度稍逊。层数演进:Samsung 2013 V-NAND 24层 → 2014 32层 → 2016 64层 → 2019 96层 → 2021 128层 → 2023 236层 → 2025 300+层。SK Hynix/美光/长江存储同步推进。每代层数增 ~1.3-1.5×,配合 TLC/QLC 实现单 die 1Tb+。(Sze Ch7; Samsung V-NAND ISSCC 2013; ITRS 2.0 3D NAND Roadmap)
自旋之舞
「浮栅 Flash 缩到 3D 堆叠 200 层还能走——但工程师一直在找'通用存储':速度像 SRAM、密度像 DRAM、非易失像 Flash、耐久无限、便宜——」萨支唐指向更远处的星辰,那里的星辰颜色各异:有的红蓝双色旋转(MRAM)、有的半透明凝固/熔化(PCRAM)、有的细丝通断(ReRAM)。
【STT-MRAM 自旋转移矩磁阻 RAM】核心是 MTJ 磁隧道结(Magnetic Tunnel Junction):参考层(Pinned Layer,磁矩方向固定)+ 隧道势垒层(MgO,1nm 左右)+ 自由层(Free Layer,磁矩方向可翻转)。两铁磁层平行(P 态)→电子隧穿概率大→电阻低(存 0);反平行(AP 态)→隧穿概率小→电阻高(存 1)。TMR(隧穿磁阻比)=(R_AP-R_P)/R_P≈100-300%。
写:通过 MTJ 的电流方向决定自旋角动量转移——电子自旋被参考层极化后流入自由层,角动量转移给自由层磁矩,当电流超过临界电流 Jc(~10⁶A/cm²),自由层磁矩翻转。这就是自旋转移矩 STT。读:加小电压测电阻(不翻转磁矩)。
STT-MRAM 优点:ns 级读/写(接近 SRAM)、无限耐久~10¹²-10¹⁶ 次、非易失断电不丢、抗辐照;缺点:写电流大、密度比 DRAM 低。Everspin/三星/台积电/GlobalFoundries 量产——嵌入式 MRAM 替代 MCU eFlash。
【PCRAM 相变存储器】核心是硫系化合物相变材料(Ge₂Sb₂Te₅=GST 最经典):晶态(低阻~kΩ,GST 缓慢冷却形成结晶);非晶态(高阻~MΩ,GST 熔融~600°C 后快速淬火→非晶)。写:短高脉冲(淬火→非晶高阻=RESET)、长中脉冲(退火→晶态低阻=SET)。优点:字节级读写、密度高(3D XPoint 4F²)、非易失、耐久~10⁸ 次、速度~100ns(介于 DRAM 和 NAND 之间——Storage Class Memory 定位)。Intel 傲腾(3D XPoint)是 PCRAM 商业产品。
【ReRAM 阻变存储器(RRAM)】金属氧化物(HfO₂、TaOx、TiO₂ 等)夹在两个电极间——SET:加电压→氧空位迁移形成导电细丝(CF)→低阻(LRS);RESET:反向电压→细丝断裂→高阻(HRS)。优点:结构简单(MIM)、密度高(<4F²、交叉阵列 3D 堆叠)、速度快(ns)、低功耗;缺点:细丝形成随机性大、一致性差。
萨支唐
「没有一个完美——MRAM 快且耐久但密度低;PCRAM 做 SCM 定位但功耗大;ReRAM 潜力大但不成熟。业界的策略是异构存储——CPU 里用 SRAM、封装内用 HBM(DRAM 堆叠)、主板用 DDR5、SSD 用 3D NAND、SCM 层用傲腾/MRAM 做缓存——每种存储在它最擅长的层级。」
新型存储三机制对比台
依次点击 tab:① MRAM 自旋翻转(MTJ 动画)② PCRAM GST 相变 ③ ReRAM 导电细丝 ④ 六技术雷达对比(至少各点 1 张)。
详解 · K16-13 MRAM 自旋转移矩(STT-MRAM)物理机制
核心器件是磁隧道结 MTJ(Magnetic Tunnel Junction):参考层(Pinned Layer,CoFeB,磁矩方向被反铁磁层 IrMn 钉扎)+ 隧道势垒(MgO,~1nm)+ 自由层(Free Layer,CoFeB,磁矩可翻转)。TMR 效应:两铁磁层磁矩平行(P 态)→ 自旋极化电子隧穿概率大 → 电阻低 RP;反平行(AP 态)→ 隧穿概率小 → 电阻高 RAP。TMR = (RAP-RP)/RP ≈ 100-300%(MgO 势垒因 Δ₁ 对称性滤波效应可达 >600% @低温)。读:加小电压(<Vc/2)测电阻态,不翻转磁矩。写(STT 自旋转移矩):电流从参考层流向自由层时,电子自旋被参考层极化 → 角动量转移给自由层磁矩 → 超过临界电流密度 Jc(~10⁶-10⁷ A/cm²)时磁矩翻转(P→AP 或 AP→P)。Jc ∝ α·Ms·tFL·HK(α=阻尼系数,tFL=自由层厚度,HK=各向异性场)——减薄自由层(1.0→0.7nm)和降低 α 是降写电流的关键。优点:读写速度 ns 级(接近 SRAM)、耐久 >10¹²-10¹⁶ 次(磁矩翻转无材料损伤)、非易失、抗辐照。缺点:写电流大(~10-50μA/cell)、RA(电阻×面积)与 TMR 折中、密度低于 DRAM(1T1MTJ ~20-40F²)。量产:Everspin 2012 独立 MRAM、Samsung 2019 28nm eMRAM(替代 MCU eFlash)、TSMC/GF 22nm eMRAM IP。(Sze Ch7; Slonczewski JMMM 1996 STT 理论; Fert Rev. Mod. Phys. 2007 GMR/TMR 综述)
详解 · K16-14 PCRAM 相变存储器物理机制
核心材料是硫系化合物(Chalcogenide),经典配方 Ge₂Sb₂Te₅(GST-225)。两种稳态:①晶态(Crystal):GST 缓慢冷却(退火 ~150-300°C,~100ns)→ 面心立方(FCC)晶体 → 载流子浓度高 → 低阻 ~1-10kΩ(SET 态,存"1");②非晶态(Amorphous):GST 熔融(~600°C,~10ns 短脉冲)后极速淬火(>10⁹ K/s)→ 原子来不及排列 → 无序网络 → 高阻 ~100kΩ-1MΩ(RESET 态,存"0")。电阻比 RRESET/RSET ≈ 10²-10³(远大于 MRAM 的 2-3×)。编程脉冲:RESET = 短高脉冲(~10ns, V~3-5V, 熔融+淬火);SET = 长中脉冲(~100-500ns, V~2-3V, 退火到结晶温度但不熔融)。读:低电压(<0.5V)测电阻,不触发相变。速度 ~10-100ns(介于 DRAM 和 NAND 之间),耐久 ~10⁶-10⁸(相变材料疲劳:反复热循环 → 元素偏析 → 阻值漂移),非易失(晶/非晶态常温稳定 >10 年)。3D XPoint(Intel Optane, 2015-2021):交叉阵列(Crosspoint)结构——OTS 选通管(Ovonic Threshold Switch)+ PCRAM 单元,4F² 面积,两层堆叠。定位 Storage Class Memory(SCM):延迟 ~100-300ns(比 NAND 快 1000×,比 DRAM 慢 5-10×),容量 128-512GB/条。Intel 2021 年停产(成本/生态不及预期),但相变物理仍是 SCM 研究主线。(Sze Ch7; Ovshinsky PRL 1968 相变开关原始论文; Intel 3D XPoint ISSCC 2017)
详解 · K16-15 ReRAM 阻变存储器物理机制
结构极简:MIM(Metal-Insulator-Metal)——两个金属电极夹一层过渡金属氧化物(HfO₂、TaOx、TiO₂、Al₂O₃ 等,厚 3-20nm)。阻变机制:①SET(高阻→低阻):加正电压(~1-3V)→ 氧化物中氧空位 VO(带正电)在电场下迁移聚集 → 形成纳米级导电细丝(Conductive Filament, CF,直径 ~5-20nm)贯穿绝缘层 → 电阻从 ~MΩ 骤降到 ~kΩ(LRS);②RESET(低阻→高阻):加反向电压或正电压过大 → 细丝最窄处焦耳热/电场断裂 → 电阻回到 ~MΩ(HRS)。RHRS/RLRS ≈ 10²-10⁴。物理本质:VO 是施主缺陷(HfO₂ 中每个 VO 贡献 2 个电子),细丝是 VO 富集区(局部化学计量比从 HfO₂ 变为 HfO2-x,x~0.3-0.5),导电机制是 n 型半导体/金属性 hopping。另一种机制是金属离子迁移(ECM, Electrochemical Metallization):活性电极(Ag/Cu)氧化 → 金属离子穿过固体电解质 → 阴极还原沉积形成金属丝。优势:结构最简(MIM 两掩模)、面积极小(<4F²)、可 3D 交叉阵列堆叠(多层 MIM 叠加)、速度 ns 级、功耗低(SET 电流 ~μA)、与 BEOL 工艺兼容(HfO₂ 已是高 κ 栅介质材料)。挑战:细丝形成/断裂的随机性 → cycle-to-cycle 和 device-to-device 涨落大(σR/R ~10-50%)、FORMING 首次激活需较高电压、耐久 ~10⁶-10⁹(细丝反复断裂/重连导致电极/界面退化)。研究前沿:多值存储(4-8 级电阻态)、神经形态计算(模拟突触权重)、存内计算(CIM)。(Sze Ch7; Waser & Aono Nature Mater. 2007 综述; ITRS 2.0 RRAM Roadmap)
遗忘灵君三问
记忆星海中所有星辰的光忽然汇聚——星辰之间的暗物质凝聚成一个蒙着双眼的女子,她手持一把沙漏,沙子(电子/电荷/自旋)从漏口簌簌而下。
遗忘灵君。
 遗忘灵君
「凡人。你走过了 SRAM、DRAM、NAND、NOR、3D NAND、MRAM、PCRAM、ReRAM——你以为你找到了'记忆长存'?我的沙漏从宇宙诞生就在漏。熵让一切遗忘,比特也逃不过。」
遗忘灵君
「三问——答对,结丹三层印归你;答错,你的记忆会像 DRAM 电容一样 64ms 漏光。」
三问。答错一题,遗忘灵君的沙漏会加速一分。你手里唯一的武器,是这一路亲手验证过的每一步——SRAM 双稳态、DRAM 刷新、Flash 浮栅、MRAM 自旋、磨损均衡、异构存储。
结丹三层
星尘归海,记忆星海恢复闪烁——但你看这些星辰的眼光变了。每颗星不再是"存 0 或 1 的盒子",而是一个与熵、与时间、与物理极限打战的战场——SRAM 正反馈锁存、DRAM 电容刷新、Flash 浮栅囚禁、MRAM 自旋翻转、PCRAM 相变、ReRAM 细丝——每一种存储都是在对抗遗忘。
你盘坐,本命石飞出。十五道旧痕环绕,镜纹的银辉最贴近外层(模拟镜映的记忆)。
萨支唐走到你面前,手托第三枚结丹印——"结丹三层·记忆长存"。
印信按下——第十六痕:忆纹。
石上浮现的纹路是一个沙漏——但沙漏中间不是空的,而是一道浮栅氧化层,把上下(0/1)隔开,金色电子细沙从中间隧穿流过;沙漏两侧环绕 SRAM 6T 的双环(交叉耦合反相器形成的太极环),把 0 和 1 锁在环里——只要环不断(VDD 在),电子就留在原地。
萨支唐
「第十六痕——忆纹。忆者,记忆也。所有记忆都是对熵的抵抗——SRAM 靠持续供电(做功=耗电能)锁存、DRAM 靠刷新(周期性做功)补偿漏电、Flash 靠高势垒(被动抵抗,但每次写损伤势垒)、MRAM 靠自旋守恒(角动量不轻易翻转,但写电流要大)。没有哪种记忆免费——'存'住 1bit 信息,按 Landauer 原理,擦除时至少释放 kT ln2 热量。」
肖克利
「Kahng 和 Sze 在 1967 年发明浮栅的时候,没人想到 50 年后大家口袋里有 1TB 的 NAND。但从浮栅到 3D NAND 到未来的 MRAM——都是和遗忘的战争。记住这个战争,比记住任何电路都重要。」
你握紧三枚结丹印信。
「下一章——」萨支唐指向修炼场深处的一座巨大建筑,那是你从未见过的——不是星辰、不是波形、不是管子,而是工厂。你看见金黄的硅熔体在直拉炉里旋转成单晶硅锭、晶圆切割抛光像镜面、氧化炉里 1000°C 高温生长 SiO₂、紫色等离子体在刻蚀腔里击出沟槽、离子注入机发射蓝色离子束、CMP 研磨盘旋转抛光、铜大马士革电镀填满沟槽……
萨支唐
「ch17半导体制造工艺——从沙子到晶圆。你已经学了器件、数字电路、模拟电路、存储器——但你还不知道这些器件是怎么造出来的。氧化、光刻、刻蚀、掺杂、薄膜沉积、化学机械抛光——六大工艺模块。」
熵魔
「制造需要热——热是我主场。1000°C 氧化、等离子体、快速退火——每一步都有热预算。欢迎来到我的锻炉。」
你站起来,忆纹在本命石上发出暖金色的光——这是记忆之光。带着 16 道石痕,你走向制造工厂的紫色高温光芒。
十碎片归位 · 忆纹圆满
十枚碎片(K-154~K-163)从沙漏中心射出,依次嵌入本命石忆纹周围。点击或等待自动归位。
本命石新痕: 忆纹(第十六痕)
详解 · 复盘 · 记忆长存全景——从 6T 正反馈到 3D 垂直堆叠的工程哲学
本章 16 个知识点构成一条完整的存储器技术链:物理层——双稳态正反馈(K16-02/03)、电容电荷分享(K16-05)、势垒囚禁与量子隧穿(K16-09/12)、自旋角动量守恒(K16-13)、相变热力学(K16-14)、离子迁移细丝(K16-15)——六种不同的"记住 1bit"的物理机制。电路层——灵敏放大器把 mV 差分放大到轨(K16-04)、β 比折中读稳与写翻(K16-03)、电荷泵升压驱动 F-N(K16-12)。架构层——金字塔分层与局部性原理(K16-01)、行列译码与 bank 并行(K16-08)、NAND 串联换密度 / NOR 并联换速度(K16-10)。工艺层——三维电容 DT/Stack 延续 DRAM 摩尔(K16-07)、3D NAND 垂直沟道 + 电荷俘获替代浮栅(K16-11)。系统层——刷新对抗漏电(K16-06)、磨损均衡/ECC/OP 延寿(K16-10/12)、异构存储各尽其才(K16-16)。热力学视角:Landauer 原理(1961)证明擦除 1bit 信息至少耗散 kT·ln2 = 2.9×10⁻²¹ J(@300K)热量——这是信息的热力学代价。实际存储器远超此极限(DRAM 刷新 ~10⁻¹⁵ J/bit/次,Flash 编程 ~10⁻¹¹ J/bit),但方向一致:所有"记忆"都需要持续或周期性做功来对抗熵增。SRAM 做功维持正反馈(VDD 不断供)、DRAM 做功刷新(64ms 周期)、Flash 用势垒"冻结"熵增(但每次写损伤势垒 = 积累不可逆熵)、MRAM 用角动量守恒(写时注入自旋矩 = 做功)。没有免费的记忆——这是本章最深的物理教训。(Streetman Ch9; Sze Ch7; Landauer IBM J. Res. 1961; Hennessy & Patterson Ch5)
【ch16 记忆长存 · 完】
【ch17 炼砂成芯 · 预告:从沙中硅到十二寸晶圆,从 SiO₂ 氧化到铜互连——半导体制造的六大工艺奇迹】