片上传脉
铜是最好的导线,但最好≠理想——铜道里的R、C、L把信号从飞行拖成爬行,电迁移让铜道衰老死亡。从130nm起互连延迟反超门延迟——7nm 处已放大到近 20 倍,导线是反摩尔定律的。片上传脉的本质不是材料,是系统性权衡。
互连延迟反超门延迟
系统之城中央,一条十车道宽的铜色大道——Global Interconnect M10(顶层金属),宽 2μm、厚 2μm,横贯全城。大道两侧是窄小的街道——M1 地方线(~20nm 宽)。所有街道都充满"电子车流",电流在铜道里奔流。但林舟仔细看——铜道表面有细小空洞,道旁的"居民"(晶体管)有的灯火明亮,有的昏暗。
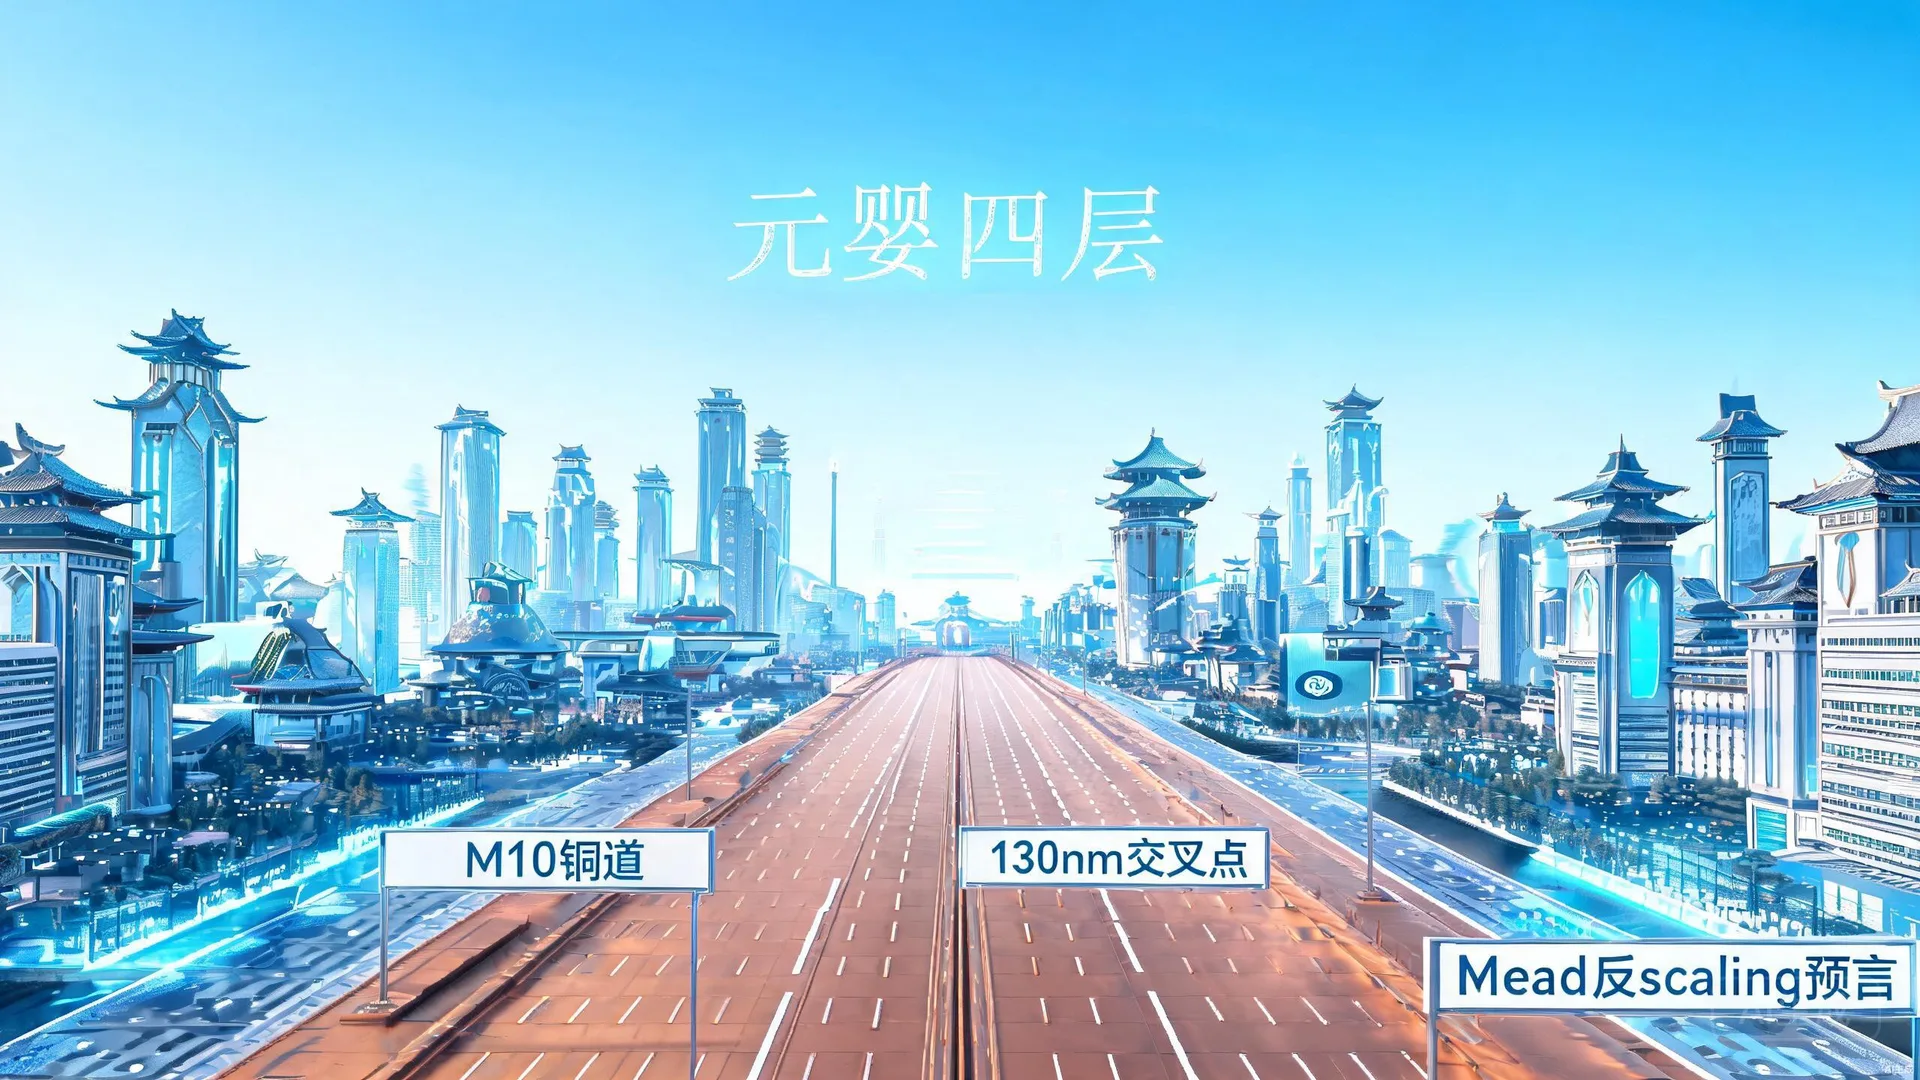
月白主色裹着铜光——大道泛铜红,小街泛铜暗。城中可见一些"路段"在闪烁——那是信号在传播,并非瞬间到达,而是以"波"的形式从一端慢慢爬到另一端,速度比光速慢 1~2 个数量级。大道上时有"撞车"——两路电子串扰、信号线抖动;有"塞车"——IR 压降使远端供电不足;有"路面塌陷"——电迁移产生的空洞阻断道路。
 线夫人
「来者可是林舟?钱玥教你权衡,延迟之灵教你算门延迟——可你们算的那些,都是"门的快慢"。在我的城里,门只是房子,街道才是命脉。街道堵了,房子再快也没用。」
线夫人
「但我要告诉你——铜是最好的导线,电阻率 ρ=1.7μΩ·cm,比铝低 37%,电迁移耐受力还比铝高 10~100 倍(视阻挡层与覆盖层工艺)。只要铜道铺得够宽够厚,信号就是瞬间到达。」
 钱玥
「她又说"最好的导线"了。铜是最好的——但最好≠理想。ch20 你学的 t_p=0.69RC 是门延迟;今天你要学——真正决定系统频率的是互连。」
林舟踏上 M10 铜道——他在 ch18 走过铜大马士革工艺,以为铜就是最好的导线。可踩上铜道时,脚下 R 和 C 的存在感直透鞋底。钱玥指向铜道——一个信号从城东发出,林舟盯着看:信号不是瞬间到达城西,而是像涟漪一样慢慢扩散,花了 ~250ps 才走完这 1mm 的大道(含驱动与中继)。而旁边的门延迟才 ~13ps——近 20 倍的差距。
互连尺测量 · 130nm 交叉点标定
下注:管子越缩越快,导线呢?拖动节点游标到你觉得两条曲线交叉的位置,点「确认押注」——看看你对 130nm 交叉点的直觉准不准。
详解 · K21-07 互连延迟与晶体管延迟的对比
台上押注的两条曲线不是美术,是两条 scaling 律的对决。门延迟随节点缩小按 √(节点) 一路下坡:250nm 约 80ps,7nm 约 13ps——每代工艺工程师都在吃这碗饭。导线却反着走:金属截面缩小让单位长度电阻上升,而全局导线的长度不缩(芯片面积不缩反涨),RC 逐代变差。两条曲线在 130nm(2001 年前后)交叉,此后互连反超——按台上模型,7nm 处互连/门延迟比 ≈19 倍。交叉点两侧的物理分工要分清:局部导线随模块缩小而变短,RC 不涨反跌(短线救了它);全局导线(时钟干线、跨模块总线)长度锁死在芯片尺寸上,只能靠上层宽厚金属+repeater 硬扛。这就是 Mead 反 scaling 定律的完整含义:器件按比例缩小一切变好,导线按比例缩小只是局部变好、全局变差——从 130nm 起,决定芯片主频的权杖从「门」移交给了「路」,全局链路延迟预算也从可选项变成了签核(sign-off)必查项。(Rabaey Ch4)
导线的三副面孔
铜脉第一层(M1 局部互连层)。这里街道最窄(~20nm 宽、40nm 厚、minimum pitch~40nm),只能"单车道"(单根线)。M1 是最底层金属,紧邻晶体管,线长~几十μm。旁边有 R、C、L 三把测量仪。
铜色略暗(细线阻大),线之间电场线以紫色画出,像街道间的蜘蛛网。
钱玥
「ch18 你学了铜大马士革工艺——那是"怎么造铜导线"。本章你要学"铜导线造好以后,信号在里面怎么跑"。把 R、C、L 三个参数都量出来,拼出导线的完整"面孔"。」
林舟用互连尺量一段 M1 铜线——宽 W=20nm,厚 T=40nm,长 L=10μm。钱玥推导:方块电阻 R_s=ρ/T(ρ=1.7μΩ·cm,T=40nm 时理论 R_s=0.425Ω/sq;但实际有 TaN/Ta 阻挡层+尺寸效应,有效 ρ 升到~4μΩ·cm,R_s≈1Ω/sq)。线电阻 R=R_s×(L/W)=1×(10μm/0.02μm)=500Ω。
一根导线有两个电容:C_gnd(对地电容)≈ε·W·L/h(平行板)+边缘电容;C_c(耦合电容)到相邻同层导线≈ε·T·L/s。低 k 介质(κ=2.5~3.0)+窄间距——M1 层 C_c/(C_gnd+C_c)≈60~80%,耦合电容占主导。
第三把仪器是电感 L——高频下(GHz 级)电流在导线周围产生磁场,L≈μ₀·L·ln(h/W)/2π。RC 模型只对短线成立;到了 GHz,L·di/dt 压降和 RLC 传输线效应(Z₀=√(L'/C'))不可忽略——信号出现振铃、过冲。但片上互连 L 通常被 R 的阻尼掩盖(R>>ωL),只在全局时钟/高速 I/O 才显著。
钱玥
「ch20 我们用的就是集总 RC 模型——假设整根导线是一个 R 串联一个 C,t_p=0.69RC。这对短线成立。但林舟你试加宽 W——R 降 1/W,但 C_gnd 升 W 倍——RC 乘积近似不变(∝ρεL²,和 W 无关)。换银?体电阻率银 1.59 对铜 1.68 μΩ·cm,只低 ~5%,纳米尺度下尺寸效应再把差距抹得更平。这是 ch21 核心悖论。」
R/C/L 三副面孔 · 集总 RC · 核心悖论
读三副面孔的推导:方块电阻 R_s=ρ/T、耦合电容主导的 C=C_gnd+C_c、被 R 阻尼掩盖的 L——以及"加宽 W 而 RC 不变"的核心悖论。逐条展开下方详解。
详解 · K21-01 互连参数:电容的物理起源
一根导线的电容有两个来源,段落里 C=C_gnd+C_c 不是账面拆分而是几何必然:对地电容 C_gnd≈ε₀κ·W·L/h(导线底面对衬底的平行板)+边缘分量(电力线从侧壁绕出去,W 与 h 同量级时边缘项可达平行板的一半);耦合电容 C_c≈ε₀κ·T·L/s(侧壁对相邻导线,T 是线厚、s 是线间距)。纳米节点的判决性事实:W≈20nm 与 s 同量级,而 T(40nm)远大于 W——侧壁面积反超底面面积,M1 层 C_c 占总电容 60~80%,「耦合主导」就是这么算出来的。后果沿三条线展开:串扰(S3 的侵略者正是经 C_c 注入电流)、功耗(S5 的 P=αCV²f 里每一份 C 都要充电放电)、以及降 C 的全部工程努力(低 κ 介质、空气隙,见 S3 两枚 kbox)。数值感:κ 从 SiO₂ 的 3.9 降到 ULK 的 2.2,同几何电容直降四成以上——比把线画细有效得多。(Rabaey Ch4)
详解 · K21-02 互连参数:电阻的物理起源
R=ρL/(WT) 是欧姆定律的几何换装,工程上拆成方块电阻用:R_s=ρ/T,R=R_s×(L/W)。铜的体电阻率 ρ=1.68μΩ·cm,T=40nm 时理论 R_s=0.425Ω/sq——但本章推导量出的是 ~1Ω/sq,差出来的 2~4 倍来自三笔「纳米税」:①表面散射——电子平均自由程 ~39nm 与线宽 20nm 同量级,边界碰撞不再可忽略;②晶界散射——细线里晶粒尺寸受限,跨晶界的电子被额外散射;③阻挡层——铜需要 TaN/Ta 防扩散层(几 nm 厚、电阻率远高于铜),有效导电截面被吃掉一块。这三笔税随节点缩小只会更重——7nm 以下细线有效 ρ 可达体值的 3~5 倍。换材料?银的体电阻率 1.59μΩ·cm 只比铜低 ~5%,纳米税一收差距更平——对话里「换银不通」的量化出处。真正降 R 只有两条路:上层金属加宽加厚,以及用 Co/Ru 衬垫把阻挡层做薄。(Rabaey Ch4)
详解 · K21-03 互连参数:电感的物理起源与高频效应
电感是电流回路磁通的度量:片上导线 L≈μ₀L·ln(h/W)/2π,量级 0.5~1nH/mm。要害在频率:感抗 ωL 随 f 上升而 R 不变——频率高过某临界值后 ωL 与 R 可比,导线从一阶 RC(指数爬升)变成二阶 RLC(振铃、过冲,特征阻抗 Z₀=√(L'/C'))。片上绝大多数信号线到不了这个频率:以量过的 M1 线为例,R'≈50Ω/μm,而 3GHz 下 ωL'≈0.02Ω/μm——差三个数量级,R 把振铃阻尼得干干净净。这就是「L 被 R 阻尼掩盖」的完整含义:不是 L 不存在,是它的作用被耗散吃掉了。例外集中在三类:宽厚全局线(R 低一个数量级以上,ωL 开始追上)、电源网格(di/dt 噪声 L·di/dt 直接进入 S4 的动态 IR drop 账本)、高速 I/O(返回路径远、回路面积大)。判据一句话:比较 ωL 与 R 的大小,工程上常用临界频率 f_crit=R/(2πL) 估算——过了这条线,RC 模型必须升级为 RLC。(Rabaey Ch4)
详解 · K21-04 集总RC导线模型
集总模型把整根导线压成一个 R 串一个 C:t_p=0.69RC(50% 延迟,0.69=ln2)。它的适用边界正是 S2 实验台上 10ps 局部底线与分布曲线的交点(约 50μm):线长在几十 μm 内时导线延迟是 ps 级、远小于门延迟,把分布网络当作一个 R 一个 C 看没有任何损失。线长超过百 μm 后电荷逐段充放,0.69RC 开始系统性失真——方向是高估:均匀分布线的真实 50% 延迟是 0.38RC(R、C 取全长总量),集总值偏大八成。数值对比一眼看清:1mm M1 线 R=50kΩ、C=0.2pF,集总算 6.9ns、分布算 3.8ns——S9 第一问的干扰项 A 正是拿 0.69RC 坑人。使用纪律:先估导线 RC 与信号上升时间之比,差一个数量级以上才许用集总;带分支的短网络升级为集总 RC 树,用 Elmore 路径求和(K21-06)。模型是省算力的近似,不是免费的真理。(Rabaey Ch4)
分布RC与Elmore延迟
M3 中层互连层。一段 1mm 长、100nm 宽的 M3 导线横贯殿中。导线上每隔一小段有一个小鼓包——那是寄生 RC 的集总单元。旁边有示波器,显示信号从一端进入后不是方波,而是缓坡(diffusion)。
导线的"扩散坡"以渐变色(红→橙→黄→蓝)显示——方波被弥散成山坡。
钱玥
「ch20 我们用集总 RC——假设导线是一个 R 一个 C,t_p=0.69RC。这对短线成立。但对于长线(细线几十 μm、全局粗线 mm 级),导线是分布 RC 传输线——每 Δx 段有一个 R'Δx 和 C'Δx。基尔霍夫方程得到 ∂V/∂t=(1/(R'C'))·∂²V/∂x²——这是扩散方程(不是波动方程)!信号像热扩散一样慢慢爬,没有波速,延迟和长度平方成正比。」
钱玥继续推导 Elmore 延迟模型(1948):t_pd(节点i)=Σ_k R_{k→source}×C_k。对于单根均匀长线 L:t_pd=0.5·R'C'·L²(0.38~0.5 系数,常取 0.5RC)。1mm M3 线,R'≈1kΩ/mm,C'≈0.2pF/mm:t_pd=0.5×1k×0.2p×1²=100ps;线长 2mm→t_pd=400ps——长度翻倍,延迟翻 4 倍!
林舟看到 M3 线上每隔 150μm 果然插着一个反相器——整段 1mm 线插了 6 个 repeater。钱玥推导 Bakoglu(1985)经典结论:把线分成 N 段,最优 N*=√(0.4R'C'/(0.7R₀C₀))·L(约 L 每 100~200μm 插一级);优化后 D_opt≈2.5√(R₀C₀R'C')·L ∝ L(线性!)——把 L² 压回 L 线性!信号不再是缓坡扩散,而是"逐段重整"——每段都被反相器恢复成陡沿方波。
线夫人
「你打断了我的铜道……那信号完整性呢?你以为只有延迟?」
分布RC扩散坡 · Elmore · repeater 插入
操作提示:① 拖线长 L(1μm→1mm 对数)看 M1 细线延迟按 L² 陡升——1mm 裸线 ~3.8ns ② 对比 N=0 与 N=最优(1mm 处 N*≈13)——L² 被压回线性 ③ 把 N 拖过 25 看 repeater 自身延迟反噬 ④ 点击下方 Elmore 树节点看路径求和 τ=ΣR·C。
详解 · K21-05 分布RC传输线模型
把导线切成 Δx 小段,每段 R'Δx 串 C'Δx——对节点写基尔霍夫定律,Δx→0 得 ∂V/∂t=(1/(R'C'))·∂²V/∂x²:扩散方程,与热传导方程同构,不是波动方程。两个直接推论:①没有波速——信号不是「飞行」而是像墨水在纸里洇开,阶跃响应是误差函数 erfc 形的缓坡,正是台上示波器画的那种山坡;②50% 延迟 0.38·R'C'·L²,与长度平方成正比——长度翻倍延迟翻四倍,把游标从 100μm 拖到 200μm 看到的就是这条二次曲线。手算 S9 第一问:R'=50Ω/μm、C'=0.2fF/μm、L=1mm:0.38×50kΩ×0.2pF=3.8ns——比 7nm 门延迟(~13ps)大近 300 倍。为什么不是波动方程?因为片上导线不存在电感主导的频段(K21-03),电磁能量随走随耗——RC 线是「有阻尼无反射」的极限。L² 灾难唯一的结构性解法是打断它:repeater(K21-16)。(Rabaey Ch4)
详解 · K21-06 RC延迟与Elmore延迟模型
Elmore(1948,本为电路网络分析发明)给 RC 树一个一阶矩近似:节点 i 的延迟 τ_i=Σ_{k∈path(i)} R_k×C_downstream(k)——沿根到 i 的路径,每段电阻乘以其下游全部电容,逐段求和。用台上 Elmore 树点 n3 验算:路径 root→n1→n3,段 n1 的 R=5 带下游电容 C=3+2+1=6,段 n3 的 R=4 带下游 C=1:τ(n3)=5×6+4×1=34——点击节点读数对得上不是巧合,是求和规则本身。均匀长线是它的连续极限:一阶矩 τ=0.5·R'C'·L²(50% 延迟系数 0.38~0.4,两套系数各有定义,别混用)。Elmore 的地位:不是精确解,是「一次遍历算完一棵树」的工业级快算——静态时序分析里几十万节点的时钟树不可能每条都解扩散方程,Elmore 就是互连延迟的默认近似。S8 第一关组装的正是这条公式——路径求和,不是 0.69RC,也不是 0.38R'C'L²。(Rabaey Ch4)
详解 · K21-16 repeater插入优化
Bakoglu(1985)的解法结构极简:既然延迟 ∝L²,就把长线切成 N+1 段,段间插缓冲器重新驱动——每段延迟 ∝(L/(N+1))²,总和被压到 ∝L²/(N+1);代价是每个 repeater 自带一段固定延迟。两者相加取极小:最优级数 N*≈√(0.4R'C'/(0.7R₀C₀))·L(R₀C₀ 为驱动器本征延迟积),最优总延迟 D_opt≈2.5√(R₀C₀·R'C')·L——L² 变 L,线性。台上数值演练:1mm M1 线裸走 3.8ns;按每级 20ps 的驱动器,N*≈13,优化后约 0.53ns——七倍改善,但仍回不到 10ps 底线,这正是全局信号要走上层 M10 胖线(R' 低两个数量级)的理由。把 N 拖过最优看反噬:太密时缓冲器自身延迟主导(面积、功耗、漏电同步爆炸),太疏时 L² 回归——凸函数的最优是算出来的不是拍的。账本另一面:先进节点 repeater 占布线资源与芯片面积 ~10% 量级,每个都吃 CV² 能量(S5 的功耗账与此挂钩)。(Rabaey Ch4)
串扰与介质
M5 中高层。几根平行铜线紧邻排列,间距 s=50nm。其中一根(Aggressor 侵略者)快速跳变,旁边的线(Victim 受害者)本来应该保持静态,但它的波形上出现了毛刺——那是串扰。旁边示波器显示 crosstalk 毛刺高达 VDD 的 30%。
紫色电场耦合线在相邻导线间闪烁,信号毛刺以红色干扰波纹显示。
钱玥
「串扰(crosstalk)——相邻导线通过 C_c 电容耦合(和高频下 L 电感耦合),侵略者跳变时在受害者上注入电流 I=C_c·dV/dt。毛刺(glitch):受害者静态时侵略者跳变→电压毛刺,可能被锁存器误采样。延迟扰动:受害者与侵略者反方向跳变时,C_c 等效容值倍增(Miller 效应 C_c→2C_c),延迟增加 30-50%——信号延迟不是定值,是邻线数据的函数。」
降 C_c 的方案:①增大间距——面积涨 2 倍不现实;②屏蔽(shielding)——关键线两侧加 VDD/VSS 地线屏蔽,但占面积;③减小 C_c——用更低 k 介质(SiO₂ 3.9→FSG 3.7→SiCOH 2.5→多孔 ULK 2.2);终极是空气隙(air gap,κ=1.0)——IBM 2007 年用牺牲层工艺在相邻铜线之间留空气/真空空隙,C_c 降 30%;④布线优化——相邻层正交(M1 横、M2 竖、M3 横...)减少平行长线。
线夫人
「空气隙?那是在我铜道之间挖洞——机械强度差、CMP 磨穿、可靠性差。」
钱玥
「是有代价——这又是权衡。只有组合方案(shielding+低 k+正交布线)才显示绿色 ✓。」
串扰机制 · Miller效应 · 低k与空气隙
读串扰的三重账本:侵略者经 C_c 注入 I=C_c·dV/dt 造成毛刺;反/同向跳变让 C_c 等效 ×0~2(Miller 效应),延迟随邻线数据漂移;降 C_c 的组合拳——shielding、低 k(SiO₂ 3.9→ULK 2.2)、空气隙(κ=1.0)。
详解 · K21-09 串扰(crosstalk):电容耦合与电感耦合
串扰的物理入口就是 K21-01 的 C_c:侵略者跳变 dV/dt,经耦合电容在受害者上注入 I=C_c·dV/dt。受害者静止时这是毛刺(glitch)——台上示波器画到 30% VDD,足以让下游锁存器误采样一个假数据。更阴的是动态延迟(crosstalk-induced delay):受害者自己也在跳变时,耦合的有效电荷取决于两者相对方向——反向跳变等效耦合电容 ×2(Miller 效应:两导体间电压差的变化率翻倍),同向跳变等效 ×0——延迟在 ±30~50% 区间随邻线数据图案摆动。时序从此不是定值而是数据的函数,这正是「静态时序分析必须做耦合感知分析」的物理理由。电感耦合(互感串扰)在电源网格与高速总线同样存在,随频率上升而加重。对策分四层:拉开间距(面积翻倍不现实)、屏蔽(关键线两侧加地线,把 C_c 换成对地电容)、相邻层正交布线(消除平行长线)、换介质(低 κ/空气隙直接砍 C_c,见下面两枚 kbox)。(Rabaey Ch9)
详解 · K21-13 低k介质的物理基础与类型
C∝κ 是平行板方程里最直白的杠杆:κ 从 SiO₂ 的 3.9 降到 2.2,同几何电容直降四成以上。路线图是一条材料谱系:FSG(掺氟硅玻璃,3.7)→ SiCOH(碳掺杂氧化硅,2.5~2.7)→ 多孔 ULK(在 SiCOH 骨架里造纳米孔,2.2~2.4)。孔隙的物理本质:空气 κ=1,掺孔隙就是在分子尺度掺空气——κ 想低于 ~2.2,孔隙率必须超过 30%。代价清单同样物理:①机械强度——多孔材料模量骤降,CMP 磨削与封装应力下开裂(线夫人「在我铜道之间挖洞」的抱怨非虚);②导热——ULK 热导率不到 SiO₂ 的一半,焦耳热更难散走,而温度每升 ~10°C EM 寿命减半(与 K21-11 直接耦合);③吸潮与等离子体损伤让 κ 漂移、可靠性退化。所以低 κ 是分层使用的:关键层用 ULK,普通层退回 SiCOH——又一次分层设计的逻辑。(Plummer Ch11)
详解 · K21-14 空气隙(airgap)互连技术
空气隙是把低 κ 逻辑推到极限:不再往介质里掺空气,而是直接在铜线之间留下空气/真空沟槽——κ=1.0,介电常数的物理下限。IBM 2007 年宣布的量产方案用自组装材料(嵌段共聚物自组织成纳米点阵)定位牺牲层,刻蚀移除后留下空隙,C_c 降约 30%。工程难题全是「洞」带来的:机械上,空隙上方的介质层在 CMP 与键合应力下易塌陷,因此只能做在特定关键层、且槽宽必须小于失效阈值;热学上,空气热导率 0.026W/(m·K),只有 SiO₂ 的约五十分之一,散热路径被掐断,EM 寿命进一步吃紧;工艺上,刻蚀选择比、残留物、良率层层加税。这是本章反复出现的结构:每一代「降 C」的收益都伴随可靠性/机械/热的新账单——没有免费的电容。它与低 κ 的分工:低 κ 是全域铺开的基础手段,空气隙是关键层的尖刀。(Plummer Ch11)
IR Drop与电迁移
M7/M8 电源分配层——这两层不是信号层,是 VDD 和 VSS 铜网格(power grid),巨大的铜片从芯片四周的 I/O/C4 bump 延伸到每个晶体管。但林舟看到——网格远端(离 bump 最远的芯片中心)VDD 从 0.8V 降到 0.6V,灯火暗淡;而大电流开关瞬间(CPU 一个核从 idle 跳到 active),VDD 瞬间跌到 0.5V(di/dt 噪声)。还有——某些铜道上有黑色的小洞,旁边有堆积物,像道路塌方。
电力网格是亮红铜色,但远端发暗(IR drop);瞬间 di/dt 压降处电压波形下陷(橙色);电迁移空洞是黑色。
钱玥
「IR Drop——VDD/VSS 从 I/O bump 到晶体管经历金属网格,每段铜有电阻 R,电流 I 流过产生 IR 压降:V_dd,local=VDD−I·R。静态 IR Drop:平均电流造成的稳态压降,典型~3-5% VDD。动态 IR Drop(di/dt):电路快速切换时电流瞬变,ΔI 在封装/片上电感 L 上产生 L·di/dt 压降——几 GHz 切换下可达 5-10% VDD。IR drop 过大:延时增大、建立时间违例、跑不到目标频率、极端下功能错误。解法:加 decap、电源网格加宽加厚、多加 bump/TSV 背面供电(BSPDN)。」
她指向那些黑色小洞:电迁移(Electromigration, EM)——金属中高密度电流(J>10⁶A/cm²)的电子风(electron wind)轰击金属原子,把原子从阴极推到阳极,形成两种缺陷:空洞(void)——阴极处铜原子被推走,形成断路;小丘(hillock)——阳极处铜原子堆积,形成短路。EM 是不可逆的累积损伤——一旦空洞形成,电阻增加→电流密度进一步增加→正反馈→失效。
 James Black
「1969 年我提出 Black 方程:MTTF=A·J^{-n}·exp(E_a/kT)——A 材料/几何常数,J 电流密度(n≈1~2,铜典型 n=1~1.5),E_a 激活能(Cu 晶界/界面扩散~0.9eV),T 绝对温度。温度每升 ~10°C,寿命减半——"10 度法则"从 Arrhenius 来(E_a=0.9eV 在 100°C 附近换算恰为 ~10°C)。Cu 电迁移比 Al 好 10~100 倍,但先进节点 J=5MA/cm²+温度升+尺寸效应,EM 再次变严重。」
线夫人
「我的铜道不是永恒的——会被电子风刮塌。但加宽、加 capping 层、退火优化晶粒、bamboo 结构、散热设计——把寿命推到>10 年。」
IR Drop · Black 方程 · 铜道病历
读线夫人的铜道病历:静态 IR drop 3-5% + 动态 di/dt 5-10% 让远端 VDD 从 0.8V 跌向 0.6V——延时增大、跑不到目标频率;Black 方程 MTTF=A·J⁻ⁿ·exp(E_a/kT)——温度每升 ~10°C 寿命减半,10 年寿命是设计出来的。
详解 · K21-10 IR电压降问题
电源不是理想源:从 C4 bump 到每个晶体管,VDD 要穿过一整张 RLC 电源网格。静态账:平均电流 I 在网格电阻上产生 I·R 压降,典型占 VDD 的 3~5%;动态账更狠:核从 idle 跳到 active 的电流瞬变 di/dt 在回路电感上打出的 L·di/dt 瞬态压降可达 5~10%——台上病历里 0.8V 远端跌向 0.6V(−25%)是两者叠加的极端视图。后果链:有效栅压下降→驱动电流降→门延迟上升(延迟对电压的敏感度约 2~3% 每 1% 电压)→建立时间违例→跑不到目标频率,极端时直接功能错误。对策四件套:decap(局部去耦电容垫平 di/dt)、电源网格加宽加厚(降 R,但与信号线抢布线资源)、bump 加密(倒装芯片缩短电流路径)、背面供电 BSPDN(把电源网整体搬到晶圆背面,正面让给信号——ch19 提过的路线图延伸)。IR drop 是签核必查项:每个工艺角、每种工作负载都要仿真过一遍。(Rabaey Ch9)
详解 · K21-11 电迁移(EM):物理机制与寿命模型
电流密度 J 超过 ~10⁶A/cm²(先进节点 2~5MA/cm²)时,定向漂移的电子把动量转移给金属原子——「电子风」。铜原子被从阴极吹向阳极:阴极端原子流失成空洞(void,断路),阳极端堆积成小丘(hillock,短路)。EM 的恶性在于正反馈:空洞→局部截面缩小→局部 J 更大→损伤加速——不可逆、会自我加速。寿命的定量模型是 Black(1969):MTTF=A·J⁻ⁿ·exp(E_a/kT),n≈1~2(铜典型 1~1.5),E_a 是原子扩散激活能(铜以晶界/界面扩散为主,~0.9eV)。指数项就是 10 度法则的来源:E_a=0.9eV、100°C 附近,T+10°C 寿命减半——手验:exp[0.9eV/k×(1/378−1/388K)]≈2.0。三问第二问即此:J=2MA/cm²、T=105°C,MTTF 掉到约 1 年——所以设计规则强制限制 J、capping 层(Co/Ta)提高界面扩散激活能、bamboo 晶粒让扩散路径断头。EM 无法消灭,只能用设计余量把它管理到「10 年寿命」。(Rabaey Ch9;Sze Ch6)
时钟分布与互连功耗
M9 时钟树层。一棵巨大的 H-tree 从芯片中央 PLL(锁相环)向四周展开,像时钟的血脉,最终到达每个触发器(flip-flop)的 CLK 端。但林舟看到——远处的触发器时钟到得比近处晚(skew),时钟边沿还在抖动(jitter)。
时钟树是金黄色(时钟信号特殊标识),skew 用时钟边沿到达时间的梯度色显示(早到黄、迟到红);jitter 是边沿左右抖动的模糊影。
钱玥
「时钟是芯片的心跳——所有触发器在 CLK 上升沿采样。如果 CLKA 到 A 比 CLKB 到 B 晚了 Δt(clock skew),数据从 A 到 B 必须在一个周期减 skew 的时间内到达——skew 过大导致 hold/setup 违例。H-tree 对称树理论 skew=0,实际 O/C 偏差~10-30ps。但更大的问题是:这棵树吃掉了多少功耗?」
钱玥推导:互连功耗 P=α·C·V²·f(α=翻转率,C=导线电容,V=电压摆幅,f=频率)。时钟翻转率 α=1(每周期必翻转 1 次),且驱动负载最大(连到每个触发器)。时钟功耗占芯片总功耗 30~40%。全局互连+时钟+repeater 合计占 40-60%。
钱玥
「Clock Gating——不用的模块关时钟,ch22 详讲。低翻转编码、异步设计、3D 集成都在解决互连功耗。降频降功耗?降频牺牲性能,不通——需要的是架构级优化。」
时钟树 · 互连功耗 P=αCV²f
读芯片的心跳账本:P=αCV²f——时钟 α=1 翻转率最大、负载连到每个触发器,独占芯片总功耗 30-40%;全局互连+时钟+repeater 合计 40-60%。解药不在降频,在 Clock Gating/DVFS/异步设计这类架构级手段。
详解 · K21-08 互连功耗:充放电功耗
P_dyn=α·C·V²·f——每个周期给电容充放电荷 αCV²,其中一半耗散在驱动网络的等效电阻上;要害是这份能量与 R 无关——R 只决定信号慢不慢,不决定费不费电。时钟是这条公式的极端样本:α=1(每周期必翻转),且它的 C 连到每个触发器的 CLK 端——全芯片最大的单笔电容。数值手感:0.8V、3GHz 下,一条 1mm 时钟支路 C≈0.3pF:P=1×0.3pF×0.64×3GHz≈0.58mW;一颗大芯片有成千上万条支路再加 repeater,时钟网络整账几 W 到十几 W——占芯片总功耗 30~40%,全局互连+时钟+repeater 合计 40~60%,台上账本与此一致。V² 项指明杠杆排序:降电压收益平方(DVFS)、降翻转率次之(Clock Gating 砍 α,典型省 30~40%,ch22 展开)、降频只有线性收益还牺牲性能所以排最后。心跳是芯片最贵的一笔开销,而且它花的钱大半花在「连线」而非「门」上。(Rabaey Ch4)
NoC与光互连
顶层 M10+NoC 虚拟层。整座系统之城不再是平面铜道,而是一个三维路由网络:每一个 CPU/GPU 核、Cache、内存控制器、I/O 都是一个节点(node),节点之间是链路(link)和路由器(router),数据包(packet)像车辆一样在网络里路由,从源节点到目的节点经过多跳(hop)。
NoC 是发光的网络拓扑(mesh/torus/ring),节点是蓝色路由器,链路是铜色通道,数据包是流动的光球。
钱玥
「早期 SoC 用共享总线——所有模块挂一组线上,一次只有一对主从通信,仲裁器控制。但多核 CPU(8/16/32/64 核)+GPU+各种 IP——总线带宽不够、仲裁复杂、延迟不可预测、扩展性差。2000 年左右 William Dally 等学者提出 NoC(Network-on-Chip)——把计算机网络思想搬到片上:拓扑(Mesh/Torus/Ring)、路由(XY/自适应)、流控(Wormhole/VCT)、路由器(5 级流水,~2-4 cycle/hop)。」
 William Dally
「片上网络不是缩小版计算机网络——延迟是 cycles 不是 ms、功耗是每 bit 不是每 km、面积是 mm² 不是 m²——但路由/流控/仲裁的基本原理适用。」
线夫人:"那为什么还要铜——用光互连!光子不用考虑 RC、不发热、带宽大——"钱玥领林舟到顶层一个特殊角落——那有硅光器件(波导、调制器、探测器、WDM)发着红外光(1.55μm 波段)。硅光互连优势:光速传播(不是扩散)、带宽大(WDM 一根波导传几十波长)、低串扰、无 EM;挑战:光源/调制器/探测器/CMOS 兼容。适用:数据中心机架间、CPO 共封装光学、未来片上长全局互连;不适用:局部互连(光电器件 ~μm 级比晶体管大太多、短程光电转换得不偿失)。
钱玥
「光不会替代铜——光做长距,铜做短距,各司其职。这又是架构层面的权衡。」
NoC 拓扑 · 硅光互连 · 光vs电分工
读网络抽象的账:共享总线在多核面前带宽见顶——NoC 用拓扑(Mesh/Ring/Torus)、路由(XY/自适应)与流控(Wormhole/VCT)换扩展性,路由器 5 级流水 ~2-4 cycle/hop;硅光 1.55μm+WDM 一波导几十路波长——光做长距、铜做短距,交叉点随带宽与工艺在 cm~dm 量级移动。
详解 · K21-17 片上网络(NoC)概念与物理动机
NoC 的物理动机正是本章主线:共享总线是一根挂满模块的长导线——电容随主设备数线性上涨、一次只允许一对主从通信、仲裁延迟随规模恶化——多核时代它先于导线物理先死。Dally 等人(2000 年前后;教材 Dally & Towles 2004)把计算机网络抽象整个移植片上:路由器+短链路替代长总线——关键在于 NoC 的每一段链路都是短局部线,可以激进 repeater 化甚至流水化,全局通信被分解成多跳的局部通信——这正是对抗导线反 scaling(K21-07)的架构级答案。组件三件套:拓扑(Mesh 规整易扩展、Ring 布线最省但延迟按直径涨、Torus 带宽大绕线贵)、路由(XY/维序确定性好验证不死锁、自适应绕拥堵)、流控(Wormhole 蛀洞式逐 flit 传占用缓存少、VCT 虚切通可整包缓存)。路由器典型 5 级流水,~2-4 cycle/hop。度量口径随之换装:延迟以 cycle 计、功耗以每 bit 计、面积以 mm² 计——Dally 台上那句话的出处。(Dally & Towles;架构深入见 CS 手册)
详解 · K21-18 光互连的引入与硅光子基础概述
硅在波长长于 1.1μm 时透明——这给了「用 CMOS 造光路」的物理许可。硅光子学(Soref 1980 年代奠基)的元件四件套:Si/SiO₂ 波导(折射率 3.48/1.44,450×220nm 条形截面即可强约束光场)、调制器(载流子耗尽型马赫-曾德干涉仪或微环,把电信号搬上光载波,单波长 25~50Gb/s)、Ge-on-Si 探测器(锗吸收延伸到 1.6μm)、WDM 波分复用——一根波导同时跑几十路波长,带宽密度是铜绞不出的数量级。光的物理优势直指本章痛点:无 RC——不走扩散方程、无充放电功耗、无电迁移、串扰极低。代价同样清楚:光源(硅不能发光,需 III-V 异质集成或片外激光)、光电转换的能耗与延迟、器件 μm 级尺寸(晶体管是 nm 级)、微环对温度敏感(谐振波长漂移需热调谐)。判据就是台上那句「光长铜短」:带宽×距离乘积大时光赢——交叉点在 cm~dm 量级随工艺与带宽移动;今天的主战场是数据中心互连与 CPO 共封装光学,片上长全局互连是下一站。(Soref)
线夫人的道
M10 顶层观城台。可以看到整座系统之城的全部金属层——从底部 M1 到顶部 M10,像十层立体立交桥。铜道、NoC、光互连、电源网格、时钟树全部收入眼底。线夫人站在观城台中央,她的铜丝长裙在月白风中飘动。
月白+铜+光互连红外交织。整座城在电流和光流中运转。
 Carver Mead
「1980 年我写过——"As devices scale down, wires do not get better; they get worse."(器件越缩越好,导线越缩越差)——那是我看到的最反直觉的事实。导线不像晶体管——晶体管微缩让速度↑功耗↓,导线微缩让 R↑C≈常数甚至↑——导线是反摩尔定律的。」
钱玥
「俯瞰全城——铜互连的 RC 延迟与电迁移可靠性是耦合的:J↑→EM↑→R↑→IR drop↑→延迟↑→需更宽线→但更宽线占面积→又回到 trade-off。这是热/电/机械应力多物理场耦合的系统可靠性问题。RC 延迟+可靠性+功耗+面积——四者不可同时最优,必须分层协同。」
钱玥指向城中各层:分层设计——下层 M1-M3 细而密做局部信号(短线 RC 小,集总模型适用),中层 M4-M7 中等做模块信号(repeater 插入),上层 M8-M10 厚而宽做电源/时钟/全局信号(长线但厚宽降 R,低 k/airgap 降 C)。每层厚度/宽度/间距按作用设计——这是用分层设计对抗导线反 scaling的系统工程。
线夫人
「我一直以为铜是最好的导线——最好的就应该"越好"。没想到……尺寸小了,我反而变差了。电子在我身体里不再是流水,是弹球;信号在我这里不再是飞行,是爬行;我自己还会被电子风吹出洞……小娃娃——你答我三问。答完,我也就认了这个"反摩尔定律"的命。」
全城俯瞰 · 系统耦合 · 分层设计
读全城账本:Mead 反 scaling 定律——器件越缩越好,导线越缩越差;J↑→EM↑→R↑→IR↑→延迟↑ 的正反馈让 RC 延迟、可靠性、功耗、面积四维耦合;分层设计 M1-M3 局部/M4-M7 模块/M8-M10 电源时钟全局,每层按用途定宽厚与介质。
详解 · K21-12 铜互连的RC延迟与电迁移可靠性:系统视角
把本章两条主线(RC 延迟、EM 可靠性)合到同一根铜线上看,才见系统工程的全貌。ch18 讲过铜大马士革怎么造;这里讲造出来以后「缩下去」会发生什么:①尺寸效应——线宽压到电子平均自由程(~39nm)以下,表面+晶界散射让有效 ρ 从体值 1.68μΩ·cm 涨到 3~5 倍(K21-02 的税单);②阻挡层占比——TaN/Co 衬垫几 nm 厚不随线宽缩小,导电截面被按比例吃掉;③EM——截面缩→电流密度 J 涨→Black 方程寿命按 J⁻ⁿ 跌。三股力耦合成一个正反馈环:J↑→EM↑→局部 R↑→IR drop↑→延迟↑→要求更宽的线→面积涨——台上「铜道病历」与「全城账本」的合订本。结论即分层应对:局部线短,可容忍高 R;全局线用厚宽上层金属压 R;关键路径上延迟/可靠性/功耗做联合优化,而不是各自为政地修最差的那一项。铜不是终点材料,但在可见的节点窗内,它是被工程能力续命的最优解。(Rabaey Ch4;Plummer Ch11;工艺实现见 ch18)
详解 · K21-15 全局互连与局部互连的分层设计
分层设计是反 scaling 的系统对冲:不同用途的导线受害方式不同,就给它们不同的几何。三层各配各的账:M1-M3 局部信号——细而密(间距几十 nm),但线长只有 μm 级、随模块缩小而缩短,RC 小到集总模型适用;M4-M7 模块级/半全局——中等几何,几十到几百 μm,必须插 repeater(K21-16);M8-M10 全局/电源/时钟——厚而宽(截面 μm 级),R_s 比 M1 低两个数量级以上(M1 有效 ~1Ω/sq 对 M10 约 0.01Ω/sq),专跑 mm 级长线、时钟树干和电源网格,再配低 κ/空气隙压 C。数值锚点:1mm 导线在 M1 裸走 3.8ns(S9 第一问),在 M10 加驱动与中继只要 ~250ps(S0 铜道)——同一长度差 15 倍,全靠「层」的几何自由度。这不是奢侈而是必须:顶层金属故意不按晶体管比例缩小(间距停在 μm 级),就是保留「粗管道」对抗导线变差。观城台上十层立交的每一层宽度/厚度/介质,都是按这张分工表设计的。(Rabaey Ch4)
六题汇悟
观城台。线夫人长发化为铜丝延伸,形成三根铜柱——三问即将到来。林舟回顾前面六层:R/C/L、分布 RC 与 Elmore、repeater、串扰、IR drop+EM、时钟+NoC/光。
钱玥
「三问在前,你必须把六层知识串成一条逻辑链——只有理解"所有互连解法本质都是对抗导线变差"才有资格面对三问。」
三根铜柱缓缓从线夫人发梢延伸成形,铜柱上有待解铭文。月白萤尘汇聚成链。
六题知识回顾 · 核心悖论填空
三步闯关:① 点击碎片组装 Elmore 公式 τ_i=ΣR_k·C_downstream(k) 并验证 ② 通关后按逻辑顺序点击排序六层知识链 ③ 最后填空核心悖论——导线是____定律的。
线夫人三问
观城台。线夫人铜丝长发静止,等待答案。三根铜柱上各浮一道铭文。月白风止,全城屏息。
线夫人
「凡人。你走过了 M1 到 M10,量过 R/C/L 三副面孔,看过扩散坡,插过 repeater,听过 Black 方程,玩过 NoC 和硅光——你以为你懂了互连?」
线夫人
「三问。答对,元婴二层印归你,我认了这反摩尔定律的命;答错,你的铜道会被电子风刮塌,刻痕收网。」
三问。答错一题,铜柱增厚并刻下"此路不通"判词。你手里唯一的武器,是这一路亲手验证过的每一步——R/C/L、扩散方程、Elmore、repeater、串扰、Black 方程、NoC、光互连、分层设计。
络纹初成
观城台上。林舟结印,本命石 20 痕齐亮,第 21 痕显化。月白之光在城中网络上流转。
林舟回顾全章所学——从 R/C/L 三副面孔到分布 RC 扩散方程,从 repeater/串扰/EM 到 NoC/光互连,从分层设计到系统视角。18 枚碎片在脑中连成网络。
本命石新痕——第 21 痕:络纹。一张微型网络,节点和铜线交错,铜线有一个细微的 EM 空洞(不完美标记)。网络拓扑是 Mesh,铜线有 R 有 C(非理想),节点处有微小路由器,底部有一小段光波导(未来方向),网络中央一个字:脉。
钱玥
「第 21 痕——络纹。络者,网络也。亿管不成芯,连起来才是芯;互连非理想导体,是带阻抗的网络;网络不是麻烦,是系统的命脉。你现在能把信号从一个晶体管传到另一个——但传什么?为什么传?谁和谁传?」
钱玥
「CPU 要读内存、GPU 要数据、NPU 要权重、I/O 要和外界说话、Cache 要保持一致——系统之城的"城市规划"就是 SoC 架构。ch22·万器归芯,你会从"街道"走到"城市规划局"。」
络纹奥义浮现——"亿管不成芯,连起来才是芯;互连非理想导体,是带阻抗的网络;网络不是麻烦,是系统的命脉。"林舟望向 SoC 殿——那里有 CPU 核的秩序、GPU 阵列的并行、Cache 的金字塔、NPU 的脉动阵列……系统的大门已经打开。月白更亮了一分。
十八碎片归位 · 络纹圆满
十八枚碎片(K21-01~K21-18)从络纹中心射出,依次嵌入本命石络纹周围。点击或等待自动归位。
本命石新痕: 络纹(第二十一痕)
复盘 · 片上传脉主线(K21-18 收束)
本章主线一条链:S0 押出 130nm 交叉点——互连延迟反超门延迟(K21-07),根子是 Mead 反 scaling;S1 量出 R/C/L 三副面孔——R_s=ρ/T 的纳米税(K21-02)、C_c 耦合主导(K21-01)、L 被 R 阻尼(K21-03),集总 0.69RC 只管短线(K21-04);S2 长线变扩散方程 ∂V/∂t=(1/R'C')∂²V/∂x²(K21-05)、Elmore 路径求和 τ=ΣR_k×C_down(k)(K21-06)、repeater 把 L² 打回 L(K21-16);S3 串扰经 C_c 注入、Miller 让延迟成邻线数据的函数,低 κ 与空气隙砍 C_c(K21-09/13/14);S4 铜道病历——IR drop 静 3-5% 动 5-10%(K21-10)、Black 方程与 10 度法则(K21-11);S5 P=αCV²f,时钟独占 30~40%(K21-08);S6 NoC 用网络抽象换扩展性(K21-17)、硅光 WDM 做长距(K21-18);S7 四维耦合闭环+分层设计 M1-M10(K21-12/15)。十八枚碎片对应十八个知识点,收进一句:亿管不成芯,连起来才是芯——互连是分布式 RC 网络,反摩尔定律不是诅咒,是物理的诚实。下一问交给 ch22:信号会传了,传什么、给谁传、谁说了算——SoC 架构师的城市规划。
【ch21 片上传脉 · 完】
【ch22 万器归芯 · 预告:互连解决"怎么传",SoC 解决"传什么给谁"——亿门协同的架构师之眼】