神经初醒
你以为加更多层就能学更复杂的函数。可梯度在反向传播中指数衰减,深层网络无法训练——梯度消失之渊在深层网络深处张口等你,每一层衰减都给你记着账。
神经初醒
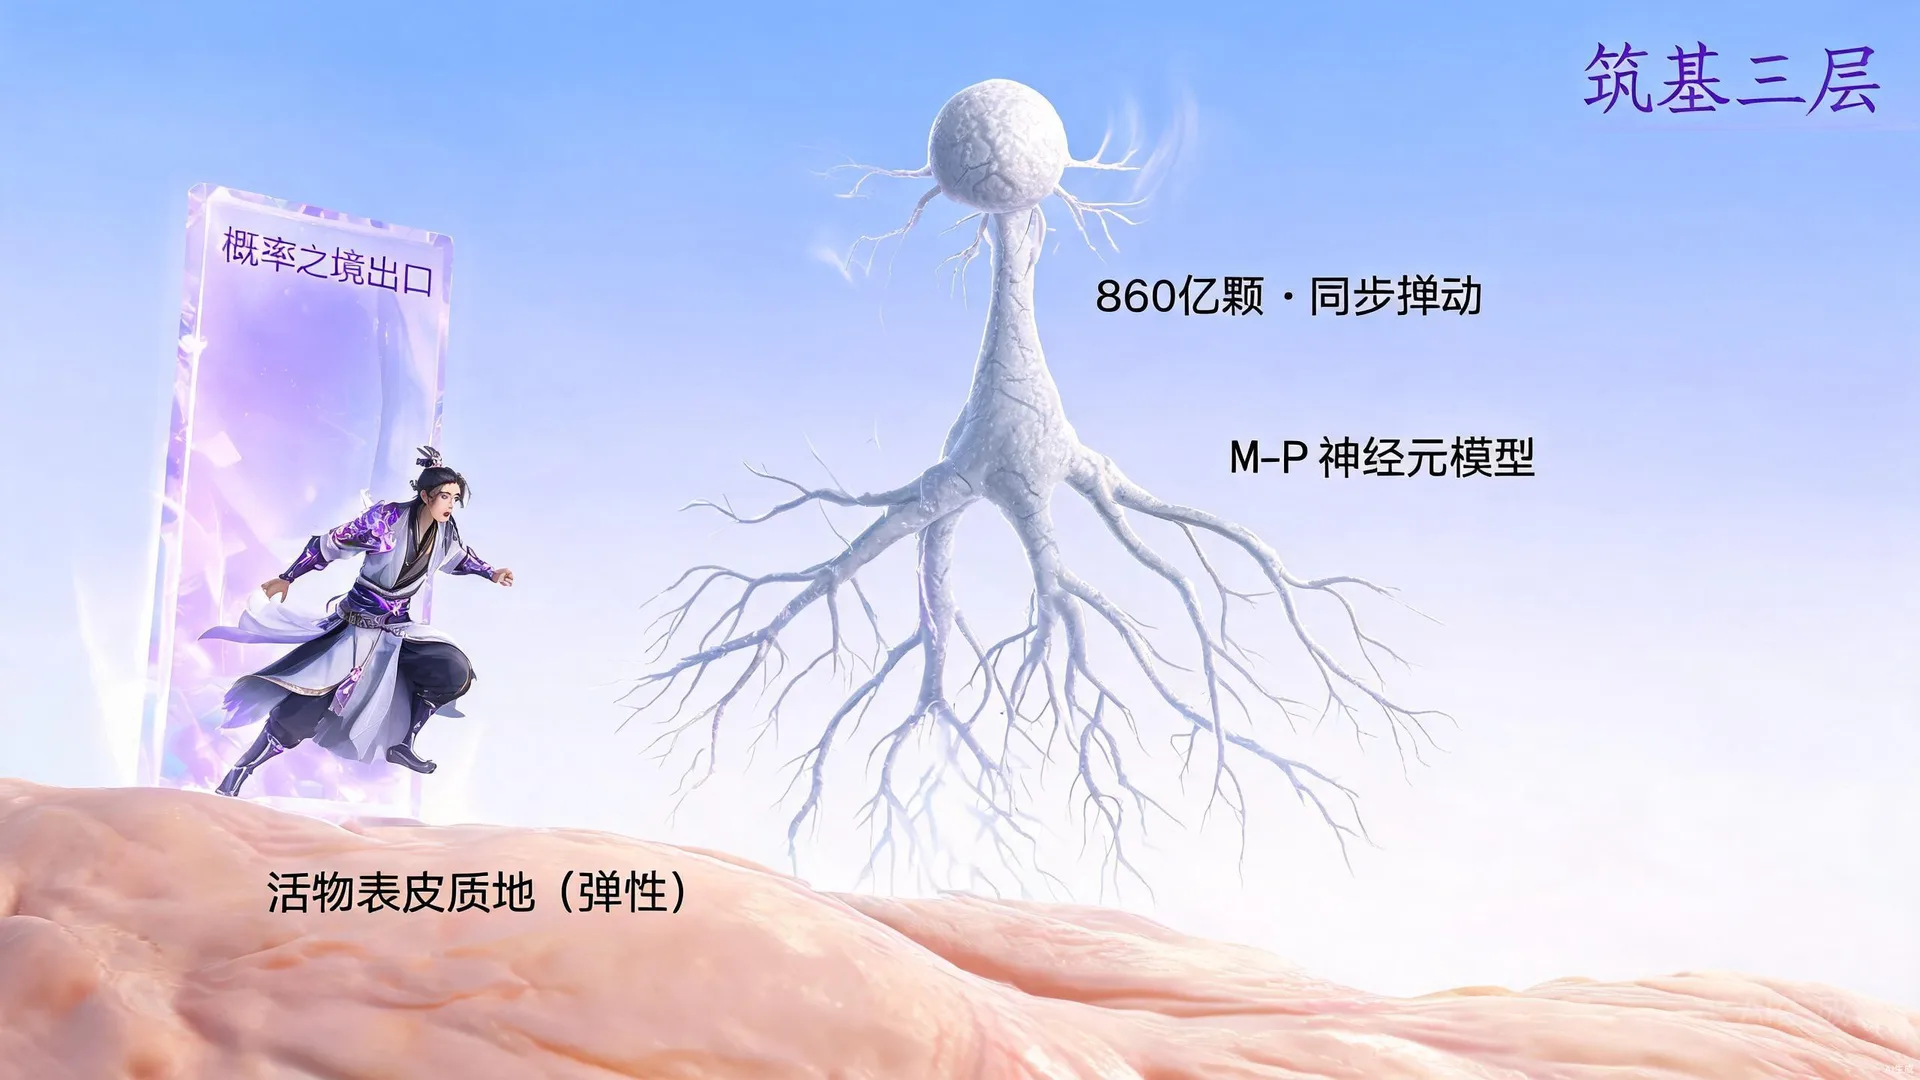
你从概率之境的出口跌出来,脚下的地面变了质地——不再是冰冷的石板,而是一种微微弹性的、像活物表皮的东西。面前悬浮着一颗灰白色的、布满分叉枝条的细胞,像一棵倒长的树。它在搏动。八百六十亿颗,此刻在你脑中搏动。
 高斯老祖
「这是你身体里的东西。你想知道它怎么思考?先把它变成你能算的东西。树突、胞体、轴突、突触——拖到右侧的数学空位上。」
 梯度消失之渊
「生物即计算?呵。你以为把树突拖到'输入'就懂神经元了?先把胞体映对再说。」
生物神经元 → M-P 模型映射台
点击四个生物结构映射到六个数学空位(胞体需映两处)→ 错误触发排除刻痕 → M-P 模型浮现
生物神经元结构
数学模型空位
详解 · K06-01 生物神经元的结构与计算模型类比
McCulloch & Pitts 1943 把八百六十亿颗神经元(Azevedo 2009 全脑计数)压缩成一个开关电路:树突→输入 xᵢ、突触→权重 wᵢ、胞体→先求和后激活、轴突→输出 y,得 y=f(Σwᵢxᵢ+b)。映射台故意让胞体占两个空位——它同时承担「整合」(加法)与「决策」(非线性),少了哪一半都不是神经元。偏置 b 是纯数学引入的阈值项,没有生物对应:它把「够不够活跃才放电」的门槛平移。要清醒的一点:这是功能性抽象而非生理保真——真实神经元有放电频率编码、树突局部计算、时序整合,M-P 全部忽略;但作为「能算的最小单元」,它撑起了后面全部深度学习。
感知机殿 · 线性之傲
殿内空旷,只有一张悬浮的二维平面,上面散落着红蓝两色光点。1958年,Rosenblatt 给了你第一台会学习的机器。规则很简单——画一条线,把红蓝分开。画对了它记住,画错了它调整。平面上浮现一行字:w ← w + η(y - ŷ)x。
高斯老祖
「感知机不在对的时候骄傲,只在错的时候低头。但只要世界是线性可分的,它迟早能低头到正确的地方。你来当它的老师。」
感知机训练台 · AND/OR 逐样本更新
选数据集 → 逐样本更新 w,b → 看分类线移动 → 收敛计数
详解 · K06-02 感知机模型:线性分类器的几何解释
Rosenblatt 1958。几何像:w·x+b=0 是一张超平面,sign(w·x+b) 给出你站哪一侧——训练台上那条移动的线就是它在二维的投影。学习规则 w←w+η(y−ŷ)x 只在犯错时更新:几何上是把边界朝错分点方向推一段正比于 x 的距离,所以「对了不动、错了低头」。Novikoff 1962 收敛界:错误次数 ≤ (R/γ)²(R=最长样本模长、γ=分类间隔),只对线性可分数据成立,且与 η 大小无关——η 只等比缩放 w,不改变几何。注意感知机停下时找到的是「某一条」能分开的线,不是最优的那条(最大间隔是 SVM 的功课);它甚至可能贴着点很近地停住。
XOR 之殇 · 线性之限
还是那张平面,还是红蓝两色光点。但这次排布变了。(0,0) 是蓝。(1,1) 是蓝。(0,1) 是红。(1,0) 是红。对角线上是同色,你不可能用一条直线把它们分开。可你不信。你按下"训练"。分类线开始移动,向左,向右,翻转,再翻转。迭代次数从 10 跳到 100,跳到 1000。它不会收敛。
梯度消失之渊
「再加一层。我来自深渊——我知道层数的力量。单层不行?加一层试试。」
高斯老祖
「1969年 Minsky 用这一个例子,让神经网络沉睡了十五年。不是它太弱,是你还不知道怎么训练多层。先看多层怎么解 XOR。」
XOR 训练台 · 单层失败 + 多层解法
单层感知机训练 XOR(永不收敛)→ 几何证明不可分 → 多层解法演示
详解 · K06-03 XOR问题与多层网络的必要性
Minsky & Papert 1969 用四颗光点杀死了感知机:对角同色意味着两类的凸包相交,而直线只能分开不相交的凸包——不存在任何 w, b 能分开 XOR。数学上 XOR = (A OR B) AND NOT(A AND B),两个中间概念各用一张超平面切开、再组合,天然需要「层」;台上演示的精确解更直接:|x₁−x₂| = ReLU(x₁−x₂)+ReLU(x₂−x₁),两个隐藏单元各管一个方向的差,输出层求和。必要性有两半:多层提供「组合超平面」的表达力,非线性激活提供「弯」——去掉激活,十层线性变换的复合仍是一层(W₂W₁x=Wx),层数白叠。历史注脚:这本书让神经网络沉睡十五年,直到反向传播(Werbos 1974;Rumelhart 1986)解决「多层怎么训」。
激活之钥 · 非线性觉醒
联结先师把你带到一面巨大的墙前。墙上挂着五把形状各异的钥匙。没有非线性,叠一百层等于一层——线性变换的复合还是线性变换,你的多层网络会塌成一条直线。五把钥匙依次亮起:Sigmoid、Tanh、ReLU、LeakyReLU、GELU。每把钥匙下面都刻着一行小字——是它的导数。深渊的低语又响了:"选吧。每一种都有塌的方式。"
高斯老祖
「你选的不是钥匙,是锁链。导数越大,锁链越粗,梯度流得越远。但每一把都有断裂的地方。逐一测试,看它们的代价。」
激活函数试验台 · 5 函数 × 10 层 × 梯度连乘
选激活函数 → 看函数曲线+导数曲线 → 看 10 层梯度连乘 → 梯度账本记第一笔
10 层梯度连乘预演
详解 · K06-04 激活函数:Sigmoid/Tanh/ReLU/LeakyReLU/GELU
选钥匙的判据只有一条:导数。Sigmoid σ'(x)=σ(1−σ)≤0.25,深处饱和、输出还非零中心,10 层连乘 0.25⁹≈3.8×10⁻⁶——账本第一笔;Tanh 零中心、导数上界 1(tanh'=1−tanh²),仍两端饱和;ReLU 正半轴导数恒 1(梯度不衰减),代价是负半轴死亡神经元;LeakyReLU 用 α=0.01 的负斜率给死亡区留一条活路;GELU=x·Φ(x) 最平滑:导数峰值 ≈1.13(在 x≈√2 处,超过 1 可部分补偿衰减)、负区导数 ≈−0.13 恒非零,无死区,是 Transformer 系的默认激活。口诀:理想激活 = 零中心 + 非饱和;试验台上五根柱子的落差,就是五种梯度的命运。
万能近似殿 · 无所不能的幻象
殿中央悬浮着一个函数——一条剧烈震荡的曲线,像心电图。Cybenko 1989 年证明了一件事——单隐层、Sigmoid 型激活,就能以任意精度近似紧集上的任何连续函数;Hornik 1991 与 Leshno 1993 把结论推广到非常数有界乃至非多项式激活。你拖动滑块,把隐藏层神经元数量从 1 拉到 10、50、100——曲线被一片片拼出来,越来越贴合。"够了,什么都能近似,一层就够。"但高斯老祖指着屏幕右下角一个数字——参数量。
高斯老祖
「万能近似只说'能',不说'需要多少',也不说'怎么训练'。万能是真的,但'能'不等于'值得',更不等于'训得动'。」
万能近似滑块 + MLP 架构搭建 + 参数量计算
拖神经元数量滑块看拟合 → 搭 MLP 算参数量 → 深度 vs 宽度对比
MLP 架构 · 784→128→10 参数量计算
深度替代宽度 · 参数量对比
详解 · K06-05 万能近似定理:MLP的表达能力与局限
Cybenko 1989:单隐层 + Sigmoid 型激活,可以任意精度近似紧集上的任何连续函数;Hornik 1991 与 Leshno 1993 把条件放宽到非多项式激活——「万能」是真的。但定理只保证三件事里的第一件:存在性。它不说需要多少神经元(所需宽度可随输入维度指数增长)、不说随机初始化 + 梯度下降能不能找到那组权重、更不说找到的函数能不能泛化。滑块演示的正是「能」与「值」的落差:100 个神经元拟合得好,参数量跟着涨到 300+;而深层网络用层级组合(底层学局部特征、高层组合复用)在许多函数族上用指数级更少的参数达到同样精度——「一层就够」在算术上不成立。
详解 · K06-06 多层感知机MLP:架构/前向传播/参数量计算
每层两个动作:zˡ=Wˡaˡ⁻¹+bˡ(仿射)、aˡ=f(zˡ)(非线性),交替堆叠即 MLP。参数量按层累加:Σ(n_out×n_in + n_out)——权重矩阵形状是 (n_out×n_in)、偏置按输出维计。殿里的账:784→128→10 为 (784×128+128)+(128×10+10)=100,480+1,290=101,770;宽窄对比 1隐层×1000=795,010 vs 4隐层×32=28,618,深度省约 28 倍——但参数效率的代价是梯度链更长(S8 的深渊等着记账)。维度自查是第一调试术:相邻层形状对不上,矩阵乘根本跑不通;这也是 S5 执行器每一步都标注张量形状的原因。
前向矩阵 · 数据之流
你面前展开了一张巨大的计算图——像一张电路图,节点是运算,边是数据。前向传播就是沿着这张图从左走到右。每一步,要么乘矩阵,要么加偏置,要么过激活函数。输入 x 进来,乘以 W₁,加上 b₁,过激活函数——出来的是 a¹。一直走到输出。但真正的重点在右边——计算图的终点挂着损失函数 L。走对了,L 小。走错了,L 大。但怎么回去修正?那得倒着走。倒着走之前,你得先正着走完。
高斯老祖
「前向传播是数据从左走到右。计算图不是装饰——它是你回去的路标。每过一个节点,你就该知道怎么倒回来。」
前向传播执行器 · 矩阵乘法 + 计算图 + 梯度账本
逐步执行 2→3→2→2 网络前向传播 → 绘制计算图 → 梯度账本启动
3 层 MLP · 2→3→2→2
梯度账本 · 待 S8 填入
详解 · K06-07 前向传播的计算流程:矩阵形式与计算图
前向 = 按拓扑序执行计算图:节点是运算(矩阵乘、加偏置、激活、softmax、损失),边是流动的张量。执行器实算的那条链:x=[1.00, 0.50] → z¹=W¹x+b¹=[0.50, 0.60, 0.10] → a¹=ReLU(z¹) → z²=[0.14, 0.51] → a² → z³=[0.11, 0.25] → ŷ=softmax(z³)=[0.47, 0.53] → L=−log(0.47)≈0.76。两个工程要点:①形状链 (2,)→(3,)→(2,)→(2,) 必须首尾相接,W 的形状是 (n_out×n_in);②前向必须缓存中间激活 aˡ——反向传播算权重梯度 ∂L/∂Wˡ=δˡ(aˡ⁻¹)ᵀ 时要用它,这正是训练比推理费显存的原因。这张图从右往左走,就是 S8。
初始化炼丹 · 起点之重
联结先师把你带到一座炼丹炉前。炉内悬浮着无数细小的权重值,像一群萤火虫。全设零?所有神经元学到一样的东西,永远一样。全设一?一样。随机?看你怎么随机。随机初始化的方差太大,激活值会爆炸;方差太小,激活值会消失。你得让信号在每一层保持稳定——进来的方差和出去的差不多。Glorot 说方差设成 2/(n_in+n_out)。He 说 ReLU 要另算,方差设成 2/n_in。
高斯老祖
「起点不对,后面全白走。Glorot 让方差不膨胀,He 替 ReLU 砍掉的那一半补足方差。这不是玄学——是线性代数。你来炼。」
初始化炼丹炉 · 4 方案 × 10 层分布直方图
选初始化方案 → 看每层激活分布直方图 → 看方差变化曲线
10 层激活分布 · 方差变化
详解 · K06-08 权重初始化:Xavier/Glorot初始化
Glorot & Bengio 2010(ICML)。目标只有一个:方差守恒——信号过一层,方差既不膨胀也不坍缩。推导骨架:z=Σᵢwᵢxᵢ 且各 wᵢ、xᵢ 独立时 Var(z)=n_in·Var(w)·Var(x),令前向稳定要 Var(w)=1/n_in;反向梯度走的是 n_out 条出边,令反向稳定要 Var(w)=1/n_out;两约束取折中得 Var(w)=2/(n_in+n_out),均匀版 w~U(−√(6/(n_in+n_out)), +√(6/(n_in+n_out)))。炼丹炉上的账:Xavier 档方差 1.0→0.98→1.01→0.99→1.0,十层不漂。适用边界:推导假设激活近似线性、零中心——对 Tanh/Sigmoid 成立;对 ReLU(砍掉负半轴、每层方差被动减半)会系统性补偿不足,这正是 He 的入场券(K06-09)。还要分清职责:初始化只管「起点」,训练中方差继续漂移,交给归一化(S7)。
详解 · K06-09 He初始化与ReLU网络的适配
He et al. 2015(ICCV,Delving Deep into Rectifiers)。ReLU 把负半轴归零:零均值输入下 E[f(z)²]≈Var(z)/2——激活方差每层自动砍半,Xavier 的 2/(n_in+n_out) 补不回来,深层 ReLU 网照样逐层变暗(方差按 0.5^L 衰减)。修正只改一个系数:Var(w)=2/n_in,把 ReLU 砍掉的那一半提前补足;炼丹炉上 He 档十层方差稳在 1.0→1.02→0.98→1.01→1.0。两个对照反例也在炉上:全零初始化——所有神经元算出相同输出、拿到相同梯度,永远学同一个特征(对称性破坏,排除刻痕④);w~N(0,10) 的随机过大——Var(z)=n_in·100,直方图两三层就糊成 NaN。推广:PReLU 的负斜率 α 对应 Var(w)=2/(n_in·(1+α²)),α=0 时退化回 ReLU 的 2/n_in。初始化保证第 0 个 epoch 的稳定,之后分布随训练漂移,是 S7 归一化的战场。
归一化与正则 · 稳定之术
你走出炼丹房,面前是一条布满闸门的水渠。水流代表激活值,从左流到右。初始化只管起点。训练过程中,每一层的输入分布会随前一层权重变化而漂移——这叫内部协变量偏移。Ioffe 2015 年给了你一道闸门——BatchNorm。它在每一层把当前 batch 的激活值拉回均值 0、方差 1,再用 γ 和 β 放缩偏移。但 batch 太小怎么办?序列模型怎么办?于是有了 LayerNorm。还有 Dropout——训练时随机关掉一半神经元,逼剩下的自己学。
高斯老祖
「归一化稳分布,正则防过拟合。但它们稳的是前向——反向的梯度呢?你以为加了这些就稳了。你以为对了。」
归一化水渠 · BN/LN/GN + Dropout 正则演示
切换 BN/LN/GN 看分布直方图 → 切 batch 大小看 BN 抖动 → Dropout 防过拟合
每层激活分布 · 归一化前后
Batch 大小影响 · BN 在小 batch 时抖动
Dropout 正则 · 训练/验证损失
详解 · K06-10 Batch Normalization:原理/训练/推理差异
Ioffe & Szegedy 2015(ICML)。公式两步:x̂ᵢ=(xᵢ−μ_B)/√(σ_B²+ε)——用当前 mini-batch 的统计量把激活拉回均值 0、方差 1;再 yᵢ=γᵢx̂ᵢ+βᵢ——γ/β 是可学的放缩偏移,保证「能归一化」不等于「必须归一化」,网络需要时可以学回任意分布。训练/推理差异是 BN 的身份证:训练用 batch 统计量(μ_B、σ_B 随 batch 内容变),推理用训练期累积的移动平均——所以 BN 的输出依赖 batch;batch=2 时统计量噪声大,水渠直方图剧烈抖动(小 batch 场景换 LN/GN,正是台上 batch 滑到 2 时刻痕的判词)。动机之争:原文归因于缓解内部协变量偏移;NeurIPS 2018 的后续工作拆开归一化逐项检验,发现真正的收益更可能来自损失面的平滑化——机制解释至今未盖棺。确定的三条红利:容忍更大学习率、收敛更快、自带轻微正则。惯例插在仿射与激活之间:z→BN→f(z)。
详解 · K06-11 Layer Normalization与Group Normalization
把归一化的「统计范围」换一个轴,就得到 BN 的两个替身。LN(Ba et al. 2016):对单个样本沿特征维归一化——每个样本自己算自己的 μ/σ,与 batch 大小彻底无关;序列模型的标配(RNN 每个时间步、Transformer 每个 token 的隐向量独立归一化),这是 LN 成为 Transformer 默认的根本原因。GN(Wu & He 2018, ECCV):把通道分成 G 组、组内归一化——G=1(全部通道一组)退化为 LN,G=C(每通道一组)退化为 InstanceNorm,GN 是两者的插值。选型口诀:大 batch 分类 BN 最优;检测/分割 batch 只有 1-4 时 BN 统计失真,GN 顶上;变长序列、自回归生成用 LN。共同点:都带 γ/β 仿射、都稳分布;差异只在「沿哪个轴取统计」——水渠上 BN/LN/GN 三档直方图同样稳,唯独 BN 挂着 batch 旋钮,这就是全部区别。
详解 · K06-12 Dropout:随机失活的正则化效果
Srivastava et al. 2014(JMLR)。训练时每个神经元以概率 p 独立失活(MLP 常用 p=0.5,即台上滑块):前向变成瘦身子网络,反向也只更新幸存者;推理时全网络工作、激活按 (1−p) 补偿——工程实现用 inverted dropout:训练时就除以 (1−p),推理零改动。正则机制是打断「共适应」:随机断线让任何神经元都无法把命运押在某个特定伙伴上,被迫学出冗余、分散的特征;理论上近似于 2ⁿ 个共享权重的子网络隐式集成。水渠上的两条曲线:训练损失照常下降,验证损失在后段(epoch>10)被压低、不再回头涨——过拟合剪刀差收窄。代价:训练损失初期抬高、收敛变慢;p 并非越大越好——输入层常用 0.2,卷积层更低或改 SpatialDropout。与 BN 叠用要小心:失活会扰动 BN 的 batch 统计,惯例 BN 在前、Dropout 放输出侧或干脆不叠。
反传深渊 · 链式之链
你站在计算图的右端——损失函数 L 挂在那里,像一个红色的果实。前向传播从左走到右,到 L 为止。现在你要倒着走回来。每倒退过一个节点,就乘以那个节点的局部导数。这叫链式法则。走到第一个权重,你就知道它该怎么改。这就是反向传播。计算图上的节点开始从右到左亮起。你注意到一件事——每过一层,梯度就小一点。到第一层时,梯度范数已经从 1.0 缩到了 0.0000038。梯度账本上的数字一格一格地填满——全部在衰减。
梯度消失之渊
「你以为倒着走就能回去?每一步都在缩小。十层之后,你什么都带不回来了。」
高斯老祖
「反传每走一层就缩一次。你以为掌握了训练的全部秘密——但你走到第一层时,手里什么都没剩。推导完链式法则,翻开梯度账本。」
反向传播推导器 · 链式法则 + 梯度账本 + 梯度消失/爆炸
选损失函数 → 逐步推导链式法则 → 梯度账本填满 10 层 → 梯度消失/爆炸对比
梯度账本 · 10 层 Sigmoid 网络梯度范数
梯度消失 vs 梯度爆炸
详解 · K06-14 损失函数设计:MSE/交叉熵/Huber/Focal Loss
损失函数是计算图最右端那颗红果——它决定梯度往哪儿拽。推导器上的四选:MSE L=(1/n)Σ(y−ŷ)²,回归默认;注意它配 Sigmoid 输出时梯度 ∂L/∂z=(ŷ−y)·σ'(z),饱和区 σ'→0 学不动——这不是 MSE 的错,是它与饱和激活的组合债。交叉熵 L=−Σyᵢlog(ŷᵢ),配 softmax 后梯度恰好化简为 (ŷ−y)——log 的导数与 softmax 的导数相消,这就是「分类必用 CE」的数学理由;S5 执行器算的 L=−log(0.47)≈0.76 正是它,S8 的反向链从这个数起步。Huber:|e|≤δ 时二次、超出后线性——误差再大梯度也封顶在 δ,对离群点鲁棒,回归数据的防炸保险丝。Focal(Lin et al. 2017,RetinaNet):L=−(1−p_t)^γ·log(p_t),γ=2 把大量「已分对」的简单样本降权,让难例主导梯度——为类别不平衡而生(正负样本 1:1000 的检测任务)。选型表:回归→MSE/Huber;分类→交叉熵;不平衡→Focal 或加权 CE。
详解 · K06-15 反向传播算法:链式法则的完整推导
推导器点亮的四条公式就是全部:① 输出层 δᴸ=∇_aL⊙f'(zᴸ)——损失对激活的梯度逐元素乘激活导数;② 递推 δˡ=((Wˡ⁺¹)ᵀδˡ⁺¹)⊙f'(zˡ)——下层误差先被转置权重搬运、再被本层激活导数削一刀,逐层向左;③ ∂L/∂Wˡ=δˡ(aˡ⁻¹)ᵀ——权重梯度是本层误差与上层激活的外积(这就是前向必须缓存 aˡ 的原因);④ ∂L/∂bˡ=δˡ。本质:链式法则在计算图上按逆拓扑序执行——每个节点只需知道自己的局部导数,乘起来就是全局梯度。代价账:一次前向+一次反向≈2-3 倍前向的计算量,S4 那张 101,770 参数的网络每步只付约三个前向的价钱;数值差分要每个参数扰动两次前向——二十万次前向换一步梯度,这是深度网络在 1986 年之前「深不起来」的算术原因。历史:Werbos 1974 博士论文首提,Rumelhart/Hinton/Williams 1986(Nature)让它翻案。账本上的 0.25⁹≈3.8×10⁻⁶ 不是 bug——公式②连乘九次的必然结果,S9 的深渊从这里裂开。
Boss 战 · 梯度消失之渊
计算图裂开了。不是从上面裂——是从下面。你脚下的地面塌陷,露出一个深渊。深渊里没有黑暗,有的是光——无数衰减的光,像一串越走越远的脚印,每一步比上一步暗 75%。那是梯度。你的梯度。被它吞掉的梯度。深渊凝成一个形体。它不像之前那些 Boss——它不嘲讽,不轻蔑。它只是平静地看着你:"你以为层数越多学习能力越强。但梯度在反向传播中指数衰减。你不能训练你够不到的东西。"
梯度消失之渊
「三问。答对了,你过去。答错了,你的梯度永远到不了第一层。你手里的梯度账本和排除刻痕——能用上的,都用上。」
深度债累计 0 笔 · 三问全对后清零
详解 · K06-16 梯度消失与梯度爆炸:原因与缓解策略
公式②的连乘是唯一的祸根:δˡ 要穿过 (L−l) 个 Wᵀf'(z) 的雅可比,连乘项的谱范数持续 <1 → 指数衰减(消失),持续 >1 → 指数膨胀(爆炸)。消失:第一层权重收不到有效信号,「你不能训练你够不到的东西」;爆炸:更新步跨上天、损失变 NaN——RNN 的职业病(同一组权重循环相乘 L 次,Bengio 1994;Pascanu 2013)。缓解工具栈按攻击对象排:攻击 f'——换 ReLU/GELU(正区导数≈1);攻击 W——Xavier/He 初始化(谱半径起手就≈1);攻击漂移——BN/LN 把 z 拉回非饱和区;爆炸专治——梯度裁剪(‖g‖ 超阈值就等比缩回,Pascanu 2013);结构性根治——残差连接(K06-13)。Boss 第二问的考点:ReLU+He+BN 各修一个因子,但 30 层串行通路上 |W·f'| 整体仍 <1,第 1 层梯度≈0.01——参数级修复全部正确、结构性衰减依旧,这正是「修不够、只能绕」的判词。
详解 · K06-13 残差连接Residual Connection的直觉
He et al. 2016(CVPR,ResNet):把「学变换 H(x)」改写成「学残差 F(x)=H(x)−x」,输出 y=F(x)+x。三重直觉:① 优化视角——∂y/∂x=1+∂F/∂x,恒等项的 +1 给梯度一条永不衰减的保底通路:F 支路的梯度再小,梯度照样回得了第一层(Boss 第三问的正解);② 学习难度——恒等映射意味着「不动」,把 F 的权重推向零即可达成,比从随机权重学出完整变换容易得多;③ 集成视角(Veit et al. 2016)——ResNet 隐式等价于大量长短不一的浅路径集成,删掉个别层性能只是缓降而非崩塌。实证:152 层可训,ILSVRC 2015 夺冠;而无捷径的 plain 网络 56 层反而输给 20 层——退化是优化问题,不是过拟合。S10 账本三组对比的第三条线:ResNet 30 层梯度范数稳在 0.8-1.2,那条绿线就是 +1 通路在跳。本质不是消灭梯度消失,是给它一条绕过连乘的路——「不是修,是绕」。
通途之链 · 顿悟
深渊合拢后,地面上留着一道细细的绿线——残差连接的痕迹。它从网络的第一层直通最后一层,绕过了中间所有的衰减。一面墙亮了起来,上面刻着你这章的全部足迹:从生物神经元到 M-P 模型。从感知机到 XOR 的崩塌。从激活函数到万能近似。从前向矩阵到计算图。从初始化到归一化。从链式法则到梯度消失。从深渊到残差。你搭的每一个零件都对。但它们解决的是"前向稳不稳"的问题。梯度消失是"反向通不通"的问题。残差连接给了梯度一条不经过衰减的路。不是修,是绕。
高斯老祖
「你这一章走了三段路:搭起来、训不动、绕过去。记住这个闭环——后面的每一章都是在这个闭环上加东西。下一站,反向传功。你已亲手推完链式法则、见过梯度怎么衰减——下一章把'怎么把梯度算得快、用得好'的功课补全。」
训练闭环拼图 · 16 知识点 + 梯度账本三组对比
点击 13 张卡片归位训练闭环(覆盖 16 知识点)→ 梯度账本三组对比 → 排除刻痕终览
训练闭环拼图 · 点卡片到正确环节
梯度账本三组对比 · Sigmoid / ReLU+He+BN / ResNet
排除刻痕终览 · 五道弯路
复盘 · 神经初醒主线:从生物神经元到残差捷径的十六步
回望整条链:S0 把八百六十亿颗神经元压成 y=f(Σwᵢxᵢ+b)——整合+决策,缺一不可(K06-01)。S1 感知机用一张超平面切开世界,Novikoff 界承诺线性可分必收敛(K06-02)。S2 四颗光点杀死它:凸包相交、直线无解——多层与非线性是刚需不是奢侈品(K06-03)。S3 按导数选钥匙:Sigmoid 的 0.25⁹≈3.8×10⁻⁶ 记上账本第一笔(K06-04)。S4 万能近似只给存在性:宽 795,010 vs 深 28,618 的参数账,悬置「找得到吗、泛化吗」(K06-05/06)。S5 前向=计算图:形状链首尾相接、激活必须缓存(K06-07)。S6 起点之重:Xavier 守 Tanh、He 补 ReLU(K06-08/09)。S7 稳前向:BN 沿 batch 维、LN 沿特征维、GN 组内折中,Dropout 用随机断线换冗余(K06-10/11/12)。S8 反向四式:δ 递推逐层连乘,账本填满指数衰减(K06-14/15)。S9 深渊摊牌:|W·f'|<1 连乘是结构性死刑,工具栈修得掉参数、修不掉结构(K06-16),破局是 y=F(x)+x——恒等 +1 通路让梯度绕过一切(K06-13)。主线一句话:前向求稳(激活/初始化/归一化),反向求通(链式法则/梯度通路)——深度的秘密不在层数,在信号去得了远方、梯度回得了起点。筑基一层圆满;下一章反向传功,把「梯度算得出」推进到「梯度用得好」。