多核共鸣
你以为多核就是单核×N,共享内存天然一致。但Amdahl定律的串行天花板和缓存一致性的数据分裂让扩展性远非线性。一致性不是天生的,是靠协议一拍一拍抢回来的。
频率之墙
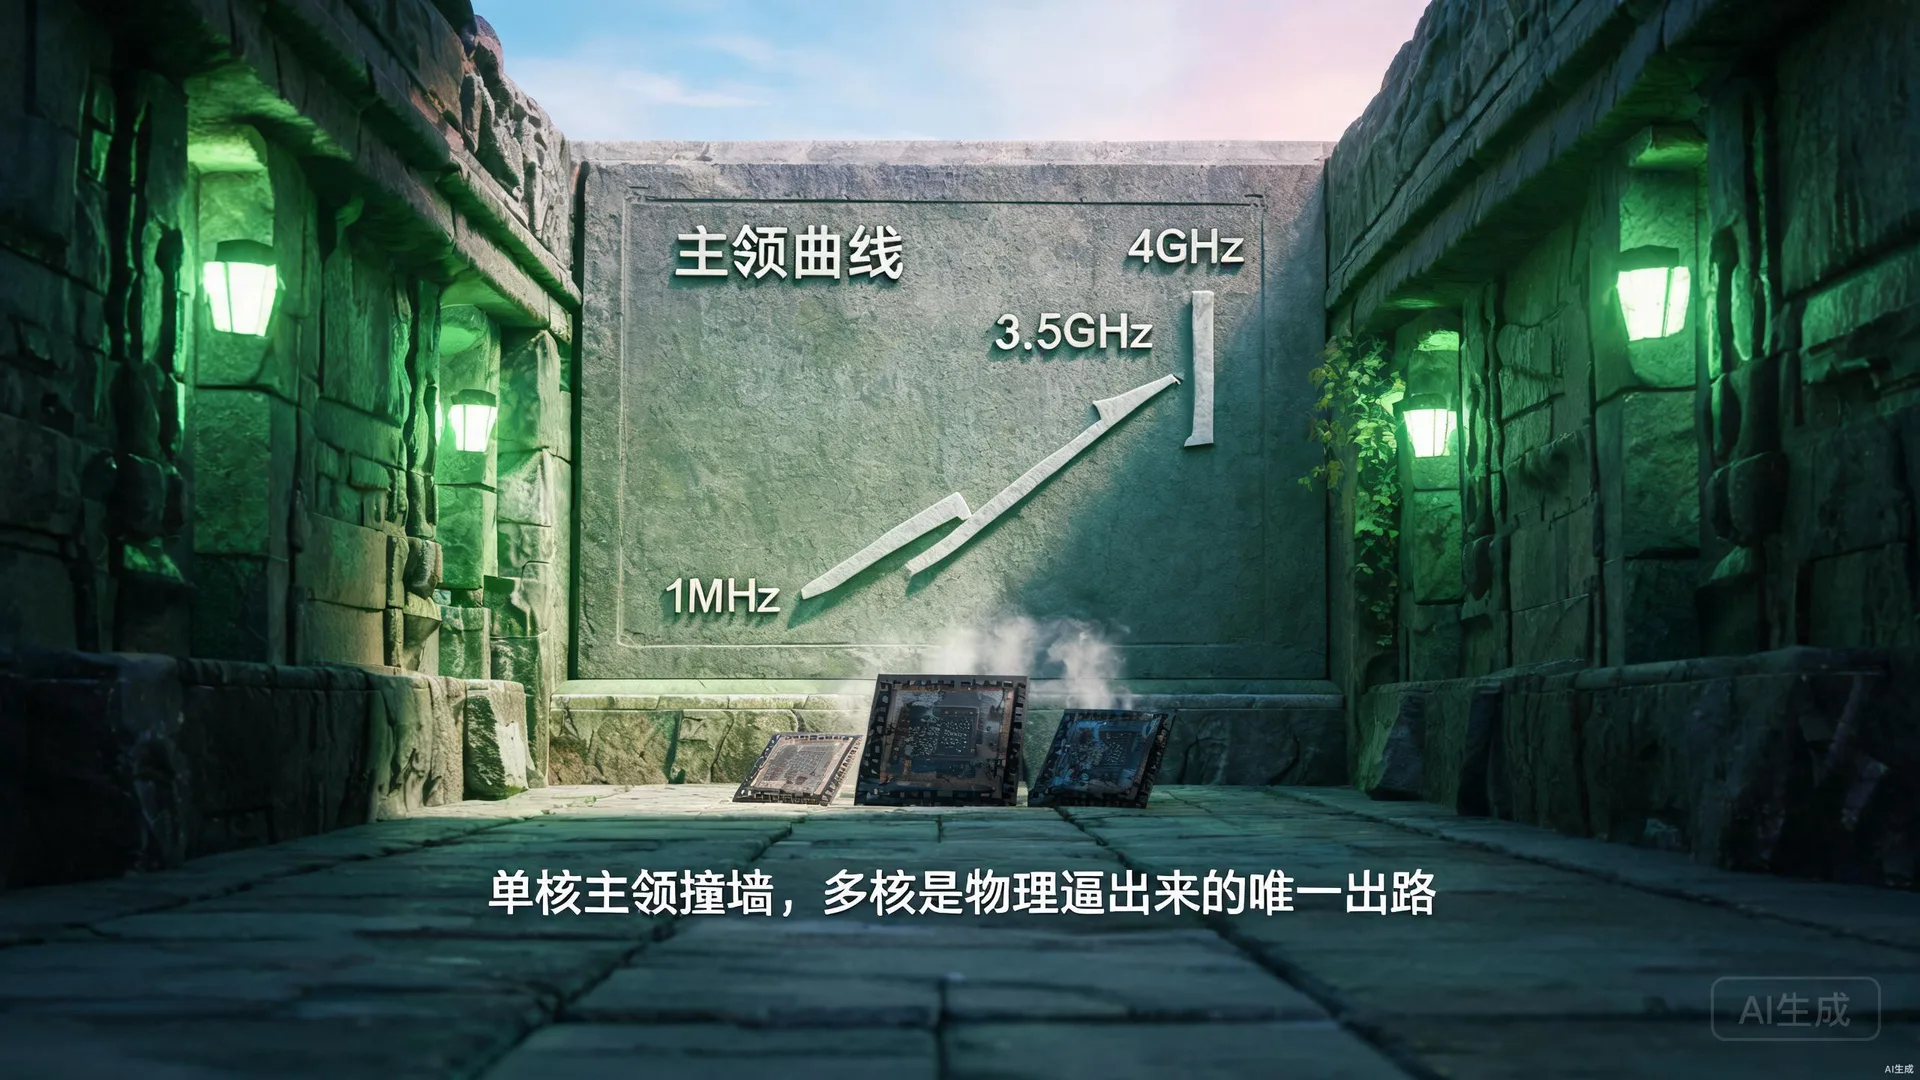
结丹四层的试炼甬道尽头,是一面巨大的石墙。墙面上刻着一条攀升的曲线——主频曲线——从1MHz一路爬向4GHz,却在3.5GHz附近猛然折断,像撞上了一面看不见的壁障。墙根处散落着几块烧焦的晶片残骸,隐隐散发着余热。
 诺依曼老祖
「单核的路,走到这里就断了。2005年,主频停在3.5GHz附近——不是做不上去,是功耗把它按死了。」
 一致性之乱
「既然一条路走不通——那就多开几条路。N条路,N倍快。你说是不是?」
频率之墙预测挑战器
先下注N倍预测 → 推主频滑块看P∝CV²f功耗墙 → 看暗硅热力图
频率-功耗推墙实验 · P = C·V²·f
暗硅热力图 · 64核芯片俯视图
详解 · K15-01 从单核到多核:为什么需要多处理器
1986–2003年单核性能年均增长约52%(Hennessy & Patterson Ch1)——三台发动机在推:流水线加深、超标量乱序挖掘ILP、主频攀升,而三者的共同燃料都是功耗预算。动态功耗 P=C·V²·f,Dennard缩放让电压随工艺等比下降,所以频率翻倍功耗只温和上涨。2004–2005年这台机器熄火:阈值电压压到漏电流的物理下限,V_dd卡在约1V,P∝f³的獠牙露出来——Intel同年砍掉4GHz计划(Tejas)、2005年转向双核(Pentium D / Athlon 64 X2)。ILP也撞墙:乱序窗口扩大数倍,IPC增益却递减(H&P Ch3)。出路是一道算术题:同功耗下两个0.7倍电压/频率的核≈0.69倍功耗、约1.4倍吞吐——频率换并行稳赚。台上那条在3.5GHz折断的曲线,就是这段产业史的拓印。Trade-off:单线程峰值性能从此让位于吞吐量。
详解 · K15-10 功耗墙与暗硅(Dark Silicon)
Dennard 1974年证明:晶体管等比缩小时若电压同步下降,功率密度近似不变——「每代工艺白送频率与晶体管」。2005–2006年(90→65nm)这条定律失效:阈值电压无法随V_dd继续降(亚阈值漏电流指数增长),电压停在约1V,单位面积功耗随晶体管密度上升。后果由Esmaeilzadeh等定量推演(ISCA 2011):固定功耗预算下,22nm约20%的晶体管点不亮、16nm约35%、8nm超过50%——「暗硅」。台上的热力图(20%→35%→50%)正是该模型的游戏化:预算恒定,能同时点亮的核反而越来越少。工程对策三条:DVFS降电压降频(性能让路)、power gating关闸睡核、异构专精(用更少晶体管把一件事做到极致——S8的大小核与SIMD)。Trade-off:要么牺牲峰值性能,要么牺牲晶体管利用率——暗硅无法消灭,只能被调度。
多核法阵 · SMP初成
石墙后是一座空旷的法阵基座,基座上刻着四条空槽——四个核心位。中央是一座内存塔,四条总线槽从核心位辐射向塔。
诺依曼老祖
「搭起来。四个核心,共享一座内存。这就是SMP——对称多处理。」
一致性之乱
「对称,共享,多好——每个核看到的内存都一样。对吧?」
SMP架构搭建器
拖核心入位 → 连共享总线到内存塔 → 启动验证UMA
多核并行吞吐量
详解 · K15-02 对称多处理(SMP)架构
SMP五要素(Stallings Ch14):对等核、统一共享地址空间、UMA(各核到内存等延迟)、单一操作系统映像、共享总线+仲裁。台上你连的就是教科书拓扑:四个对等核挂一条共享总线,内存塔是唯一真值源。总线给SMP三重馈赠:广播介质(每个cache控制器都看得见)、天然串行化(同一时刻只容一单事务→操作全序免费)、结构极简。也是三重枷锁:带宽随核数摊薄、电气负载限制挂载数、仲裁延迟随核数上升。商用史:Pentium Pro(1995)首次把MESI总线监听带进x86,SMP一路走到8路服务器。经验边界:共享总线SMP在4–8核后吞吐即被总线事务吃掉——S5你会亲眼看到锁竞争把带宽吞到70%,这就是通往NUMA与NoC的剧情伏笔。UMA的「等延迟」是共享内存编程模型最干净的物理底座:程序员不需要知道数据在哪。
天律推演 · Amdahl之壁
法阵基座旁升起一座推演台,台上刻着一条公式槽,空的。
诺依曼老祖
「你搭了4个核。那我问你——4个核,几倍加速?别猜。推。」
一致性之乱
「4倍。你自己说的。」
Amdahl之壁公式组装器
预测四选一 → 双旋钮控制变量实验台 → 六步公式推导 → 极限验证
控制变量实验台 · s × N 联动S曲线
公式推导 · 六步展开 S = 1/(s+(1-s)/N)
详解 · K15-09 Amdahl定律与多核性能扩展分析
Amdahl 1967年原文的本意就是泼冷水:只要程序有串行部分,并行加速就有上界。你在台上推完的六步给出闭式:S = 1/(s+(1-s)/N),N→∞时 S_max=1/s。代入验算:s=0.1、N=4 → 1/(0.1+0.225)=3.08×;N=16 → 6.4×;N=64 → 8.77×——离10×的天花板越来越近,离64×永远遥远。注意s的口径:不只是「没并行化的代码」,同步、锁竞争(S5的自旋锁)、通信、内存墙全都计入s。反方是Gustafson(1988):若问题规模随N增长(scaled speedup,S'=N−s(N−1)),扩展近乎线性——s=0.1、N=64时S'=57.7×。两律合读:固定负载看Amdahl(悲观),固定精度看Gustafson(乐观)。台上双旋钮把s从0调到0.5,曲线从直线塌成折线——这不是数学游戏,是每一代超算与多核采购评审的第一张表。
幻影内存 · 一致性之乱初现
推演台沉入地下,S1的SMP法阵重新亮起。但这一次,每个核心旁边多出了一面小镜子——L1 Cache。
诺依曼老祖
「你搭的SMP,每个核都有自己的L1。共享内存——你确定它们看的是同一个世界?」
一致性之乱
「共享?对——它们共享一个'真相'。各自一份。」
双核心读写时序控制器
两核各读A → 各自修改 → 看L1副本分叉 → 法阵裂痕蔓延
时序 · 数据分裂
详解 · K15-14 多核的编程模型:共享内存 vs 消息传递
共享内存模型(pthreads/OpenMP):所有线程读写同一地址空间,通信隐式发生在load/store里——写起来最像单线程直觉,代价是一致性与同步全成了程序员的责任(锁、原子操作、内存序,S5连环坑)。消息传递模型(MPI/Actor/CSP):进程各拥私有内存,通信必须显式send/receive,不共享可变状态——S3台上「各有各的真相」的撕裂在这个模型里根本不存在,因为副本即真相、通信即复制。Trade-off:共享内存赢在低延迟细粒度共享(单机多核的天然形态),消息传递赢在容错与扩展(无共享状态→无一致性协议开销→天然跨机;超算MPI与Go channel皆此脉)。物理层的讽刺是两者互相实现:NUMA的「共享内存」建立在互连网络的消息传递之上(S6/S7),而消息传递的管道与通道又跑在共享内存缓冲区上。你这一章搭的SMP+MESI,本质是给「共享内存这个甜蜜谎言」做工程兜底——抽象是谎言,但它是能兑现的谎言。
MESI之环 · 一致性协议
SMP法阵的裂痕还在。诺依曼老祖抬手,在法阵上方凝出一个四色光环——M紫、E青、S金、I灰。
诺依曼老祖
「MESI。四个状态,一套协议。它不消灭私有缓存——它让多份副本知道彼此的存在。」
一致性之乱
「修补?好。你修一个,我看着。」
MESI之环状态机交互器
点PrRd/PrWr触发总线事务 → 看四态转换 → S3裂痕逐段修复
详解 · K15-07 多核处理器的Cache一致性工程实现
台上这套双核MESI就是工程原型的最小化:两条总线事务撑起全部语义——BusRd(我要读,谁有副本请应答)、BusRdX(我要独占写,所有副本立即作废),BusWB(写回内存退位)。E态是协议的省钱设计:PrMiss时若无人应答BusRd,缓存行直接落E——此后本地写入E→M一声不响(silEnt upgrade,零总线事务),这就是「独占」二字的含金量。S态写则必须先BusRdX把兄弟副本打成I,台上计数器里BusRdX每跳一次,就是一次全总线的作废广播——你按「尝试跳过BusRdX直接S→M」时被拦下,因为跳过它就等于允许两个M并存,S3的数据撕裂当场复现。商用演化两条路:监听协议(snooping,Pentium Pro起)靠总线广播天然看得见一切,但核数一多广播风暴吞带宽;目录协议(directory,NUMA标配)把「谁持有副本」记成一张表,消息点对点精准投递——扩展性换来了目录存储与查找延迟。扩展态:AMD的MOESI加O态(Owned,脏数据可直供兄弟核,省一次回写);Intel的MESIF加F态(Forward,指定唯一应答者,避免多核同时应答的总线冲突)。另一类坑与正确性无关但同样致命:false sharing——两个核写同一缓存行里不同变量,MESI照样来回作废,性能掉到串行以下;解法是缓存行对齐填充(padding)。
同步之锁 · 竞态深渊
MESI光环还在转。法阵上自动运行一段新程序:两个核心各执行counter++一万次。counter初值0,结果应该20000。结果跳出来:17382。
诺依曼老祖
「……」
一致性之乱
「一致性?你有一致性。每个核读到的值确实是一致的——它们一致地读到了旧值,一致地覆写了对方的结果。」
竞态复现器 · 三种同步原语对比
慢速回放读-改-写 → 套自旋锁/互斥量/屏障 → 看锁竞争是新瓶颈
详解 · K15-08 多核同步原语:自旋锁/互斥量/屏障
counter++丢失2618次(17382≠20000)的元凶是「读-改-写」三步不原子:两核各读旧值、各加一、各写回,MESI只保证第二次写之前能看到对方的值——它管顺序,不管你读完到写回之间发生了什么。三种原语是三种止损方案(CSAPP Ch12)。自旋锁:test-and-set原子指令(x86的lock xchg/cmpxchg)把「读-改-写」压成硬件不可分割的一步,拿不到锁就忙等;台上你把竞争核数从2拉到8,总线带宽被自旋风暴吃掉70%——每个等待者都在疯狂BusRd监听锁变量,锁本身成了热点缓存行。工程改良:ticket锁(取号排队,FIFO公平,杜绝饥饿)、MCS队列锁(每个等待者自旋于自己专属的缓存行,总线流量降为O(1)次失效)。互斥锁:拿不到就睡眠(futex:先用户态自旋几圈,再进内核挂起),省下空转的核,代价是一次上下文切换约1–10μs——临界区必须长过切换开销才划算,短临界区自旋反而赢。屏障(barrier):所有线程到齐才放行,用于并行循环的同步点;实现用sense reversal(双相翻转),避免所有线程挤在同一变量上自旋。选型口诀:短临界区多核自旋、长临界区或可能阻塞用互斥、阶段推进用屏障。锁不是免费的:Amdahl公式里的s,一大半是锁竞争捐的——S2那条抬不起头的曲线,在这台上有了物理解释。
NUMA裂土 · 远近之别
S5的自旋风暴还没散尽。诺依曼老祖抬手,SMP的共享总线断裂成四段——每个核心获得了一座自己的内存塔。
诺依曼老祖
「总线走不动了。裂土。每个核守自己的地盘——访自己的内存快,访别人的慢。这就是NUMA。」
一致性之乱
「平等多好——可平等走不远。那就承认差异吧。远近有别,才是大国的治理之道。」
NUMA拓扑 · 数据放置实验
点NUMA节点发起访存 → 把数据放本地/远端 → 看延迟差数倍
详解 · K15-03 非一致存储访问(NUMA)架构
NUMA的裂土不是任意切割:每个节点=一小组核+本地内存+节点间互连(Intel UPI / AMD Infinity Fabric),地址空间仍然统一——所有节点看得见全部内存,只是远近不同。台上的延迟刻度就是真实比例的缩影:本地80ns(1×)、一跳节点160ns(2×)、最远节点320ns(4×);真实双路服务器上远端延迟约1.4–1.9×,四路以上2–4×并不夸张。关键约束:MESI一致性照常工作(所以叫ccNUMA,cache-coherent NUMA),代价是目录协议接管监听——S7你连的片上网络就是节点间那条互连。编程上的分水岭是页放置:Linux默认first-touch——页分给第一个触碰它的节点,串行初始化的数据全落单节点,并行阶段其他节点全在跑远端访问,性能能掉一半。三板斧:numactl --cpunodebind+--membind把线程与内存钉在同域;--interleave轮询分配(对付无法局部化的随机访问);内核的自动页迁移(NUMA balancing,周期性统计缺页热点把页搬回使用者)。台上你手动做的「迁移数据到节点0」,内核每几秒就在真实机器上做一遍。Trade-off:UMA让程序员无知地快乐、让机器拥挤地死去;NUMA把「数据在哪」写进性能账本——扩展性的每一分,都是从抽象里赎回来的。
脉络之网 · NoC片上网络
NUMA的四个节点之间,空荡荡的——没有连线。
诺依曼老祖
「总线断了,你需要新的脉络。片上网络——NoC。不是一根线连所有,是很多根线连很多点。」
一致性之乱
「连线?好——你连。每多一条路,就多一个我藏身的岔口。」
NoC拓扑博弈探索器
选Mesh/Ring/Tree/Torus → 路由数据包 → 看延迟/带宽/拥塞对比
详解 · K15-04 片上网络(Network-on-Chip, NoC)基本原理
共享总线的死穴台上已经演示过:同一时刻只容一单事务,核数翻倍带宽减半。NoC的解法是把「一根线连所有」换成「很多短线连很多点」——每个节点配一台路由器(router),消息切成报文(packet)再切成流控单元(flit)逐跳转发,多条链路可同时传不同的报文,总吞吐随网络规模增长而不是摊薄。路由器五段流水(H&P Ch4/Dally教材):输入缓冲(IB)→路由计算(RC,查表或算术决定下一跳)→虚通道分配(VA)→交叉开关分配(SA)→交叉开关传输(ST)。你按「尝试总线连所有」时被警告的正是带宽算术:64核挂一根总线,每核分到的带宽是1/64;Mesh上每对相邻节点独享一条链路,同时通信对数可达链路数(8×8网格112条双向链路)量级。代价是把广播变成了难题:总线时代MESI的作废广播人人可见,NoC上广播要生成多播树或逐点投递——这就是为什么商用多核(如Intel Mesh上的目录协议)普遍用目录+点对点消息替代监听。台上网格里流动的紫色数据包粒子,每一颗都在走这条五段流水。
详解 · K15-05 NoC拓扑结构:网格/环形/树形/torus
四种拓扑用同一组指标打分:对角跳数((0,0)→(7,7)的最短路径)、全网平均跳数、聚合带宽、布线成本。Mesh:维序曼哈顿路径7+7=14跳,平均2×63/24≈5.3跳;链路短、布局规整、扩展只加行列——但延迟随距离线性长,对角通信天生吃亏。Ring:64节点按行序连成一圈,(0,0)与(7,7)恰好相邻(首尾相接)只要1跳——但这是运气,全网平均64/4=16跳、最坏32跳,且所有远距流量都要挤过同一段环,带宽随规模恶化;它的胜场是布线最省(每节点2条链路),IBM Cell、Intel Haswell的环状互连、NVLink的环都是它。Tree:64叶二叉树,叶到叶必经根6+6=12跳,平均约10跳——树根是全网的带宽瓶颈,只适合汇聚型流量(如所有核写同一个汇聚点)。Torus:Mesh每行每列首尾相接,对角距离降为min(7,1)×2=2跳、平均约4跳、延迟方差最小——代价是链路数翻倍(环绕边要跨芯片长走线)。台上四键切换读数对得很齐:Torus「延迟最低/布线代价高」、Ring「带宽低/成本最低」。没有全能冠军:消息偏斜(traffic pattern)决定谁赢——对角流量选Torus、规整近邻选Mesh、汇聚流量选Tree、成本敏感选Ring。
详解 · K15-06 NoC路由算法与流量控制
拓扑是路网,路由算法是交通规则。维序路由(XY-routing):先沿X走完再拐Y——规则简单,且通道依赖图天然无环,不会死锁;8×8 Mesh上(0,0)→(7,7)正是先右7步再下7步。自适应路由:看实时拥塞绕路(XY堵了走YX),延迟更低,但「各走各的聪明」可能围成一个环互相等——你按「触发自适应路由死锁」看到的四个数据包原地打转,就是通道依赖环:每个包持有对方需要的链路、等待对方释放的链路,循环等待=死锁。三个解药:turn model(禁止环上必要的一两个转弯,如奇偶转弯限制)、虚通道(VC,一条物理链路分时复用多条逻辑通道,打破物理等待环)、路由限制(逃生通道escape VC,永远维序、保证可达)。流控层决定报文怎么切开走:存储转发(整包收齐再转发,延迟=跳数×整包)、虚切割(收到头flit即可转发,流水起来)、虫孔(wormhole,头flit探路、后续flit像蠕虫身体一样跟着流,缓冲需求最小——但头flit被堵,整条蠕虫横占多跳链路,最容易死锁)。工程组合拳:XY+虫孔+2条虚通道(一条自适应一条逃生),是学术与商用(如Tilera、Intel SCC)反复验证过的稳态配置。
异构之道 · 大小核与向量
NoC的网格上,64个一模一样的核心整齐排列。诺依曼老祖抬手,网格上有一半核心开始变暗——暗硅。
诺依曼老祖
「64个一样的核,你点亮不了几个。功耗墙没消失——它换了个形式。如果——不是所有核都一样呢?」
大小核调度 · SIMD宽度 · 三架构对比
切大小核看功耗 → 切SIMD宽度看吞吐 → 点三架构热区
SIMD宽度对比 · 数据级并行
多核设计实例对比
详解 · K15-11 同构多核 vs 异构多核(大小核架构)
同构多核的信仰是「一颗核设计好,复制N遍」——编程简单、调度对称、验证一遍过;它的坟墓正是K15-10的暗硅:功耗预算只够点亮一小撮核时,其余大核是点了不敢用的奢侈摆设。大小核把预算花在刀刃上:小核(E-core)用大约1/4的面积换来单位功耗下接近的性能(能效最优区),大核(P-core)保留单线程峰值——ARM big.LITTLE(2011,A15+A7)首创,Intel Alder Lake(2021,Golden Cove+Gracemont)跟进,Apple M系列全线皆此脉。台上的三模式读数就是调度器的真实困境:「后台任务」全用小核3W拿下,「突发任务」大小核齐上抢延迟,「全用大核(同构)」功耗翻几倍还点亮不了几颗——EAS(Energy Aware Scheduling,Linux 5.0+)干的就是这个决策:用每核的能耗-性能曲线(energy model)把任务往「性能刚好够用」的核上推。异构的代价是调度复杂度(线程迁移跨核微架构状态、缓存冷启动)与内存序差异(ARM上不同核的内存模型细节曾让锁代码踩坑),以及验证成本——每多一种核,测试矩阵乘一次。Extreme异构是GPU/加速器路线:数量换宽度、宽度换单元面积,量级再降一个台阶——但那已需要主机-加速器编程模型,共享内存的甜蜜谎言到此为止。
详解 · K15-12 多核处理器设计实例:Intel/AMD/ARM架构对比
三家把同一道题(功耗墙下堆并行)答出三种卷法。Intel:单die大到良率扛不住后走P+E混合,Alder/Raptor Lake用环形总线串起P核簇与E核簇,缓存一致性靠环上的监听盒(CBox)与目录;Meteor Lake起转向tile拼装——异构从核级上升到die级。AMD:Chiplet是最激进的解耦——Zen CCD(8核,共享L3)做小片良率高,I/O die单独工艺(IOD),两者用Infinity Fabric(NUMA式互连)拼接;EPYC最高12 CCD = 96核单插槽,台上的NUMA远近之别在片内真实存在(跨CCD的L3访问延迟不同)。ARM:不造芯片只造蓝图,big.LITTLE/DynamIQ定义大小核接口,互连(CMN,mesh NoC,正是S7台上那张网)外购可配——生态卷法导致终端百花齐放:Neoverse N系列打云上能效、V系列打HPC,Apple/高通/联发科各拿蓝图改出自己的异构。三条路线一个共同点:没有人再堆「更多相同的核」——Intel卷混合调度、AMD卷die拼装、ARM卷生态分工,全部押注「更合适的核」。台上三张架构热区卡片点开时,看的正是这三种赌注的物理形态。
详解 · K15-13 向量处理与SIMD扩展(SSE/AVX/NEON)
多核是线程级并行(TLP),SIMD是数据级并行(DLP):一条指令、多个操作数同时算——寄存器多宽,一次就并行多少路。台上四档正是x86二十年的宽度竞赛:标量32位1路、SSE(1999,Pentium III)128位4路float、AVX(2011,Sandy Bridge)256位8路、AVX-512 512位16路;ARM的NEON定在128位4路,Apple M系列后扩展至SVE2式可变向量。吞吐读数4×/8×/16×是理论上限,实际看三条折扣:访存带宽(16路乘加要喂数据,缓存供不上则空转)、对齐与聚集(gather指令跨步访存远慢于连续)、以及功耗降频(AVX-512重负载触发license-based降频,全核2.4GHz掉到2.1GHz,HPC圈著名的「AVX-512税」,Skylake-X时代实测让一些代码负优化)。适用边界:DLP只对「同一操作、不同数据」的规整循环生效——图像像素、矩阵乘、卷积天生合适;分支密集的标量逻辑一分钱加速都拿不到。这也是为什么SIMD是GPU的前身与同义词根:GPU本质上是「超宽SIMD+海量线程掩盖访存延迟」的极端形态。台上切宽度时读数跳的1×→16×,是编译器自动向量化(-O3 -march=native)与intrinsics手写能追到的同一道天花板。
Boss 战 · 一致性之乱
NoC的网格灯火齐灭。分裂的光影从所有总线裂缝中涌出,凝成一张巨大的、裂成两半的脸——两半彼此对望,像两个核心各持一份不同的真相。
一致性之乱
「我是一致性之乱。我不住在多核里——多核救不了我。我住在'共享内存是真的共享'这个谎言里。你每以为它们看的是同一个世界,我就胖了一圈。三问。答错一题,裂缝就宽一分。」
渊账累计 0 笔 · 三问全对后清零
详解 · K15-15 多核处理器的可测试性与调试
并发bug的凶残在于「不可复现」:竞态依赖两个线程抵达某条指令的微秒级时序,加一个printf就让时序错开——bug消失,这类「观察即改变」的缺陷叫heisenbug(海森bug,借量子力学的观测者效应命名)。三问桌上「排除法收网」的打法,正是并发调试的正规军战术:不再试图复现完整时间线,而是构造最小化对(两个线程+一个共享变量+一个交错),逐一排除不可能的机制。工具箱四层(H&P Ch4/工程实践):①动态检测——ThreadSanitizer(TSAN,Google出品)给每次读写盖向量时钟戳,发现「两个无同步的访问、至少一个是写」直接报race,S5那个丢失2618次的counter++在TSAN下第一秒就现形;Valgrind/helgrind同类。代价是5–15×减速与内存翻倍,CI里跑小用例、本地跑全量。②静态检查——Clang Thread Safety Analysis用注解(mutex锁住哪个变量)在编译期抓锁协议违规。③确定性回放——Mozilla rr记录执行流,崩溃后倒放、单步、反向断点,时序被锁死heisenbug变家养bug;仅限单线程录制(多核交错本质随机,只能靠调度约束模拟)。④硬件层——多核验证用形式化方法穷举一致性协议状态空间(Murphi/TLA+建模MESI类协议是教科书案例),硅后用Intel PT跟踪分支流。台上渊账一笔笔记录、三问清零,就是「先记账、后结账」的调试纪律——多核的世界里,没有重现键,只有证据链。
尾声 · 多核之悟
分裂体消散时法阵重新亮起。你搭的SMP法阵上的裂痕还在——MESI修补的痕迹像一枚枚补丁,铭刻着"一致性是抢回来的"。
诺依曼老祖
「你突破了。不是因为你答对了三问——答对的会忘。是因为你亲手搭过的每一座法阵、推过的每一条公式、修过的每一道裂痕,都刻在你手上了。但——你搭的这座多核法阵,到底有多快?能量化吗?」
知识图谱点亮 · 多核权衡
点亮全章15块碎片 → 看多核架构全景
复盘 · 多核共鸣主线:从功耗墙到裂缝上修桥
一条主线串起全部场景:功耗墙(S0:Dennard失效,频率停在3.5GHz)→ 多核起步(S1:SMP共享总线,UMA平等)→ 加速幻灭(S2:Amdahl天花板S=1/(s+(1-s)/N),s=0.1时64核只有8.77×)→ 一致性深渊(S3:私有缓存各持真相,副本撕裂)→ 协议修补(S4:MESI用BusRd/BusRdX一拍一拍抢回一致)→ 原子性再崩(S5:读-改-写不原子,counter++丢2618次;锁救竞态、锁竞争成新瓶颈)→ 裂土扩容(S6:NUMA远近2×/4×,数据在哪与怎么算同样重要)→ 脉络重建(S7:NoC四拓扑各有死穴,Mesh/Ring/Tree/Torus按流量选)→ 异构降维(S8:大小核治暗硅、SIMD以宽度换数量、Chiplet拼装降成本)→ 三问清账(S9:排除法收网)→ 图谱归一(S10:点亮15块碎片)。贯穿的三个顿悟:多核不是单核×N(Amdahl罚串行);一致性不是天生的(MESI每一拍都是事务);没有最优设计(每个架构选择都是trade-off——带宽vs扩展、延迟vs布线、性能vs功耗)。结丹四层圆满——但这座法阵到底有多快、快在哪里、慢在哪里,需要一把尺:下一章,度量之门。