度量之门
你以为跑分高就是快。但性能测量充满了陷阱——均值、加权、基准选择都可能误导。度量的陷阱不在数据里,在选择里。
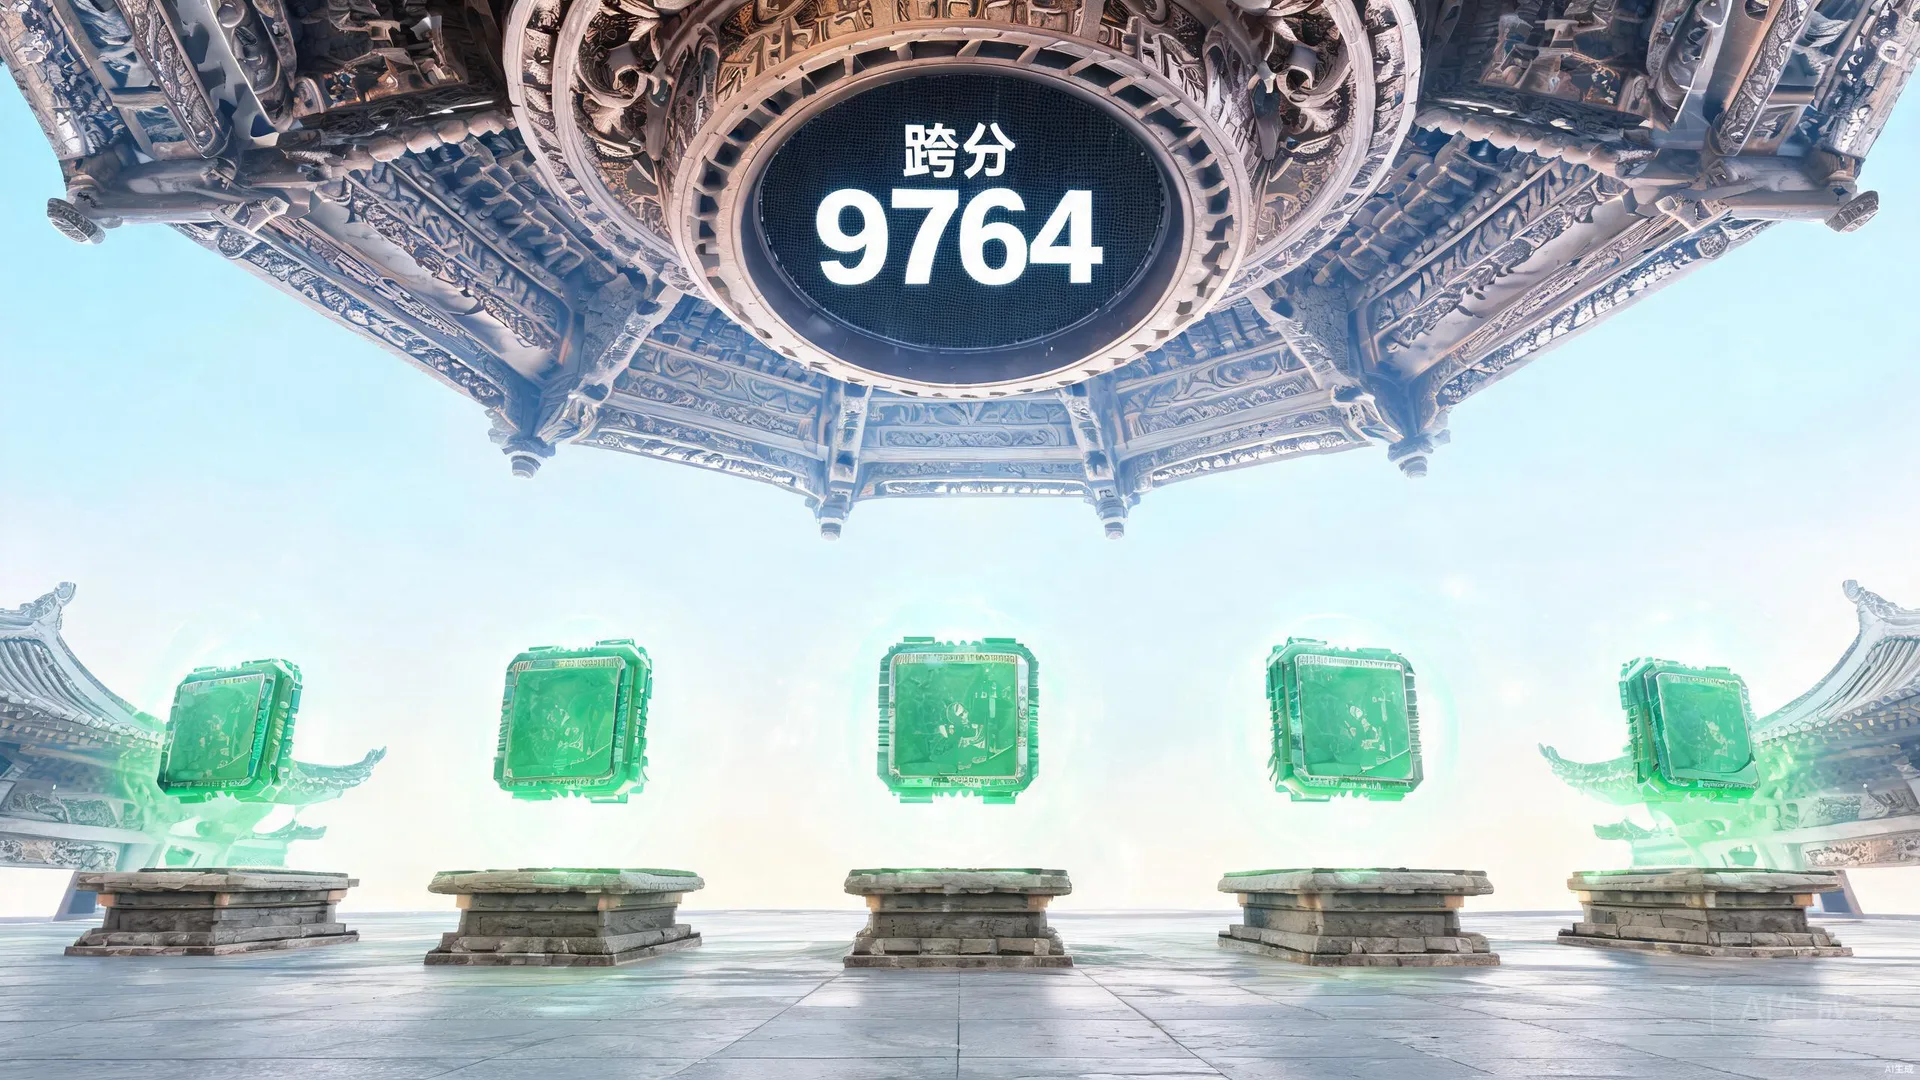
跑分神殿
神殿穹顶悬着一块巨大的数字盘,上面只有一个数字在跳动——跑分。数字盘下面排着五座石台,各浮着一块处理器晶核。
 诺依曼老祖
「你先挑。挑完再测。」
 测量之谬
「数字大的快。挑一个。你连那个数字量的是什么都没问,对吧?」
跑分神殿预测挑战器
单数下注(五选一)→ 石台翻转露真容 → 双轴重排(响应时间轴/吞吐量轴)
双轴重排 · 响应时间 vs 吞吐量
详解 · K16-01 性能度量的基本概念:响应时间vs吞吐量
「性能」不是一词一义:响应时间(延迟)=完成单个任务的总耗时(含CPU计算、I/O、OS开销、排队等待);吞吐量=单位时间完成的任务数。二者可以完全脱钩——台上吞吐第一的晶核·丙(9800 ops/s)单任务响应恰好垫底(200ms),而响应最快的丁(60ms)吞吐最低。教科书判据(Patterson & Hennessy, COD Ch1):换更快的处理器缩短响应时间;换更多处理器、加深流水线提高吞吐量——且多数提吞吐的手段(多道程序、批处理)反而让单个任务更慢。工程上的二维分野:交互系统看延迟(游戏帧间隔、交易尾延迟P99),数据中心看吞吐(QPS、TPS),超算的FLOPS名义是吞吐、实测是跑分程序的墙钟时间。排队论给两者牵线:Little定律 L=λ×W——平均在途任务数=到达率×平均响应时间,延迟恶化到临界,吞吐会被队列反噬。Trade-off无处不在:SMT超线程提吞吐但挤占单线程资源;GPU用上万线程换吞吐、单任务延迟毫秒级。你下注前没问的那句「这个数字量的是哪一个」,就是度量之门的第一课。
测速台 · MIPS之谎
石径尽头是一座悬空石台,台上立着三旋钮测速仪:左盘"指令数"、中盘"每指令周期数"、右盘"时钟周期"。
诺依曼老祖
「别看跑分了。自己算——一个程序跑完要多久,被几样东西决定?」
测量之谬
「MIPS嘛,百万指令每秒。数字大的快。这还用想?」
CPU性能公式三旋钮实验台
预测二选一 → 三旋钮控制变量实验 → 公式因子拖拽组装 → MIPS陷阱对比验证
公式组装 · 拖因子进等式槽
MIPS陷阱对比验证
详解 · K16-02 CPU性能公式的完整分析:CPU时间=IC×CPI×T_cycle
从第一性原理推(Patterson & Hennessy, COD Ch1,十大伟大思想里「加速大概率事件」的算术底座):CPU时间=指令数IC×每指令平均周期CPI×周期时间T_cycle=IC×CPI/f。CPI不是常数,是各类指令的加权平均:CPI=Σ(CPIᵢ×ICᵢ)/IC——同样标称CPI,指令混合不同,含义完全不同。三个因子对应三条优化路径:编译器/ISA降IC(RISC哲学:简单指令降CPI但增IC;x86相反——一条指令顶RISC三条,CPI更高)、微架构降CPI(乱序/超标量把IPC做到1以上,即CPI<1)、工艺与电路设计提频(缩短T_cycle)。台上默认组合IC=10⁹、CPI=3、T_cycle=0.333ns(3GHz)恰好=1.0s——这就是处理器A的账。关键洞见是三旋钮互相咬死:提频→流水线加深→分支预测失败惩罚翻倍→CPI上升(Pentium 4的31级流水教训);加宽发射→面积功耗涨(S7的PPA)。所以「改一个因子看时间」只是控制变量实验,真实设计是在三因子间挪账的零和游戏。量化的第一步永远是:把目标程序拆成这三个数。
详解 · K16-07 MIPS/MFLOPS指标的局限性
MIPS=百万指令每秒=IC/(CPU时间×10⁶)=f/(CPI×10⁶)——公式里根本没有IC的位置,这就是它撒谎的机制。台上实锤:A的MIPS=1000(IC=10⁹、CPI=3、3GHz),B的MIPS=600(IC=5×10⁸、CPI=5),但A要1.0s、B只要0.833s——MIPS高的慢了20%,因为A执行的指令数是B的两倍。三宗罪(COD Ch1):①ISA依赖——不同指令集的「一条指令」干的活不同,MIPS跨ISA不可比;②程序依赖——同一台机器跑不同程序MIPS相差一个数量级,厂商爱引「峰值MIPS」更是营销;③指令混合依赖——新增一条CPI极低的指令会让MIPS暴涨、程序变慢(执行了更多无用的快指令)。MFLOPS只在浮点密集程序里有意义,对整数程序是0。唯一安全用法:同一ISA、同一程序、同一编译器下比机器(此时MIPS与CPU时间严格成反比)。MFLOPS的当代变体「峰值TOPS」同病:稀疏INT8和稠密FP16的「一次运算」根本不是一回事。S0那个数字盘跳动的,就是这类单一数字。
加速殿 · Amdahl之墙
殿中央竖着一面巨大的石墙,墙面上刻着一行字:"串行部分决定一切。"墙前摆着并行加速器。
诺依曼老祖
「你ch15搭过多核。现在算算——加到100个核,能快多少?」
测量之谬
「100个核,100倍嘛。线性叠加,这不是明摆着吗?」
Amdahl-Gustafson加速曲线追踪器
双旋钮加速实验台(p×n)→ Amdahl公式分步推导 → Gustafson曲线对比翻转
Amdahl公式分步推导
Gustafson曲线对比
详解 · K16-03 Amdahl定律的推导与深入应用
Amdahl 1967年(AFIPS,为泼多核的冷水而写):把程序拆成串行(1-p)与并行p两部分,n核只加速后者,S=T_old/T_new=1/[(1-p)+p/n],n→∞时S_max=1/(1-p)——串行占比是天花板。台上代入:p=95%→天花板20×;n=100时S=1/(0.05+0.0095)=16.8×;n=1000也只19.6×——离20永远差一口气。反着用更狠:想要100×加速,串行必须≤1%;想要1000×,串行必须≤0.1%——这就是为什么超算代码要疯魔级消串行。深入三点(H&P Ch1「提升并行的感悟」):①串行部分≠只是没并行化的代码——锁、同步、通信、I/O、内存带宽墙全都算;②推广形式 S=1/[(1-f)+f/k]:任何子系统的优化收益都受其时间占比f约束(S5瓶颈分析的理论根基);③它同样惩罚「优化错对象」——把占1%的部分加速100倍,总体只快1.01×。Amdahl定律是性能世界的守恒律:收益永远按占比分配,直觉里的「线性叠加」是幻觉。
详解 · K16-04 Gustafson定律:规模缩放下的并行加速
Gustafson 1988(CACM「Reevaluating Amdahl's Law」)指出Amdahl的隐含假设不现实:任务规模固定。真实用户拿到更大的机器会放大问题——网格加密、数据集加倍。以「同样的时间做更多事」为口径(scaled speedup):S'=n−α(n−1),α为串行时间占比。台上代入:α=5%、n=100 → 95.05×,对比Amdahl同参数的16.8×——差5.7倍。本质:两条曲线不是谁对谁错,是同一组硬件在两种实验设计下的投影——Amdahl固定工作量测时间缩短,Gustafson固定时间测工作量放大(分子分母互换)。适用边界:科学模拟(网格随核加密)、训练(batch随卡变大)符合Gustafson;编译一个固定工程、处理固定流量的事务系统受Amdahl约束。历史注脚:Gustafson在1024核nCUBE上实测近线性加速,一举扭转「并行无望」的行业悲观——所以有人说这篇论文救了并行计算。台上双曲线的翻转点不在图上,在你手里:你的问题是固定的还是会长大的?这决定你看哪条曲线。
基准场 · 均值陷阱
场地中央排着六座基准石碑:SPECint、SPECfp、Dhrystone、Whetstone、STREAM、LMbench。
诺依曼老祖
「六块基准,两台机器A和B。A在有些基准上快、在有些上慢。你给个总评——谁更快?」
测量之谬
「取个平均不就行了?算术平均,小学就会。」
基准认识 · 算术/几何平均切换
点亮六座基准石碑 → 算术平均陷阱(两头骗)→ 几何平均互反一致性
六组A/B性能比
详解 · K16-05 基准测试程序(Benchmark):SPEC系列/Dhrystone/Whetstone
基准的三代进化:合成小程序(Dhrystone 1984 测整数、Whetstone 1972 测浮点——用几条典型语句代表一类操作,代码短到编译器厂商专门为它优化指令序列,跑分涨了、真实程序没快,最终被业界抛弃)→ 内核基准(Livermore Loops、LINPACK——取真实程序最热的循环段,LINPACK至今仍是TOP500超算排名标准)→ 真实程序集(SPEC:1989年首发10项,到SPEC 2017扩到43项,分SPECint整数/SPECfp浮点,含编译、AI推理、压缩、流体等真实负载)。台上六碑各测一维:SPECint/SPECfp测CPU时间(注意SPECspeed是单任务=响应时间、SPECrate多副本并发=吞吐量——S0双轴的回扣)、Dhrystone/Whetstone测合成整数/浮点速度、STREAM测内存带宽(GB/s)、LMbench测微操作延迟(syscall、cache延迟)。SPEC的机制:每项跑出墙钟时间÷参考机时间=SPECratio,再对各项比值取几何平均(S3下半场的伏笔)。跑分博弈从未停:编译器识别基准代码直接替换成常量(SPEC为此要求源码级审查)、厂商挑对自己有利的编译flag、移动端安兔兔造假——基准从来不是中立的尺子,是战场。选哪个基准,等于定义哪一种性能。
详解 · K16-06 性能报告方法:算术平均/几何平均/加权平均
平均方法的合法性取决于被平均的对象(Fleming & Wallace 1986 的经典论证):①对执行时间求平均——只有算术平均合法(总时间=各时间之和,平均时间短=快,无歧义);②对性能比求平均——只有几何平均满足互反一致性:换参照机结论自动翻转。台上实锤:六组A/B比 2,2,2,0.5,0.5,0.5,算术平均=(2×3+0.5×3)/6=1.25「A快25%」;换成B做参照(逐个取倒数 0.5,0.5,0.5,2,2,2),算术平均还是1.25「B快25%」——同一组数据两头骗。几何平均=(2³×0.5³)^(1/6)=1.0,翻转后=1/1.0=1.0,结论自洽——SPEC、Geekbench全用它。③加权平均——当工作负载有占比时:加权算术平均=Σ(wᵢ×tᵢ),权重=任务频率;「典型负载」的权重表本身就是厂商立场(A快在办公、B快在游戏,权重怎么定谁就赢)。加权几何平均=Π(tᵢ^wᵢ),同时兼容占比与比值。更深的坑:任何平均都抹掉分布——尾延迟被均值掩盖(回扣S0:交互系统要看P99不是平均值)。报告性能的完整姿势=工作负载+平均方法+分位数,三者缺一,那个数字就可以被任意定义。你选哪种平均,就是选哪种结论。
计数室 · 硬件之眼
石室四壁嵌满微型水晶窗,每扇窗后是一个硬件计数器——周期数、指令数、Cache缺失数、分支预测失败数。
诺依曼老祖
「合成基准是假的,跑分是别人选的。但处理器自己有眼睛——这些计数器,它每跑一个周期就数一笔,不会骗你。」
测量之谬
「好,你看见数据了。但数据告诉你发生了什么,不告诉你为什么。」
性能计数器 · CPI分解
点亮四类计数器水晶窗 → CPI分解(基础+L1+L2+分支+其他)→ 真实测量对比
CPI分解 · 光柱生长
真实测量 · S1处理器A/B的Cache表现
详解 · K16-08 性能计数器(Performance Counter)的原理与使用
计数器是微架构里埋的物理事件累计器:每个CPU核心几十个固定+可编程计数器(Cycle、Instruction、L1-dcache缺失、branch-misses…),OS通过MSR指定监听哪个事件,溢出触发中断。Linux下一行 perf stat ./a.out 即可读出IPC、cache缺失率、分支失败率——台上四扇窗(Cycle=3×10⁹、IC=10⁹、L1缺失2×10⁷、分支失败5×10⁶)就是它读的。价值在于把CPI从黑箱拆成事件账本:CPI=Σ(事件率×惩罚拍)——台上分解:基础2.00 + L1缺失2%×15拍=0.30 + L2缺失0.1%×150拍=0.15 + 分支失败0.5%×30拍=0.15 + 其他0.40 = 3.00闭合,哪根柱最长,优化靶就在哪。三个工程注意:①计数器有开销——监听事件多到计数器不够用时硬件分时复用(multiplexing),结果需按占空比放大;②采样有skid——用PEBS(Intel)/IBS(AMD)精确采样而非固定间隔中断,否则热点会漂移到相邻指令;③Top-Down分析(Intel TMAM)把每个周期归因为retiring/bad-speculation/frontend/backend四桶,比裸CPI更快定位微架构层次。回扣S1:B的CPI=5.0却更快(0.833s vs 1.0s)——计数器解释「为什么」,不裁决「谁快」;裁决要回到CPU时间=IC×CPI×T_cycle这本唯一真账。
瓶颈渊 · 阿喀琉斯之踵
渊底悬着一张巨大的系统剖面图,渊壁上嵌着CPUlator——一台架构模拟器,能量化"改了某个参数后性能变多少"。
诺依曼老祖
「计数器告诉你每层花了多少时间。但哪层是瓶颈?不是最亮的那层——是最该优化的那层。」
瓶颈渊CPUlator三旋钮实验台
三旋钮(优化目标/优化倍数/场景)→ 实时加速比 → 瓶颈迁移 → Amdahl回扣
Amdahl回扣
详解 · K16-09 瓶颈分析方法:识别系统性能瓶颈
瓶颈=拖住整个系统的那个部件,判据只有Amdahl定律的推广式 S=1/[(1-f)+f/k]——收益被该部件的时间占比f封顶。台上同一刀(优化内存子系统2×)打在不同负载上:场景A(计算85%/内存15%)S=1/(0.85+0.075)≈1.08×;场景B(内存70%)S=1/(0.3+0.35)≈1.54×——瓶颈跟着负载走,优化前必须先问「什么负载」。测量驱动的闭环方法论:①Profile(S4计数器/采样热点,找时间大头在哪层)→②假设(大头是cache缺失?分支失败?锁竞争?)→③量化预期(用Amdahl算上限——上限只有1.1×的优化不值得做)→④实施优化→⑤再Profile验证(没验证的优化是玄学,优化后瓶颈必然迁移——内存修好了下一个瓶颈可能是计算)。系统级可用USE方法(Brendan Gregg):对每个资源检查Utilization(利用率)/Saturation(饱和度,排队长度)/Errors(错误计数)。三个反直觉:①最热的代码≠最该优化的代码(占比才是,热度还要乘上可优化空间);②CPU利用率100%≠饱和(可能在自旋等锁——忙不等于干活);③并行系统的瓶颈常在通信而非计算(回扣S2串行占比)。找到瓶颈只是第一步——它在七层栈的哪一层,决定你去哪层动刀(S8)。
详解 · K16-10 CPUlator方法:量化评估架构变更的影响
CPUlator思路=在动刀之前做what-if:把「改了X会快多少」变成受控实验。CPUlator本是教学界广泛使用的浏览器级计算机系统模拟器(可跑Nios II/ARM/RISC-V,逐指令可见寄存器与内存),台上取其骨架做成三旋钮实验台:优化目标×优化倍数n×负载场景,配一条恒等式 T_new=T_cpu/n+T_mem(T_old=100s)——拖一下旋钮立刻看到加速比,不用写一行RTL。它示范的是量化评估的三件事:①控制变量——一次只动一个因子(回扣S1三旋钮的控制变量实验法);②解析建模——T_new公式就是一阶分析模型,秒级出结果但精度粗(只对线性分解的系统成立);③敏感性扫描——n从2拉到5、两个场景都跑,看加速比对哪个参数最敏感(sensitivity analysis)。工程对应物:微架构决策用gem5模拟「发射宽度+1值不值」(精确但慢),流片前用FPGA原型验证RTL(快但近似),算法层直接用基准测试harness。三条边界:①模拟的价值上限=瓶颈建模质量——S5的85/15分法本身就是假设,占比f必须来自真实profile(S4),否则是垃圾进垃圾出;②模拟代价随精度指数增长(回扣S8三镜光谱);③模拟≠实测——环境噪声、编译器差异让±10%预测误差成为常态,结论要留置信区间。量化评估不是取代直觉,是给直觉套上数字的缰绳。
能效塔 · 功耗之墙
能效塔中央是一根频率柱,从1GHz标到6GHz。柱旁一面功耗仪表盘,刻度从10W到300W。
诺依曼老祖
「你一路优化瓶颈、提升频率。但频率不是免费的——每一次提速,都在买热量。」
测量之谬
「拉满它。更快就是更好。热?加风扇不就行了?」
频率-功耗实验 · EDP拐点
拖频率旋钮(1-6GHz)→ 功耗暴涨(静态线性+动态立方)→ 找EDP拐点 → TOPS/W对比
TOPS/W 能效对比
详解 · K16-11 功耗与能效指标:能量延迟积(EDP)/TOPS/W
两族指标回答不同的问题。功耗族:动态P_dyn=α·C·V²·f(开关活动率α×电容×电压平方×频率);静态P_static=V·I_leak(漏电流,先进工艺下占比越来越大——台上功耗模型的480f/17线性项就是它,30f³/17是动态项);总能量E=∫P·dt(焦耳)。能效族三把尺:①TOPS/W=每瓦每秒运算数——「单位能量干了多少活」,移动/边缘场景第一指标(台上对比:桌面CPU约5、移动SoC约15、AI加速器可达200——差40倍,靠专用数据通路砍α和C,回扣S7的取舍);②能量延迟积EDP=P×T²(即E×T)——同时惩罚耗能与拖沓:纯降频省能量但T暴涨、EDP恶化,纯提频快但P暴涨、EDP也恶化,所以存在拐点(台上:EDP=(480/f+30f)/17,求导零点f²=480/30=16即f=4GHz触底≈14.1,1GHz时=30、6GHz时≈15.3——拐点左边频太低浪费时间,右边频太高烧能量);③ED²P偏向性能(服务器在乎延迟)、E或E³延迟容忍(批处理可慢)——指数本身就是价值立场。方法论:先定场景(交互/吞吐/电池供电),再选指标(延迟/吞吐/TOPS/W/EDP)——指标选错,优化方向全错,这正是「度量即选择」在能效维度的重演。
详解 · K16-12 功耗墙与频率扩展的极限
2004年前的行业惯性「每代工艺频率免费翻倍」来自Dennard缩放(1974):晶体管尺寸缩小k倍→电压降k倍、频率升k倍、电容降k倍,于是单位面积功耗≈不变——频率白送。2005年前后漏电流打破恒等式:阈值电压不能再降(漏电爆炸),电压停在约1V,频率继续升→P_dyn=CV²f中V不再同比例下降,功耗原地起飞(回扣S6模型:1GHz→30W、4GHz→226W、5GHz≈362W——300W仪表盘直接打爆)。芯片功耗密度冲到100W/cm²——火箭喷嘴量级,风冷极限就在附近。三个历史后果:①2005年Pentium 4的3.8GHz成了单核频率绝唱,行业整体转向多核——把提频的功耗预算换成并行(这正是ch15多核故事的起点);②功耗墙催生一整套省电技术:DVFS动态调频调压、race-to-idle(快跑完快睡觉,对泄漏占优的工艺反而省电)、电源门控/时钟门控(砍静态项——台上模型的480f线性项的克星)、大小核异构;③暗硅(dark silicon)——晶体管密度还在涨、功耗预算不涨,面积做得起、功耗开不起,一部分晶体管必须永远黑着。方法论教训:当一条优化路径撞上物理极限,换坐标而不是硬撞——频率的路堵死,还有PPA三角(S7)和七层栈(S8)两条路。
三角阵 · PPA之衡
三角阵中央悬着一个等边三角形,三个顶点各亮着一盏灯:性能(P)、功耗(P)、面积(A)。
诺依曼老祖
「你撞了功耗墙。但你不是只有频率一条路。面积、功耗、性能——三样东西,你只能选两个。」
PPA三角权衡 · 三场景投放
拖三角顶点感受拉扯 → 三场景芯片投放 → 机会成本标记
三场景芯片投放
详解 · K16-13 面积-性能-功耗三角权衡
芯片设计是三元约束下的取舍问题,没有三点同时最优:性能P(频率×IPC——回扣S1的两个因子)、功耗P(S6的墙)、面积A(die的mm²)。面积的三重身份:①制造成本——wafer上die数∝1/面积,且良率随面积指数下降(die越大越容易踩中缺陷),先进工艺一套掩模NRE数千万美元,摊在销量上——小众芯片用不起尖端工艺;②性能的燃料——更多执行单元、更大cache、更深乱序窗口全都吃面积,提IPC的微架构几乎都是拿面积换(回扣S1「加宽发射→面积功耗涨」);③功耗的载体——晶体管越多开关电容C越大,P_dyn∝C×面积。台上三场景就是三角上的三个点:桌面CPU追性能、放弃功耗与面积(8核高频+独显350W)、移动SoC追功耗、放弃性能峰值(大小核+数瓦预算)、AI加速器追能效、放弃通用性(TPU砍控制逻辑换MAC阵列,回扣ai门)。工具化表达:设计空间是(P,P,A)三维的帕累托前沿——前沿上任何一点都无法在不牺牲某项的前提下改进另一项;工程=按场景在前沿上选点,评估一个设计必须报三坐标——只报一个的都是营销(回扣S0的跑分盘)。专业化是隐藏的第四维:放弃通用性本身可以是解——domain-specific architecture是后摩尔时代的主要出路。H&P的判词:体系结构是量化的科学,也是约束的艺术。
方法阁 · 系统之道
阁中悬着一张七层栈图,阁壁上排着三面镜子:模拟、仿真、分析模型。
诺依曼老祖
「你一路从MIPS走到功耗墙,每一步都是被陷阱逼着学的。现在——把它们装进一个框架。」
七层优化栈 · 三镜评估
逐层点击七层栈 → 三镜精度-速度对比 → 优化第一原则
三镜评估对比
详解 · K16-14 性能优化的系统方法论:从应用到器件
七层栈自上而下(台上栈图):应用层(换算法O(n²)→O(nlogn)可上百倍,代价是重构代码)→算法层(消冗余计算、加缓存查表,代价是可读性与内存)→OS/运行时层(调度亲和性、内存池、批处理系统调用,代价是侵入系统)→ISA层(新增SIMD/专用指令,代价是软硬件协同生态)→微架构层(乱序执行、分支预测、预取,代价是面积功耗——回扣S1/S7)→电路层(电源门控、时钟门控、多电压域,代价是设计复杂度)→器件层(新工艺、3D堆叠,代价是几十亿美元建厂)。第一原则(H&P):在最高的可行层级解决问题——越高层级杠杆越大:应用层改一行代码=器件层建一座Fab。台上mismatch实验的实锤:用7nm工艺提升约2× vs 把算法改成O(nlogn)提升约100×——先点器件层后点应用层,大炮打蚊子说的就是反向操作。完整闭环=①Profile定位瓶颈(S4)→②Amdahl算收益上限(S2/S5)→③选层(越高越好)→④量化评估what-if(S5 CPUlator/S8三镜)→⑤PPA核算代价(S7)→⑥实测验证(回S4)。这个闭环正是「量化研究方法」的工程化:没有度量的优化是猜测,没有层级的优化是蛮干——散碎的教训串成流水线,就是方法阁的匾额。
详解 · K16-15 体系结构评估方法:模拟/仿真/分析模型
三面镜子按「速度×精度」排成光谱(台上spectrum-bar):①分析模型(Roofline、排队论、一阶公式)——纸笔级速度,只给上界/数量级,价值在秒级扫设计空间、逼你写清假设(S5的T_new=T_cpu/n+T_mem就是);②模拟器(gem5、CPUlator)——逐指令/逐周期推进,能数到每一次cache缺失,代价是慢:模拟1秒真实负载可能要跑几小时——拿精度换时间;③仿真(FPGA原型/Palladium级emulation)——把RTL映射到FPGA接近真实时钟跑,比模拟器快1~3个数量级但近似(时序约束、内存模型偏差)。选择逻辑:概念探索用分析模型(零成本否决烂点子)→微架构决策用模拟器(扫描参数空间找最优)→流片前验证用FPGA(跑真实软件栈)。三条铁律:①模型可信度=校准数据质量——gem5跑SPEC前先拿真实CPU对表,校准误差小于5%才可用;②必须报出假设边界——「本结论假设L1命中15拍、L2命中150拍」;③评估目的决定工具精度——找趋势用粗模型跑遍空间,选架构用精确模型定点深挖。最大的坑是garbage in garbage out:负载不真实,模拟再精确也是精确的错误。工业实践是三镜组合:Roofline先划不可能区(S10屋脊),模拟器在可能区内找最优,FPGA最后验收。
Boss 战 · 测量之谬
方法阁灯火齐灭。谬雾从四面八方压过来,凝成一张巨大的、没有五官的脸——脸上戴着你在S0戴上的那块跑分面具。
测量之谬
「我是测量之谬。我不住在你的无知里——数据是死的,救不了我。我住在你'以为数据自己会说话'的地方。你每选一个基准、每选一种平均、每选一个指标,你以为你在'测量'性能——不,你在'定义'性能。而定义权,是我的。」
渊账累计 0 笔 · 三问全对后清零
尾声 · 度量之门
谬雾散尽时你手里多了一张Roofline图——不是它变了,是你变了。图上两个屋顶清晰可见,像两条地平线。
诺依曼老祖
「你结丹五层圆满了。不是因为你答对了三问——答对的会忘。是因为你摔过的每一道度量陷阱,都刻在你眼睛上了。但——你能量化处理器有多快了。可你知道,是谁在把你的程序变成处理器的指令?是谁在分配内存、调度任务、管理那些性能计数器?」
知识图谱点亮 · 度量之悟
点亮全章16块碎片 → Roofline剪影定格 → 境界突破
详解 · K16-16 Roofline模型:算术强度与带宽/算力屋顶
Williams et al. 2009(伯克利,H&P Ch4/Ch7):一张图两个维度——横轴算术强度AI=FLOPs/Byte(每字节内存交换承载多少次运算),纵轴可达性能,双对数坐标。核心公式一行:可达性能=min(峰值算力,带宽×AI)——两道天花板谁低卡谁:①带宽屋顶(斜线,斜率=内存带宽):AI小于屋脊点时性能∝AI,搬数据是瓶颈(memory-bound)——最典型的实锤是朴素矩阵乘:运算/访存比低,几十TFLOPs的GPU只跑出峰值的个位数百分比;②算力屋顶(水平线):AI超过屋脊点后撞顶,运算单元饱和(compute-bound)。屋脊点=峰值算力÷带宽,位置由硬件决定(台上剪影:水平线+斜线+金点)。优化方向看落点:在斜线段就提高AI——分块(blocking/tiling)让数据在cache里复用、寄存器化、减少冗余访存(回扣ch11局部性原理);在水平段就压榨算力——SIMD宽度、指令混合、循环展开(回扣S1的CPI/IPC)。三大用途:①诊断——一张图定位「卡在带宽还是算力」(S9第三问的破局);②预算——屋顶给出优化上界(Amdahl的图化);③沟通——硬件组与算法组看同一张图对齐。局限与延伸:多级存储是层叠屋顶(L1/L2/DRAM三道斜率)、乱序/预取让实测点低于屋顶(需加天花板修正)、还有功耗版屋顶(Attainable/Watt,回扣S6能效)。S10匾额的深意:一张图两个维度,没有综合分数——因为综合分数本身就是陷阱(回扣S0)。
复盘 · 度量之门主线:从跑分神殿到屋脊双影
一条主线串起全章:跑分神殿(S0:下注前没问「量的是哪个」——丙吞吐第一、单任务响应垫底,响应与吞吐脱钩)→ 测速台(S1:CPU时间=IC×CPI×T_cycle;MIPS=f/(CPI×10⁶)藏了IC——A的1000 MIPS反而比B的600慢20%)→ 加速殿(S2:Amdahl S=1/[(1-p)+p/n],95%可并行天花板20×;Gustafson S'=n-α(n-1)同参数95×——固定的还是会长大的)→ 基准场(S3:六组比2,2,2,0.5,0.5,0.5,算术平均1.25两头骗,几何平均1.0自洽)→ 计数室(S4:四计数器直读,CPI分解2.00+0.30+0.15+0.15+0.40=3.00闭合——B的CPI=5却更快,因为IC只有一半)→ 瓶颈渊(S5:CPUlator三旋钮,p=85%优化2×得1.74×、p=70%只1.54×——瓶颈由占比决定)→ 能效塔(S6:P=(480f+30f³)/17,EDP=(480/f+30f)/17在4GHz触底,5GHz≈362W热熔)→ 三角阵(S7:桌面追性能、移动追功耗、加速器追能效——三点都是帕累托取舍点)→ 方法阁(S8:七层栈「在最高可行层级解决」+三镜速度精度光谱)→ 三问清账(S9:MIPS陷阱、Amdahl天花板、Roofline破局)→ 图谱归一(S10:16块碎片点亮,屋脊双影定格)。贯穿全章的三个顿悟:①性能不是一词一义——响应/吞吐、时间/比率、均值/尾延,先问量的是什么;②一切单一数字皆可疑——MIPS藏IC、算术平均两头骗、跑分藏负载、峰值TOPS藏稀疏;③度量即选择——你选基准、选平均、选指标的那一刻,不是在测量性能,而是在定义性能。结丹五层圆满——处理器你能量了,但程序怎么变成指令、内存怎么分、任务怎么调?下一章,资源御灵。